Amazon Web Services ブログ
HR Open Standardsを活用したHRデータ統合のためのオントロジー設計
はじめに
本記事は、HR データ統合基盤を題材に、共通オントロジーの設計の考え方と、取込・質問応答・推論への使い方、それを AWS 上で組む際の構成を解説します。
RAG(Retrieval-Augmented Generation)は、検索で取得した社内データなどを LLM に渡して回答を生成する構成です。ドキュメントをベクトル化し、意味の近い断片を取得して LLM に回答させる方式は、FAQ や社内ナレッジ検索では十分に機能します。
一方で、HR ドメインではうまくいかない場面が出てきます。たとえば次のような質問です。
「田中さんの現在の所属部署は?」
「このグループ会社の子会社・孫会社を全部挙げると?」
「先月、残業が月45時間を超えた従業員は誰と誰?」
「今空いているポジションは?」
「2024年4月時点で、営業部の親部署はどこだった?」
これらはいずれもベクトル類似検索が苦手とする質問です。
| 質問 | 必要な処理 |
| 子会社を全部挙げる | 親子関係を何階層もたどり、該当する会社を列挙する |
| 空いているポジションを探す | そのポジションに誰も割り当てられていないことを確認する |
| 残業が45時間を超えた人を探す | 時間や件数を正確に集計し、条件に合う従業員を抽出する |
| 2024年4月時点の状態を調べる | 過去の指定日時点で有効だった関係を調べる |
意味の近い文章を拾う仕組みでは、これらに「たぶん合っている」レベルでしか答えられません。HR では、回答の誤りが労務コンプライアンス違反や人事意思決定のミスにつながります。「田中さんの残業は45時間を超えていません」という回答が誤っていれば、36協定違反の見逃しになりかねません。そのため、HR の RAG には、出典と鮮度つきの正確な答えが必要です。
さらに、これらの質問に答えるデータは、1か所にまとまっていない場合が多いです。勤怠・給与・タレントマネジメント・採用管理・人事マスタは別々のシステムとして導入され、M&A やグループ再編でさらに増え、同じ「人」がシステムごとに違う ID・違う名前で分断されています。「グループ全体のスキルギャップは?」のような部門横断の問いは、都度 CSV などにデータを出力し、突き合わせる作業になりがちです。これを解くのが MDM(マスタデータ管理)で、散らばったソースを共通の「人・組織・ポジション」に名寄せし、1つのグローバル ID に束ねます。その場合の最大の難所が、システムごとにバラバラな項目・名前・構造をどうやって同じ意味に揃えるか、です。
本記事で紹介する設計は、複数ソースの統合と、統合したグラフ上での正確な質問応答という2つの課題を、オントロジーを使ったデータ統合と質問応答で解きます。業界標準の語彙をオントロジーとして定義し、取込(名寄せ・統合)と検索(質問応答)の両方で共通の基準にします。LLM には意図の解釈を任せ、答えのデータは決定論的なグラフクエリで取得します。
全体像
先に全体の構成を示します。登場するのは 2 本のパイプラインと、その両方が参照するオントロジーです。
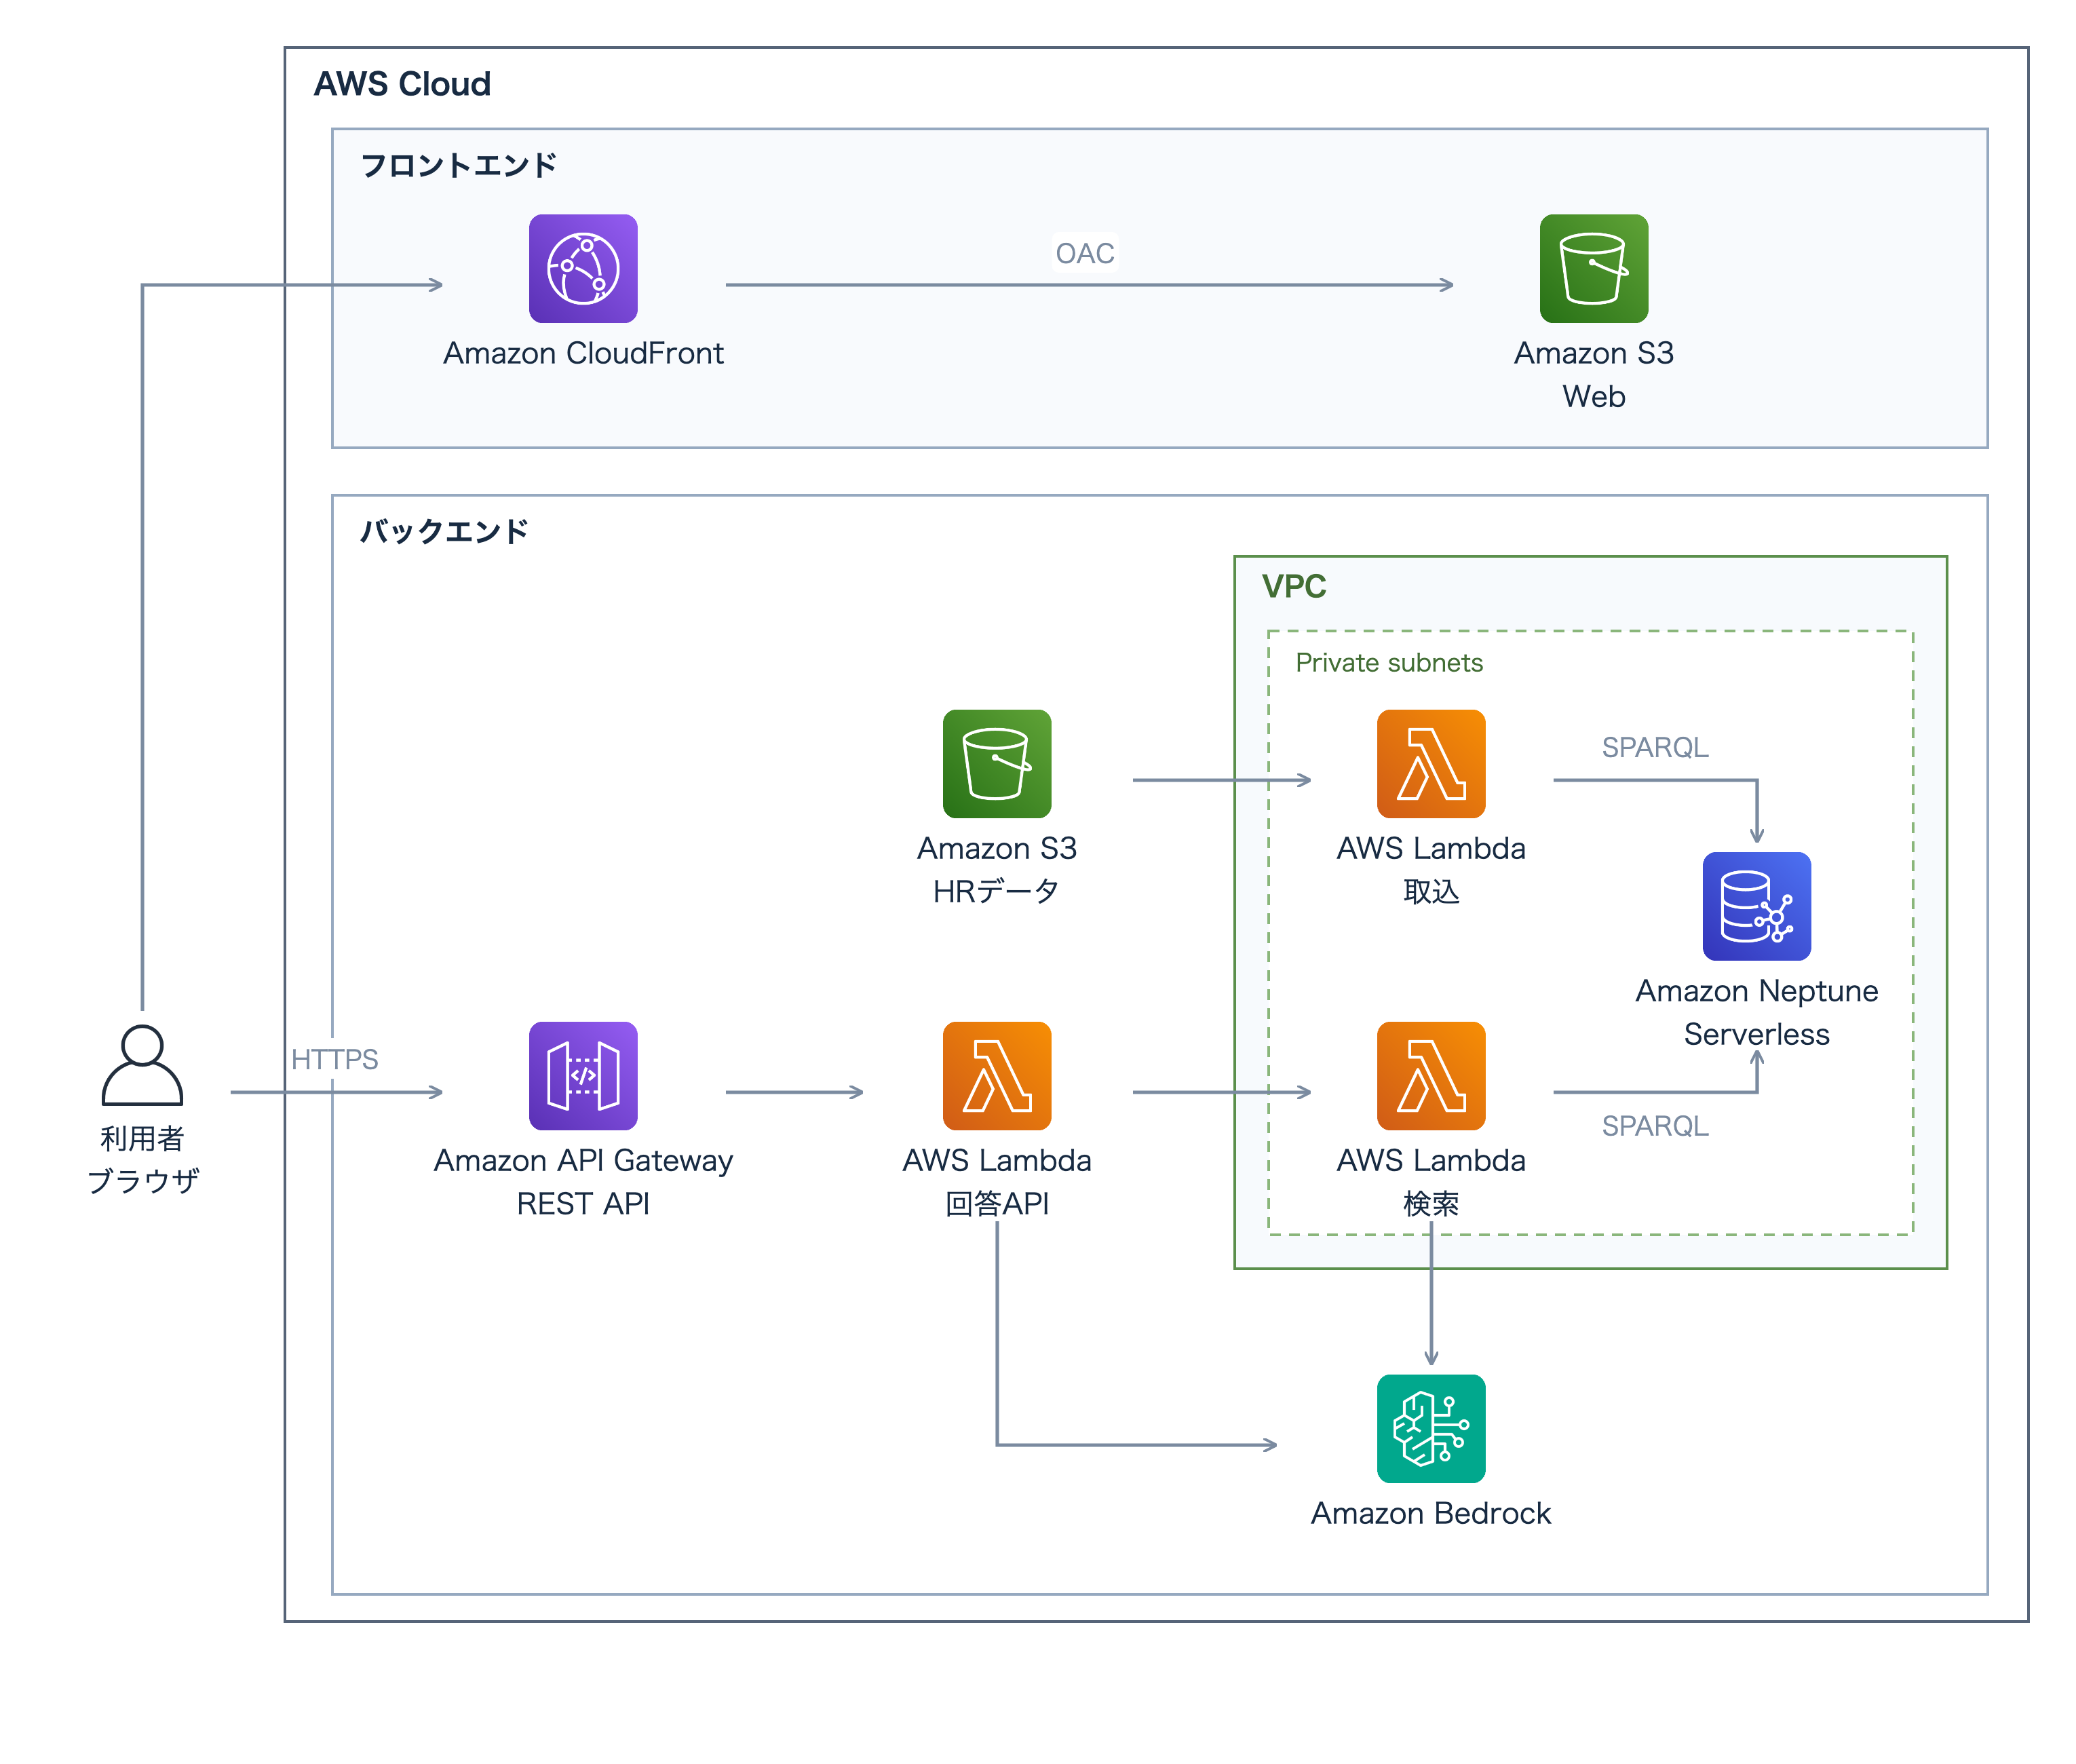
図1:フロントエンドとバックエンドを分離したAWS構成案。 オントロジーは Lambda Layer で取込・検索の両方に配布します。
取込パイプライン(バッチ) は、Amazon S3 に置かれた人事マスタの JSON を AWS Lambda が読み、オントロジーの写像ルールに従って RDF に変換します。ログイン ID で名寄せして不変のグローバル ID を発番し、元データを Amazon Neptune Serverless に SPARQL UPDATE で書き込みます。続いて推論・派生結果を追加し、元データの制約検証を実行します。検出結果はログと取込処理の戻り値に記録します。
質問応答パイプライン は、CloudFront と非公開の S3 で配信するチャット UI が質問を受け、API Gateway の REST API を通じて回答 API の Lambda を呼び出します。回答 API は VPC 内の検索 Lambda を呼び、検索 Lambda が「意図分類 → テンプレート SPARQL → Neptune で実行 → 出典回収」を行います。回答 API は検索結果を受け取り、Amazon Bedrock で回答文に整形して、ストリーミングで返す構成です。
| 層 | サービス | 役割 |
|---|---|---|
| 共通オントロジー | Lambda Layer | OWL 語彙(HR Open Standards 4.5 に基づく)・写像 JSON・LLM 向け要約。両方の Lambda に同梱する |
| データ置場 | Amazon S3 | 人事マスタの JSON をソースごとの形式のまま置く |
| 取込 | AWS Lambda | 写像で RDF 化・名寄せ → 元データを Neptune へ書き込み → 推論・派生結果を追加 → 元データの制約検証・結果記録 |
| グラフ DB | Amazon Neptune Serverless | RDF / SPARQL 1.1。レコード単位の名前付きグラフに事実を置き、出典・鮮度を付与する |
| 検索 | AWS Lambda(VPC 内) | 意図分類 → テンプレート SPARQL → 実行 → 出典回収 |
| LLM | Amazon Bedrock | Claude Haiku が意図分類、Claude Sonnet が回答整形を担当 |
| フロントエンド | Amazon CloudFront・Amazon S3 | チャット UI の静的ファイルを配信する。非公開の S3 へ CloudFront からアクセスする |
| 回答 API | Amazon API Gateway・AWS Lambda | 検索 Lambda の呼出し、Bedrock による回答整形、ストリーミング配信を担当する |
出典と鮮度はどこから来るか
回答に使ったデータについて、「どのシステムから、いつ取得したものか」を確認できるようにします。
例えば、人事システムAから取得した田中さんの配属データを、その出典・取得時刻・確度と対応付けて保存します。この対応を管理するため、ソースごとの各レコードを、名前を付けたデータのまとまりである「名前付きグラフ」に格納します。
検索時には、回答に使うデータがどのまとまりに属するかを調べ、対応する出典と取得時刻も取り出します。
なぜ HR データにオントロジーが必要か
オントロジーは、HR の文脈では次のように捉えると分かりやすくなります。
オントロジーとは、その分野に登場する概念と、概念同士の関係を、人と機械が同じ意味で扱える形で定義したものです。
HR で言えば、「従業員とは何か」「所属とは何か」「ポジションと人はどういう関係にあるのか」を、誰が読んでも同じ意味に取れるよう明文化したものです。用語集(言葉の定義を並べたもの)との違いは、関係やルールまで機械が処理できる形で定義する点にあります。「A は B の子会社」「この人は 2023年4月からこの部署に所属」といった関係を、コンピュータがたどれる形で持たせます。
意味の定義をテーブル設計から独立させる理由
あるプロダクトでは「社員」、別のプロダクトでは「従業員」、勤怠システムでは「要員」。同じ人を指す言葉が、システムごとに違う名前・違う列・違う型で管理されています。テーブル設計は各システムの都合で最適化されるので、統合しようとすると「どの列とどの列が同じ意味なのか」を人間が都度すり合わせることになります。
オントロジーは、この「意味の層」をデータベースのスキーマから独立させます。各ソースのバラバラな項目を共通の意味へ写像する土台になります。これは、複数ソースを共通のドメインモデルへ対応づける工程にあたります。
なぜ RAG でオントロジーが効くのか
ベクトル RAG は言葉が似ている文章を拾う仕組みなので、「田中さんの上司の、そのまた上司の部門は?」のような関係をたどる質問や、「今この瞬間ではなく去年4月時点の所属」のような文脈の厳密さには、意味の定義がなければ答えられません。
オントロジーは、関係・時間・ルールを機械が処理できる形で定義します。その定義に沿って関係や時点をたどることが、正確な回答につながります。本記事の設計が HR Open Standards をオントロジーの土台に据えたのは、この理由からです。
用語ミニ解説
| 用語 | 意味 |
|---|---|
| クラス / インスタンス | 「従業員」という種類がクラス、「田中さん」という具体的な1人がインスタンス |
| プロパティ | 「所属する」「上司である」など、対象同士を結ぶ関係 |
| RDF | データを「主語・述語・目的語」の3つ組(トリプル)で表すデータモデル。グラフ構造になる |
| OWL | RDF の上で、クラスの定義や関係の性質(推移的など)を記述する言語。本記事では、OWL 2 RL/RDF ルールに基づく推論を、Python ライブラリ owlrl で実行します。参考:OWL 2 Profiles、owlrl |
| SPARQL | RDF グラフに対する問い合わせ言語 |
| 推移的な関係 | 「AからB、BからC」という関係から「AからC」も成り立つ関係。会社の階層をたどる場合などに使う |
HR Open Standards を使った共通オントロジーの設計
なぜ独自スキーマでなく業界標準か
本記事の設計では、語彙をゼロから設計せず、HR Open Standards 4.5 という国際的な HR データ標準に準拠させています。HR Open Standards は、HR Open Standards Consortium という非営利団体が策定・公開している、HR データ交換のための標準です。採用・給与・勤怠・組織・人物・スキルといった HR ドメインの概念を「型」として定義し、JSON / XML スキーマの形で配布しています。
今回のオントロジーが使う主な型は、次のようなものです。
| 型 | 表すもの | 主な項目 |
|---|---|---|
| Person(人物) | 個人そのもの | 氏名、生年月日、連絡先、不変のグローバルID |
| Worker(従業員) | 「組織で働く」というロール | 社員番号、入社日、等級。氏名などは Person を参照 |
| Organization(組織) | 会社・部門 | 組織名、種別(会社/部門)、親組織 |
| Position(ポジション) | 職務・席 | 役職名、充足状況。人とは独立 |
| WorkAssignment(配属) | 人と組織・ポジションの結びつき | 開始日・終了日、配属先組織、ポジション |
| Skill / Certification | スキル・資格 | スキル名、資格名(保有は熟練度つきで別途表現) |
型の作法にも特徴があります。たとえば識別子は単なる文字列ではなく「値(value)と採番体系(schemeId)の組」で持ちます。社員番号もグローバルIDも同じ形で表せるので、ソースごとに違う ID 体系を一様に扱えます。こうした型と作法が標準として決まっているため、各社が独自に持つ「社員」「組織」を標準の型に写像するだけで、システム間で意味を揃えられます。
標準を使う狙いは、複数プロダクト・複数ソースで異なる項目を、共通の語彙に対応付けることです。ソースごとにばらばらな「社員」「従業員」「要員」を、標準が定める「従業員」という1つの型に写像すれば、統合後は同じ語彙で扱えます。自前でモデルを作るより、多くの企業で検討・改訂されてきた語彙を使うほうが、抜け漏れの確認や他システムとの相互運用性の面で有利です。
業務要件をクラス設計に反映する
オントロジーを実課題に結びつけるうえで大事なのは、業務要件がそのままクラス設計として表れる点です。HR Open のモデルには、次のような設計が織り込まれています。
従業員(ロール)と人物を分離する:氏名や生年月日は「人物」が持ち、雇用に関する属性は「従業員」が持つ。これにより「従業員番号は転籍で変わっても、人物としての同一性は不変」を表現できます。人物には不変のグローバル ID を与え、従業員番号とは別に扱います。
配属が開始日・終了日を持つ:所属を「今の状態」ではなく「いつからいつまでの配属」として持つことで、異動履歴も、過去のある時点の組織断面も再構成できます。
ポジションを人と独立させる:ポジションを人から切り離すことで、「誰も割り当たっていないポジション=空席」を表現できます。
「田中さん」という1人の従業員を例に、人物・従業員・配属・組織・ポジションの関係をグラフ図で示します。
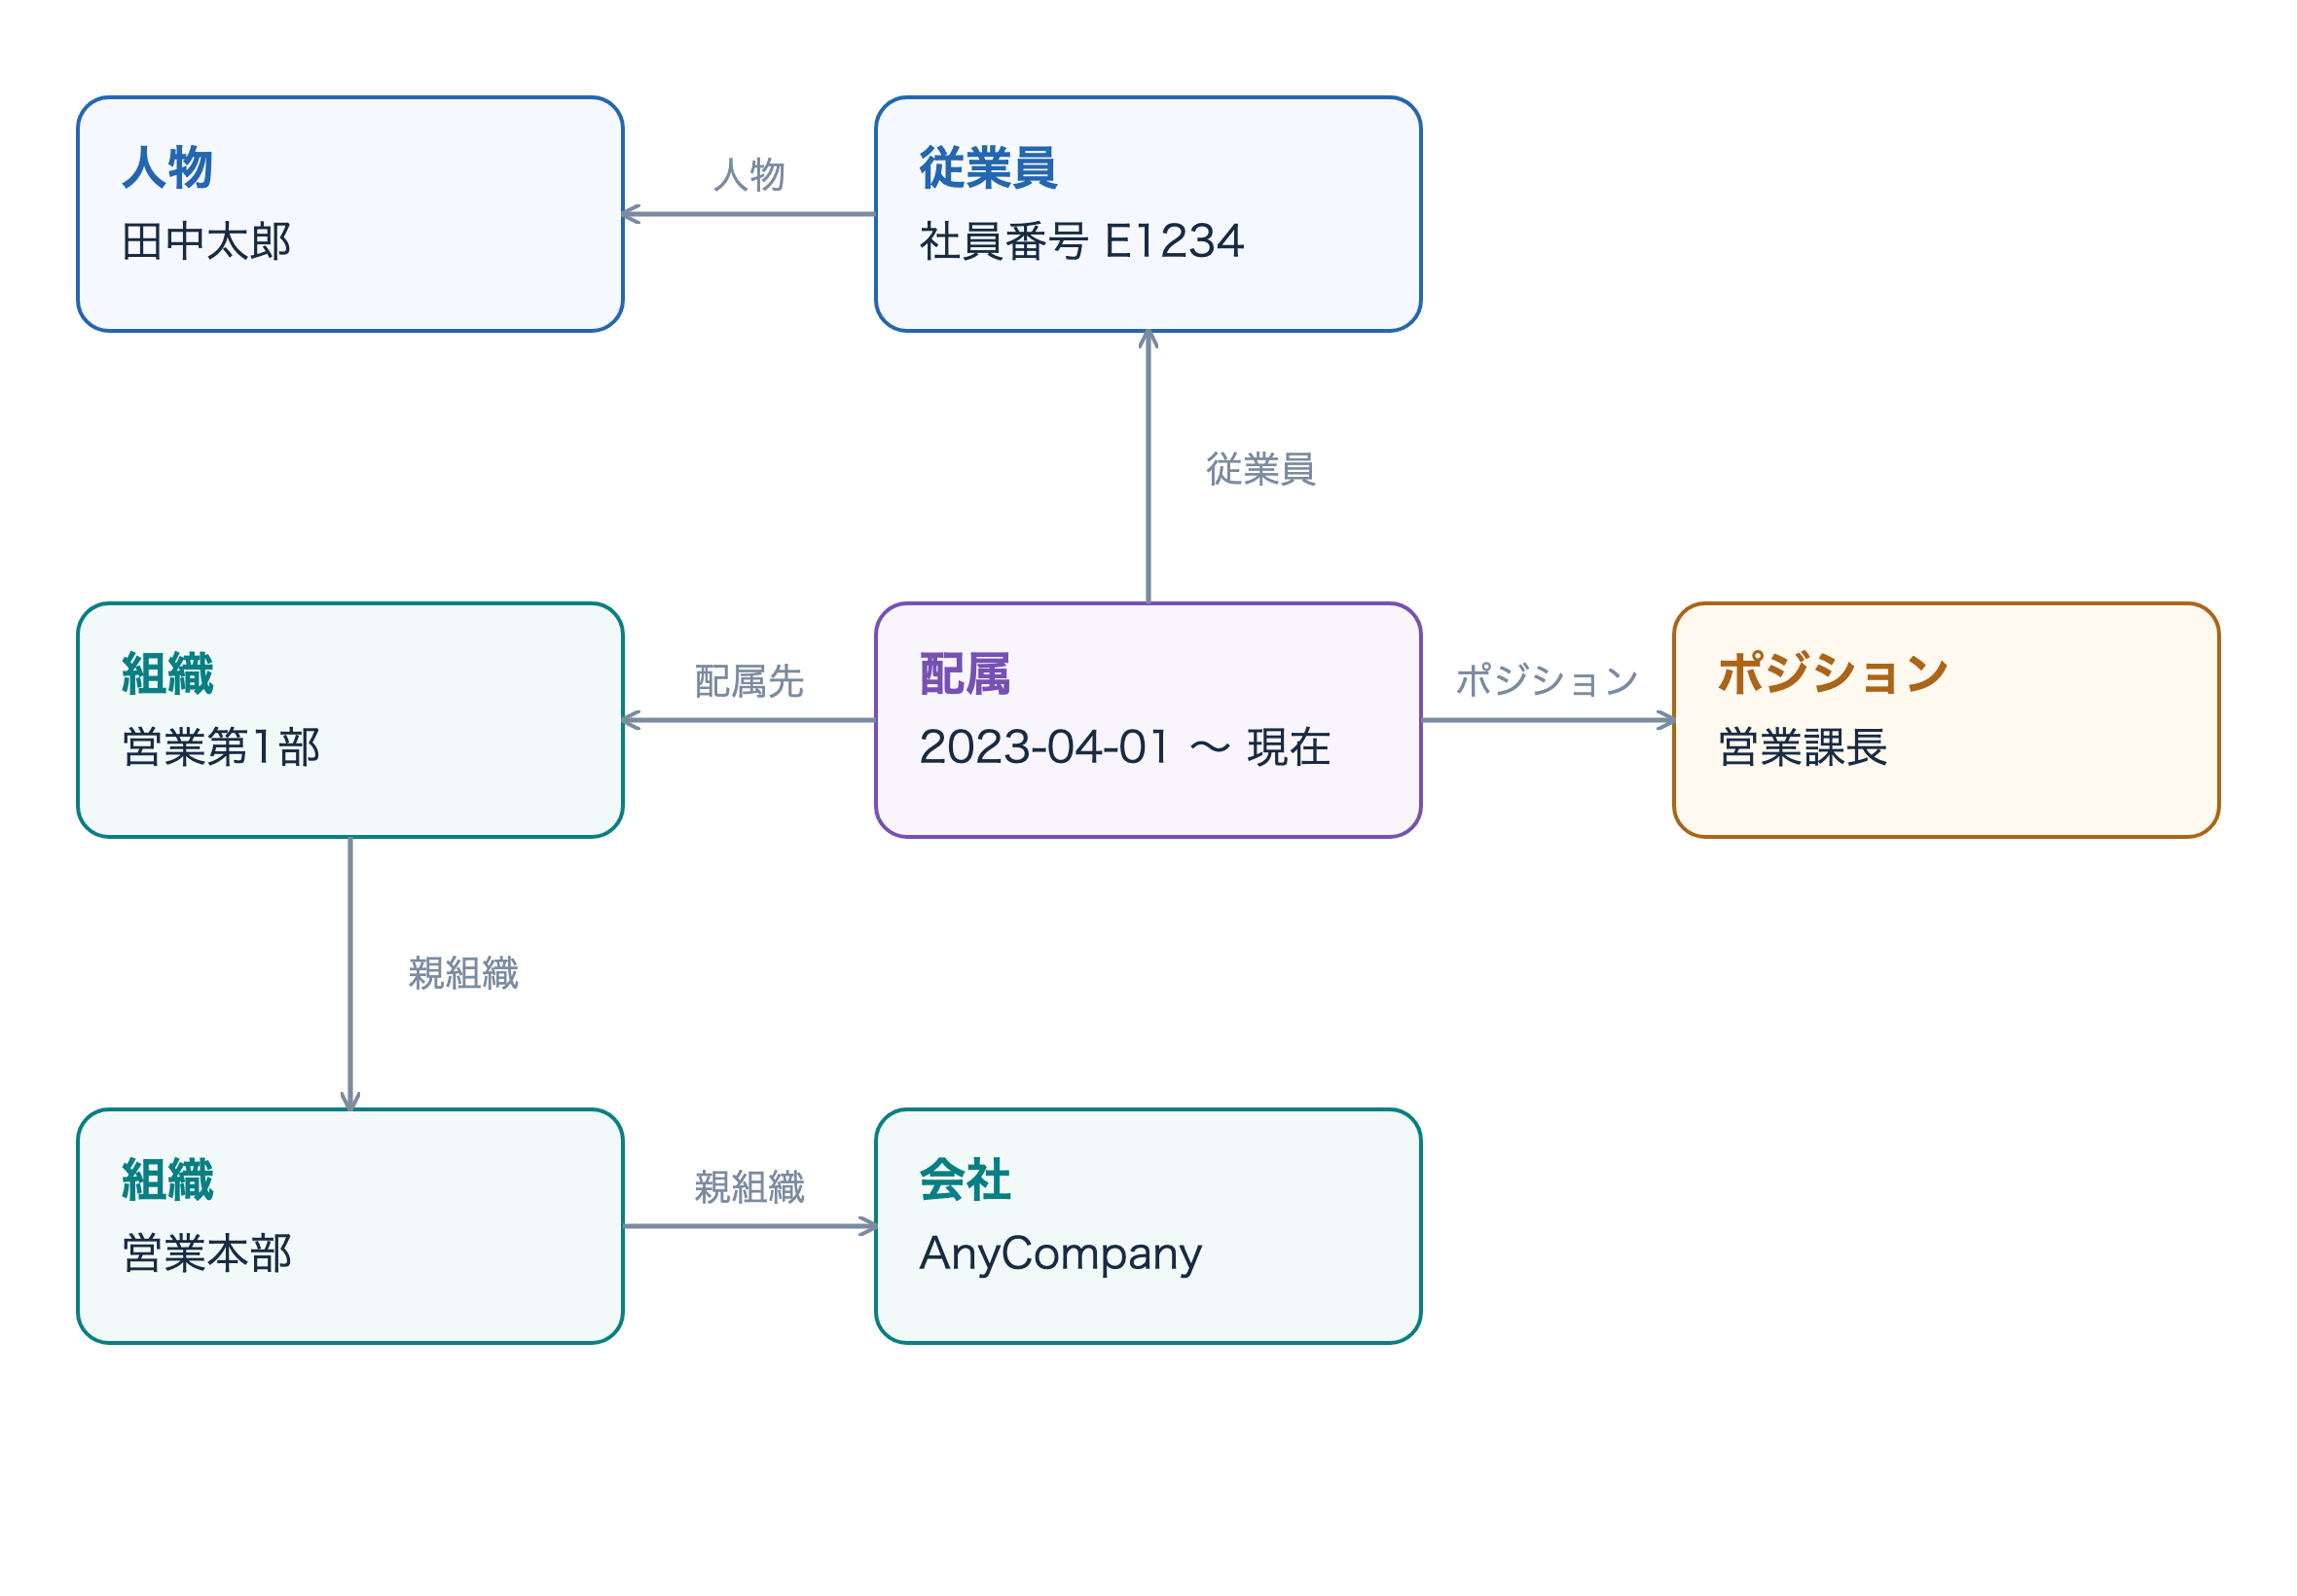
図2:人物・従業員・配属と、組織・ポジションの関係。 矢印は参照元から参照先を示します。
人物には氏名・生年月日・不変のグローバル ID、従業員には入社日・等級などの雇用属性を持たせます。配属は2023年4月1日から現在までの期間を持ち、従業員・組織・ポジションを結び付けます。
同じ「田中さん」でも、氏名は人物に、入社日は従業員に、所属は配属にぶら下がります。所属を人に直接持たせず配属を挟むことで、「2024年4月時点ではどの組織だったか」を後から再構成できます。組織どうしは親組織の関係でつながり、部から本部、本部から会社まで一本で辿れます。ポジション(営業課長)は配属から参照される独立した型なので、配属がなければ「空席の営業課長」として残ります。
クラス設計を見るだけで、この基盤が履歴も空席も時点断面も扱えると読み取れます。業務要件がオントロジーの構造に反映されているのです。
設計上の3つの判断
今回の設計判断を3つ挙げます。
(1) 標準準拠と運用拡張を分けて管理する
標準(HR Open)に含まれる語彙と、運用のために独自に足した語彙(出典管理・時制の表現・名寄せなど)を、名前空間で分けています。加えて、それぞれの語彙が「標準のどの型に相当するか」「標準にないため拡張したものか」を語彙自身に注記しています。こうすると、どこまでが標準でどこからが独自かが一目で分かり、標準への準拠範囲が運用の中で曖昧になりません。
(2) 属性を持つ関係は「中間ノード」で表す
「田中さんは Python スキルを上級レベルで持つ」。この「上級」のように、関係そのものに付く属性があります。RDF は「主語-述語-目的語」という単純な3つ組なので、関係に属性を直接足せません。そこで人物とスキルを直接つながず、間に中間的なノードを置いて熟練度を持たせます。同じ考え方は、手当(金額・期間つき)、休暇残数、承認ステップなどにも一貫して使えます。グラフで「属性付きの関係」を表現するときの定石です。
(3) 状態は「フラグ」でなく「関係の有無」で表す
ポジションが埋まっているかどうかを、ステータスのフラグで持つこともできます。本記事の設計では、現在有効な配属がそのポジションを参照しているかという関係の有無で判定します。配属と充足フラグを別々に更新すると、更新漏れで両者がずれることがあります。配属との関係を判定の基準にすることで、二重管理を避けています。
1つの語彙で取込と検索を揃える
オントロジーを共通語彙として据える利点は、取込と検索が同じ言葉で書ける点に表れます。ソースを取り込む写像ルールと、質問に答える検索クエリの両方に、同じ語彙が同じ意味で現れます。
取込ルールは、宣言的に「このソース項目を、この語彙のクラス・関係に対応づける」と書くだけです。
イメージをつかむために、配属レコードの写像を簡略化して示します。
| 入力・項目 | 写像ルール |
|---|---|
| 配属レコード | WorkAssignment クラスに対応付ける |
| 従業員への参照 | ログイン ID を名寄せしてグローバル ID に解決する |
| ポジションへの参照 | 任意(指定時点で有効な配属から参照されていないポジションを空席と判定する) |
ここで2つの設計が効いています。ログイン ID を名寄せしてグローバル ID に解決することが「複数ソースの統合」であり、ポジションへの参照を任意にすることが「空席とは参照が存在しないこと」というモデリングです。
検索側も同じ語彙で組み立てます。「今空いているポジションは?」は、取込で決めた「参照がなければ空席」の裏返しで、ポジションへの参照が存在しないものを探すだけで結果を得ることができます。「グループ会社を全部辿る」は、親組織という関係を「推移的」と定義しておけば、何階層でも子孫をたどれます。
つまり、モデリングの意味は語彙に一元化され、取込と検索はそれを参照するだけになります。「空席=参照なし」と取込で決めておけば、検索側は追加の取り決めなしに同じ定義で答えられます。ソースを取り込むときの解釈と、質問に答えるときの解釈が、1つの語彙で揃います。
同じ語彙の要約を LLM に渡すことで、質問から検索を組み立てる際に、使う概念や関係を限定します。次のセクションでは、この質問応答の設計を説明します。
質問応答の設計
自然文をそのままクエリに変換する方式の落とし穴
自然文の質問を LLM にそのままクエリへ変換させる方法では、構文エラーのあるクエリや、存在しないクラス・プロパティを使ったクエリが生成されることがあります。長いクエリの生成には時間がかかり、生成された内容をそのまま実行するリスクもあります。
意図の分類は LLM、クエリ生成は決定論
本記事の設計では、LLM にクエリ本文を書かせません。LLM の役割を「質問が何を訊いているか(意図)と、そのパラメータを取り出す」ことだけに絞ります。取り出した意図とパラメータは、あらかじめ検証済みのクエリテンプレートに機械的に流し込みます。
| 順番 | 担当 | 処理 |
|---|---|---|
| 1 | LLM | 質問の意図と、対象者・年月などのパラメータを取り出す |
| 2 | コード | パラメータを検証し、意図に対応するテンプレートから SPARQL を組み立てる |
| 3 | Amazon Neptune・検索処理 | クエリを実行し、結果と出典・鮮度を取得する |
| 4 | LLM | 取得した結果を根拠に回答文へ整形する |
たとえば「2026年7月に残業が45時間を超えた従業員は?」という質問に対して、LLM が返すのは次の2項目です。
| 項目 | 抽出結果 |
|---|---|
| 意図(intent) | 残業の確認(overtime) |
| 対象年月(yearMonth) | 2026-07 |
コードはこの意図に対応する検証済みテンプレートを選び、形式を検証した値を埋めて SPARQL を組みます。Neptune から返る結果には、事実の所在グラフから回収した出典と鮮度が付いており、最後に Claude Sonnet がその結果だけを根拠に日本語の回答文へ整形します。
鍵は、LLM に許す出力を狭く固定することです。意図は「従業員照会」「空席」「グループ構造」「時点断面」といった、あらかじめ定義した限られた選択肢からしか選べないようにします。語彙にない質問は「その他」に落とし、無理にクエリを組み立てません。取り出したパラメータ(従業員番号や日付など)も、形式や質問文中に実在するかを検証してから使います。LLM がクエリを創作する余地がないので、構文エラーも語彙のハルシネーションも原理的に起きません。
この設計には、速度と安全性の面でも効果があります。LLM に生成させるのは短い意図データだけなので、長いクエリを書かせる場合より応答が大幅に速くなります。テンプレートに渡す値も検証済みのものだけなので、インジェクションのような注入も成立しません。
共通オントロジーは、質問応答で使う概念や関係の定義も担います。意図の選択肢、パラメータの検証、テンプレートは、すべてオントロジーで定義した語彙に紐づいています。この語彙を統合の基準として使うとともに、LLM が選べる検索条件を限定する基準にもしています。
推論と制約検証の実装
取込処理では、OWL推論による分類・関係の導出、Python/SPARQLによる派生データの生成、SHACLによるデータの制約検証を行います。OWL推論で得られるのは新しい分類や関係であり、SHACL制約検証で得られるのは、データが定義した条件を満たすかを確認した結果です。
これらの処理は取込用の Lambda で実行します。現在の実装は、元データを Neptune に保存し、推論・派生結果を追加した後に、元データを対象として制約検証を実行する順序です。検索時には、保存済みの分類や関係を利用します。
以下では、処理を説明するための架空の従業員Aと勤怠レコードBを用いて、入力から何が得られるかを示します。
OWL推論:評価データから昇進候補を算出
例えば、従業員Aに2025年上期・下期の評価レコードが結び付き、どちらも S 評価だったとします。現行のオントロジーには、この2期の評価条件を満たす従業員を昇進候補とする定義があります。OWL推論によって「従業員Aは昇進候補である」という分類が導出され、orca:PromotionCandidate 型を付与するトリプルがグラフに追加されます。これにより、昇進候補を検索するクエリで従業員Aを取得できます。
推論エンジンには、Python ライブラリの owlrl を使用し、OWL 2 RL/RDF ルールを適用しています。データから新しい事実を導く前向き推論(forward chaining)で、新しいトリプルが増えなくなるまでルールを適用します。なお、オントロジーには厳密な OWL 2 RL プロファイルの構文制約を外れる定義も含むため、ここでは実際に使用する推論ルールを明示しています。
昇進候補などの分類を複数の質問で再利用できるよう、取込時に推論結果を保存し、検索時はその結果を取得する構成としています。このため、求める結論から推論ルールを逆にたどって条件を確認する後ろ向き推論は使用していません。
分類条件は、owl:equivalentClass などの OWL 公理で表し、Turtle 形式で記述します。クラスや関係の定義である TBox と、従業員や評価などの個体データである ABox を同じグラフに読み込んで推論します。主な用途は、従業員がどの分類に属するか、どの対象と関係するかを導出する ABox の実体化です。適用するルールには、クラス階層などの TBox 側の関係を導出するものも含まれます。
日付の比較、回数の集計、順序付けを伴う処理は、Python/SPARQL で計算します。例えば、現在有効な配属からポジションの充足関係を求め、その結果を補助トリプルとして追加してから OWL 推論を実行します。こうして、手続き的に計算した結果も、宣言的な分類条件の入力として使います。
SHACL制約検証:条件に違反する勤怠データを報告する
データの制約検証には、SHACL-SPARQL と、その検証エンジンである pyshacl を使用します。検証対象や違反条件を SHACL の形状として記述し、条件の判定に SPARQL を使います。ここで確認するのは、入力データが定義した制約を満たしているかどうかです。
例えば、勤怠レコードBの種別が「残業」で、時間が50時間だったとします。現行の制約は、残業の勤怠エントリごとに時間が45時間を超えているかを確認します。この例では、勤怠レコードBが閾値を超えるものとして検出され、対象レコードと違反メッセージを含む検証結果が返されます。
検証時の追加推論は無効にしています。取込処理は、検証結果から対象レコードの識別子を取り出し、違反件数と識別子の例をログに記録します。取込処理の戻り値には違反件数を含めます。
推論結果の保存と再利用
グラフに追加するのは、推論・派生処理後のグラフから、元データと元のスキーマに存在するトリプルを除いたものです。追加トリプル数には、OWL推論による導出と、Python/SPARQLによる派生生成の両方が含まれます。
もう1つ重要なのが決定論性です。基準日・評価対象の期・閾値を固定し、同じ入力データ・定義・実行条件から同じ導出結果を得られるようにしています。保存した分類を使うことで、「昇進候補を挙げて」という質問のたびに評価条件を計算する必要がなくなり、検索クエリを単純に保てます。
まとめ
本記事の設計を貫いているのは、「決定論に書けるものは決定論に寄せ、LLM は意図の解釈だけに使う」という方針です。
| 設計 | 方針 |
|---|---|
| オントロジーの設計 | 業界標準(HR Open 4.5)を共通の定義とし、取込と検索を同じ語彙で書く。履歴・空席・時点断面という業務要件をクラス設計に反映する |
| 質問応答の設計 | LLM に意図を解釈させ、クエリは検証済みテンプレートで決定論的に組み立てる。共通語彙に沿って検索条件を限定し、速度を上げ、構文エラーや注入を防ぐ |
| 推論・制約検証の実装 | 分類・関係はOWL推論、集計や順序付けはPython/SPARQL、データの制約検証はSHACLで処理する。推論・派生結果を保存して検索に使い、制約違反は検証結果として記録する |
この3つの設計で、HR で「出典と鮮度つきで正確に答える」質問応答が成立します。意味の近い文章を取得するだけでなく、オントロジーで定義した関係や条件をたどって答えることが、労務管理や人事の意思決定に使える質問応答の条件だと考えています。
本記事では、HR Open Standards を使って業務上の概念や関係を定義し、その共通オントロジーをデータ統合、LLM の検索条件の制御、取込時の推論に使う設計を紹介しました。オントロジーを業務要件と具体的な処理に結び付けることが、この設計の要点です。
このブログの著者
安達 翔平 (さばみそ)
アマゾン ウェブ サービス ジャパン合同会社
ISV/SaaS ソリューションアーキテクト
和智 大二郎
アマゾン ウェブ サービス ジャパン合同会社
シニアソリューションアーキテクト