AWS 기술 블로그
Amazon SageMaker AI와 AWS IoT Greengrass를 활용한 Physical AI 학습 파이프라인 구축하기
로봇을 움직이는 제어 정책을 학습할 때는 수백만 번의 시행착오가 필요합니다. 학습한 모델로 원하는 동작을 수행하는지 반복해서 검증해야 하는데, 실제 로봇으로 이를 반복하면 시간이 오래 걸리고 비용이 크며 로봇이 파손될 위험이 있습니다. 그래서 로봇 개발팀은 시뮬레이션에서 학습하고 실제 로봇에서 검증하는 Sim-to-Real 접근법을 사용합니다.
하지만 시뮬레이션에서 수많은 시행착오를 거치고 사전 학습된 모델을 로봇 데이터로 미세 조정하는 작업은 모두 GPU 클러스터가 필요하고, GPU 서버를 구매하여 운영하는 일 자체가 새로운 병목이 됩니다. 즉, 강화학습(Reinforcement Learning, RL)과 모방학습 (Imitation Learning, IL) 접근법 모두 학습용 컴퓨팅 자원, 시뮬레이션 환경, 엣지 추론 환경이 필요합니다.
이 글은 핸즈온 워크숍 “From Training to Edge: Physical AI on AWS“를 바탕으로 Physical AI 모델 학습 파이프라인을 구축하는 과정을 AWS에서 구성하는 방법을 설명합니다. VLA(Vision-Language-Action) 트랙에서는 Amazon SageMaker AI의 Amazon SageMaker Pipelines로 NVIDIA Isaac GR00T 모델을 SO-101 로봇 팔 데이터셋에 맞게 미세 조정(fine-tuning)하고 NVIDIA Isaac Lab에서 폐루프(closed-loop) 평가를 수행한 뒤 AWS IoT Greengrass로 배포합니다.
강화학습(RL) 트랙은 PPO(Proximal Policy Optimization) 알고리즘으로 Isaac Lab과 MuJoCo에서 SO-101 로봇 팔의 Reach / Lift 작업 정책을 학습합니다. 이 글에서 Amazon SageMaker HyperPod의 Slurm 구성을 중심으로 다루며 Amazon Elastic Kubernetes Service(Amazon EKS)를 사용하는 구성도 소개합니다. 인프라는 AWS Cloud Development Kit(AWS CDK)로 정의되어 있고 실습 코드는 aws-physical-ai-recipes 저장소에서 확인할 수 있습니다.
전체 파이프라인 한눈에 보기
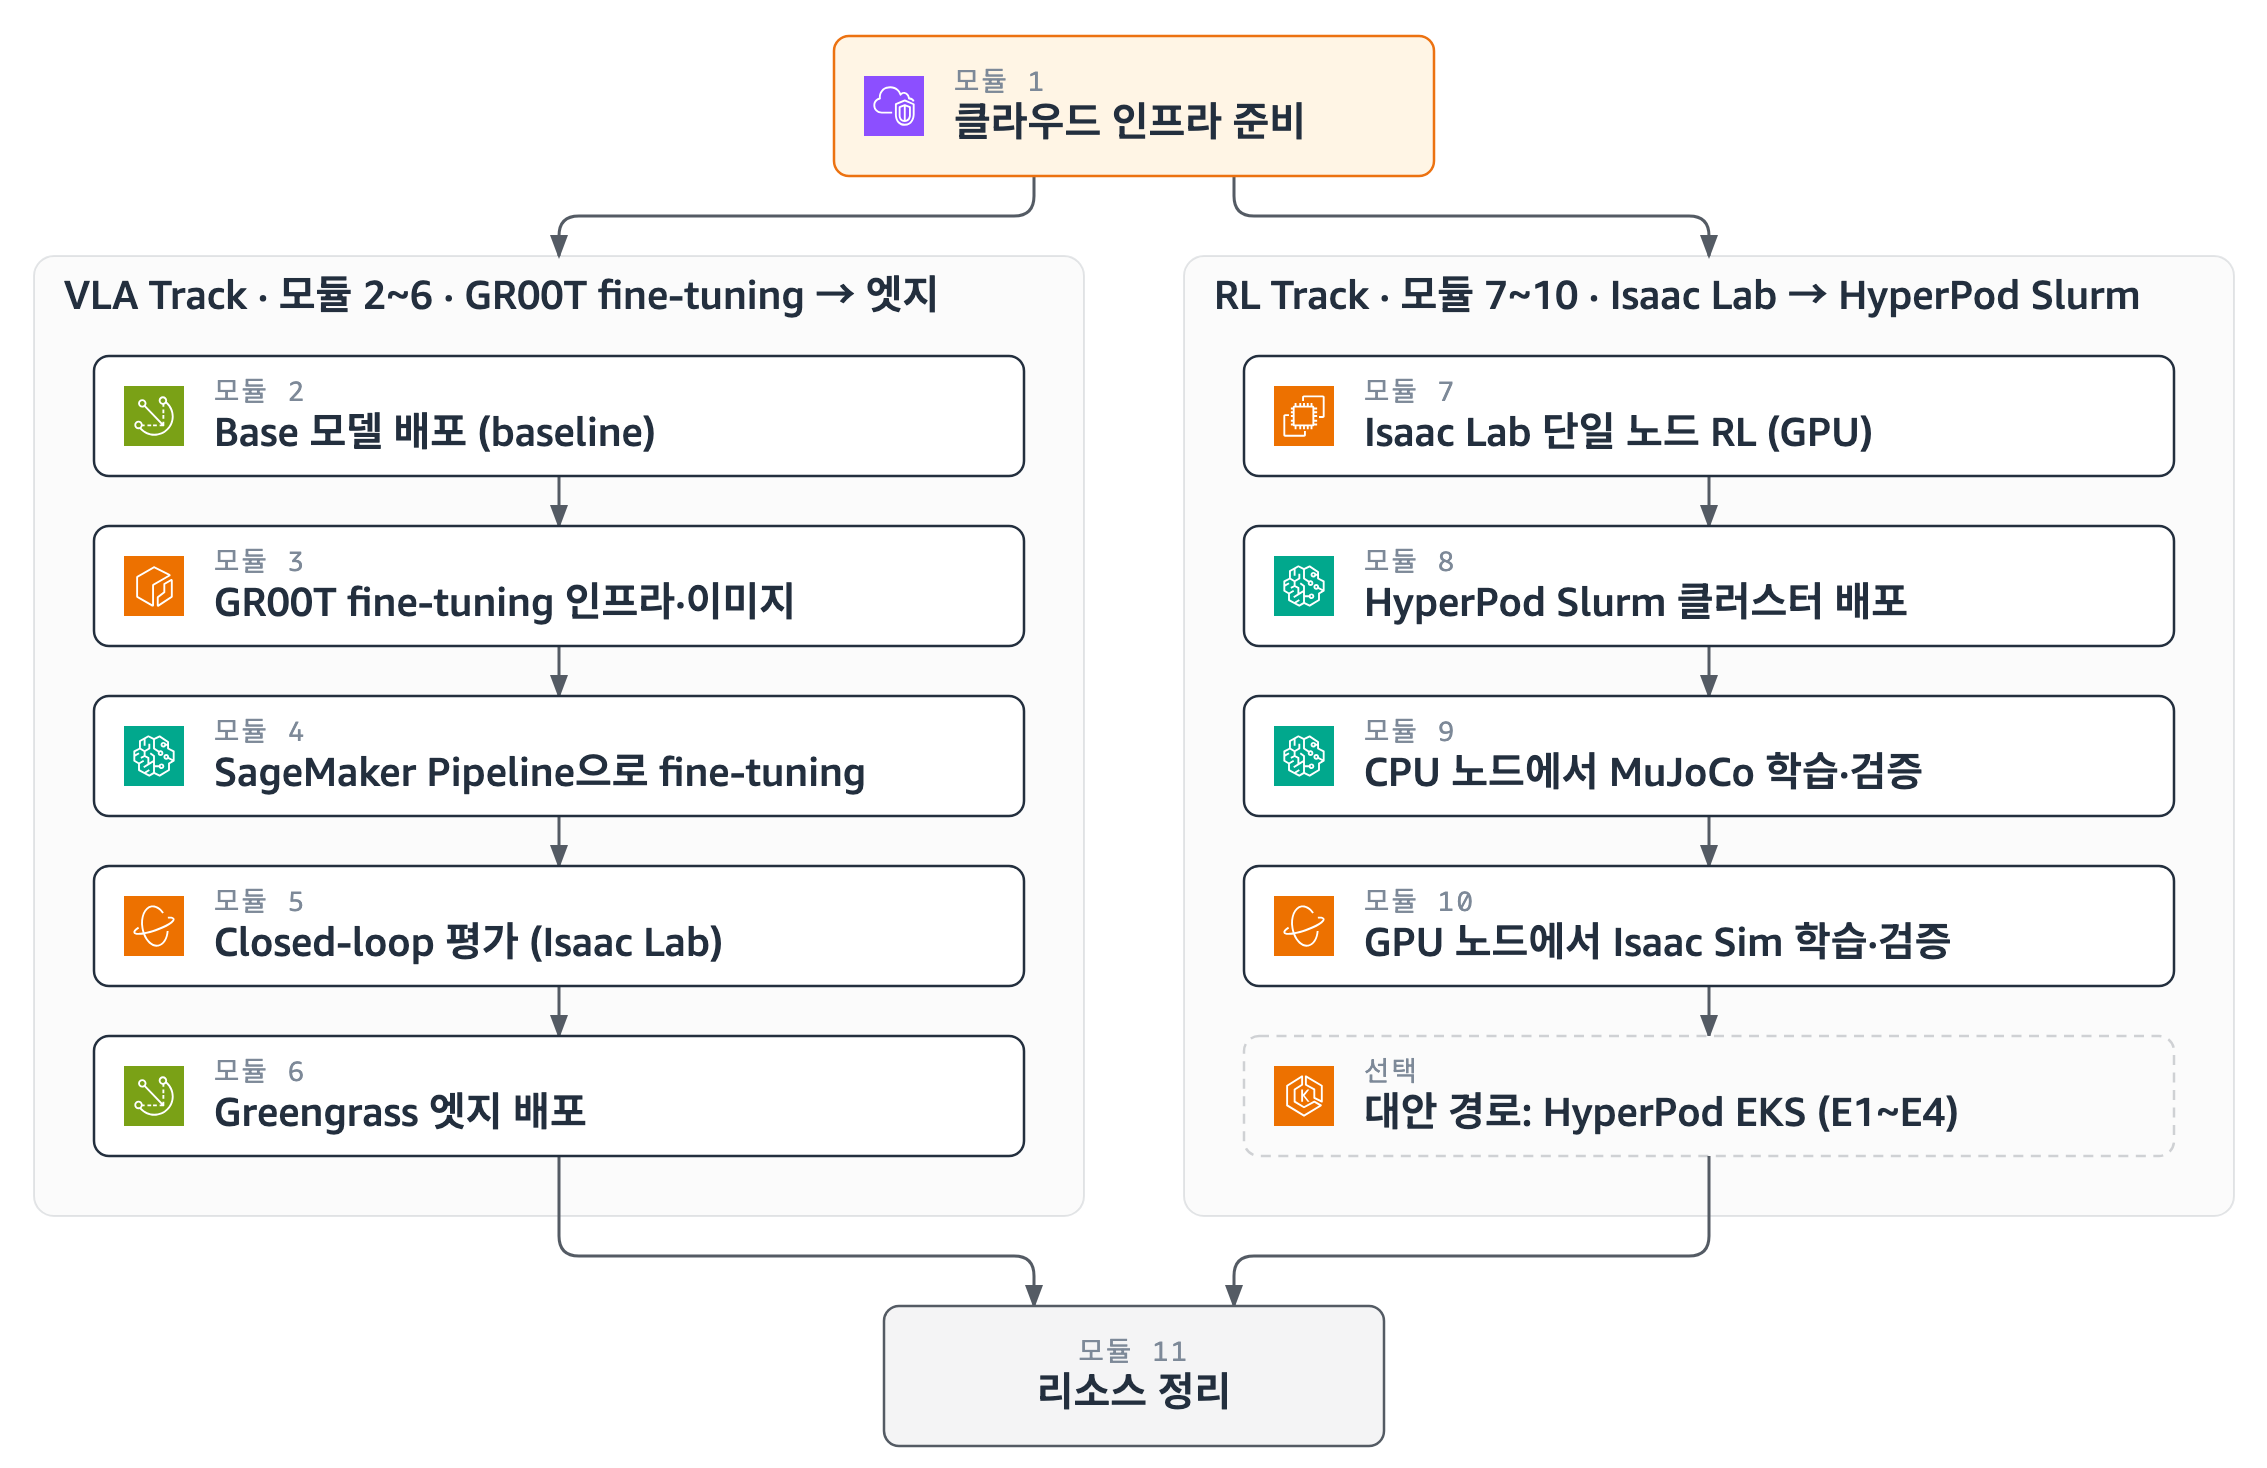
그림 1. 전체 워크샵 파이프라인
Physical AI 모델을 만드는 방법은 두 가지입니다. 범용 VLA 모델을 자기 로봇 데이터로 fine-tuning하는 VLA 트랙과, 보상 함수만으로 단일 태스크 정책을 처음부터 학습하는 강화학습(RL) 트랙입니다. 학습 방법은 달라도 두 트랙은 같은 인프라 위에서 움직이며 시뮬레이션 워크스테이션, S3 저장소, CDK 정의를 공유합니다.
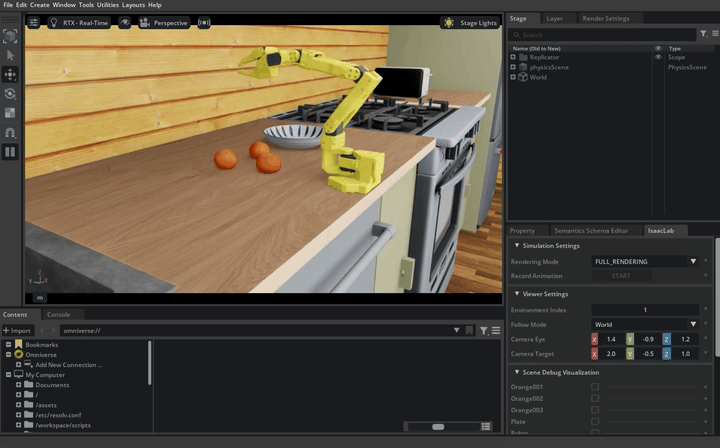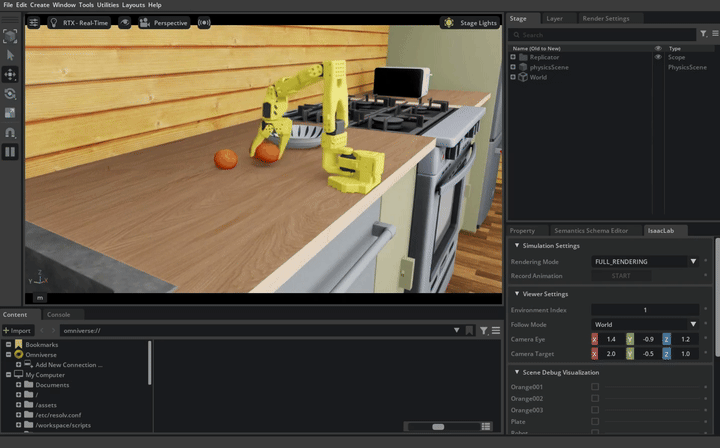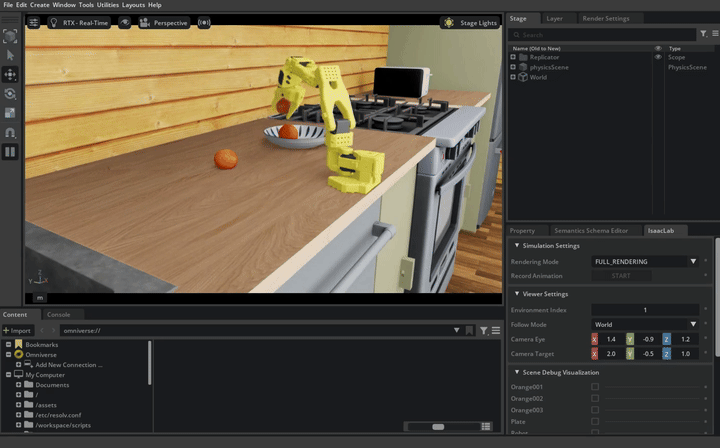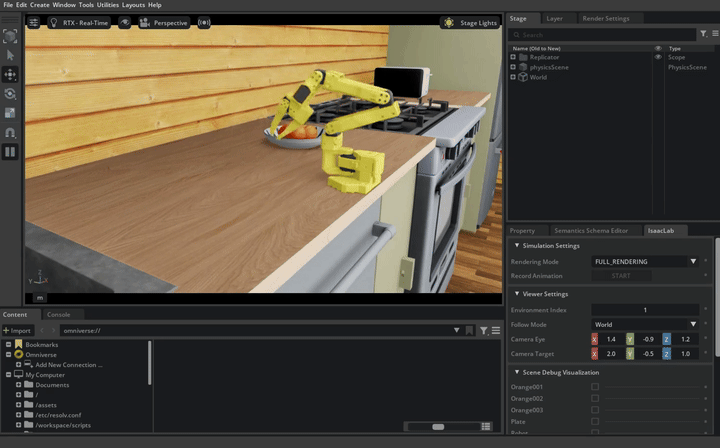
그림 2. VLA 트랙의 시뮬레이션 평가 예시. GR00T 모델이 자연어 명령을 받아 SO-101 팔로 오렌지를 집어 접시에 올립니다.
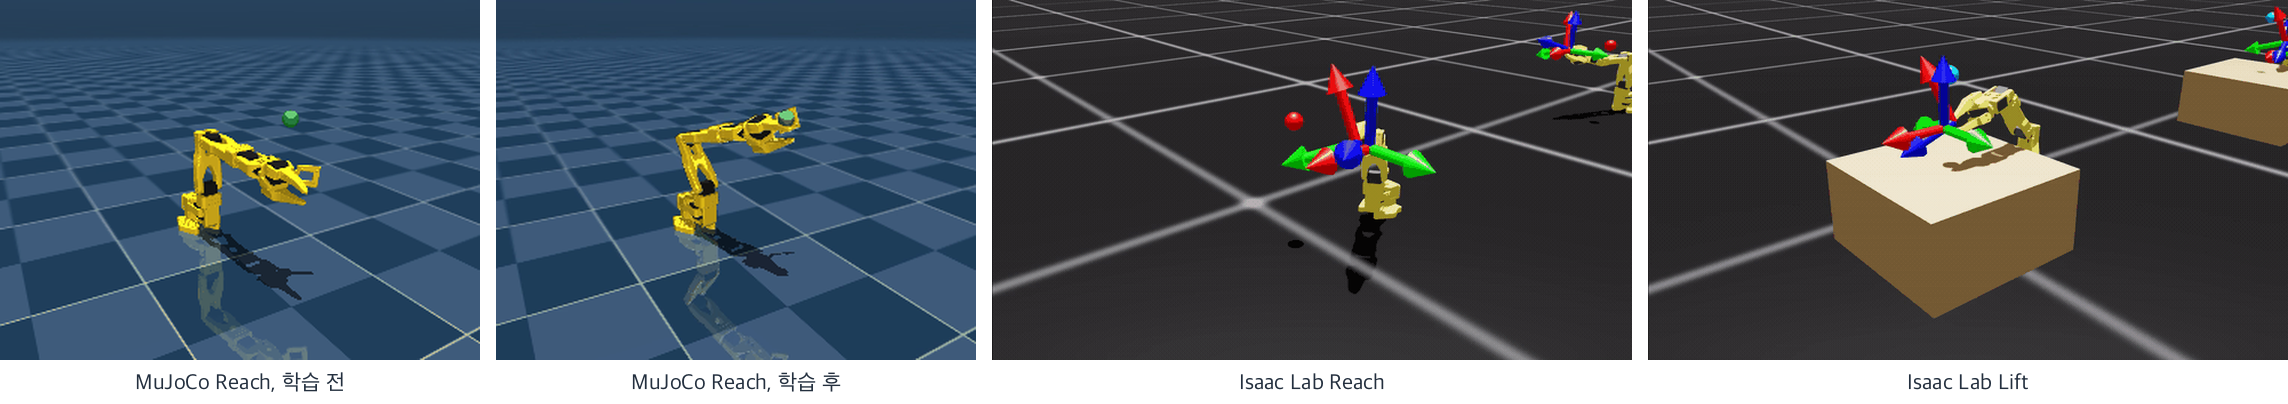
그림 3. RL 트랙 실습 결과(Isaac Lab). PPO로 학습한 SO-101 Reach/Lift 정책이 MuJoCo와 Isaac Lab에서 실행됩니다.
1. 학습 준비
- VLA: SO-101 팔을 텔레오퍼레이션으로 조작해 LeRobot 형식 데이터셋(leisaac-pick-orange)을 만들어 S3에 업로드
- RL: 태스크와 보상 함수를 정의(SO-101 Reach/Lift, Unitree H1 보행 등)
2. 학습
학습 인프라 선택: 작업 단위로 시작·종료하는 fine-tuning은 SageMaker Training Job/Pipelines를, 수일~수주 반복 실험은 HyperPod 클러스터를 사용합니다.
- VLA: SageMaker Pipelines(Training Job)가 S3 데이터셋과 ECR 이미지로 GR00T를 fine-tuning하고, 체크포인트를 S3에, 지표를 Amazon SageMaker AI의 관리형 Amazon SageMaker AI의 관리형 MLflow에 저장
- RL: SageMaker HyperPod 클러스터에서 Isaac Lab과 PPO로 정책을 장시간 학습하고, 체크포인트를 FSx와 S3에 저장
3. 시뮬레이션 검증
워크스테이션의 Isaac Lab에서 확인합니다.
- VLA: Closed-loop 평가로 오렌지 집기 성공률을 측정
- RL: 학습한 Reach/Lift, 보행 정책을 재생해서 확인. 기준에 못 미치면 학습 단계로 되돌아가 반복
4. 엣지 배포
- 성능 기준을 통과한 모델을 AWS IoT Greengrass 컴포넌트로 엣지 디바이스(NVIDIA Jetson 계열)에 배포하고 TensorRT로 최적화. (이 글에서 RL 트랙은 시뮬 검증까지 다룹니다.)
1. Physical AI 개발에 필요한 세 가지 컴퓨팅 환경
1.1 학습/시뮬레이션/추론의 요구사항
NVIDIA는 Physical AI를 “카메라, 로봇, 자율주행차 같은 자율 시스템이 물리 세계를 인식하고 이해하고 추론하고 행동하게 하는 AI”로 정의합니다.(참고) 로봇 제어 정책을 학습시키려면 걷기나 물건 잡기 같은 동작을 수백만 번 시도해야 합니다. 실제 로봇으로 이를 반복하면 시간이 오래 걸리고 비용이 크며 로봇이 파손될 위험이 있습니다. 그래서 로봇 팀은 NVIDIA Isaac Lab 같은 시뮬레이터로 물리 엔진을 GPU 위에서 돌리고 한 개의 환경을 수천 개로 복제합니다. Isaac Lab은 PhysX 5 GPU 파이프라인으로 GPU 한 장에서 2,048개에서 4,096개의 환경을 동시에 시뮬레이션하고, domain randomization을 통해 시뮬레이터 안에서 조명과 질감, 물성을 무작위로 바꿔 시뮬레이션과 현실의 차이(reality gap)를 줄입니다.
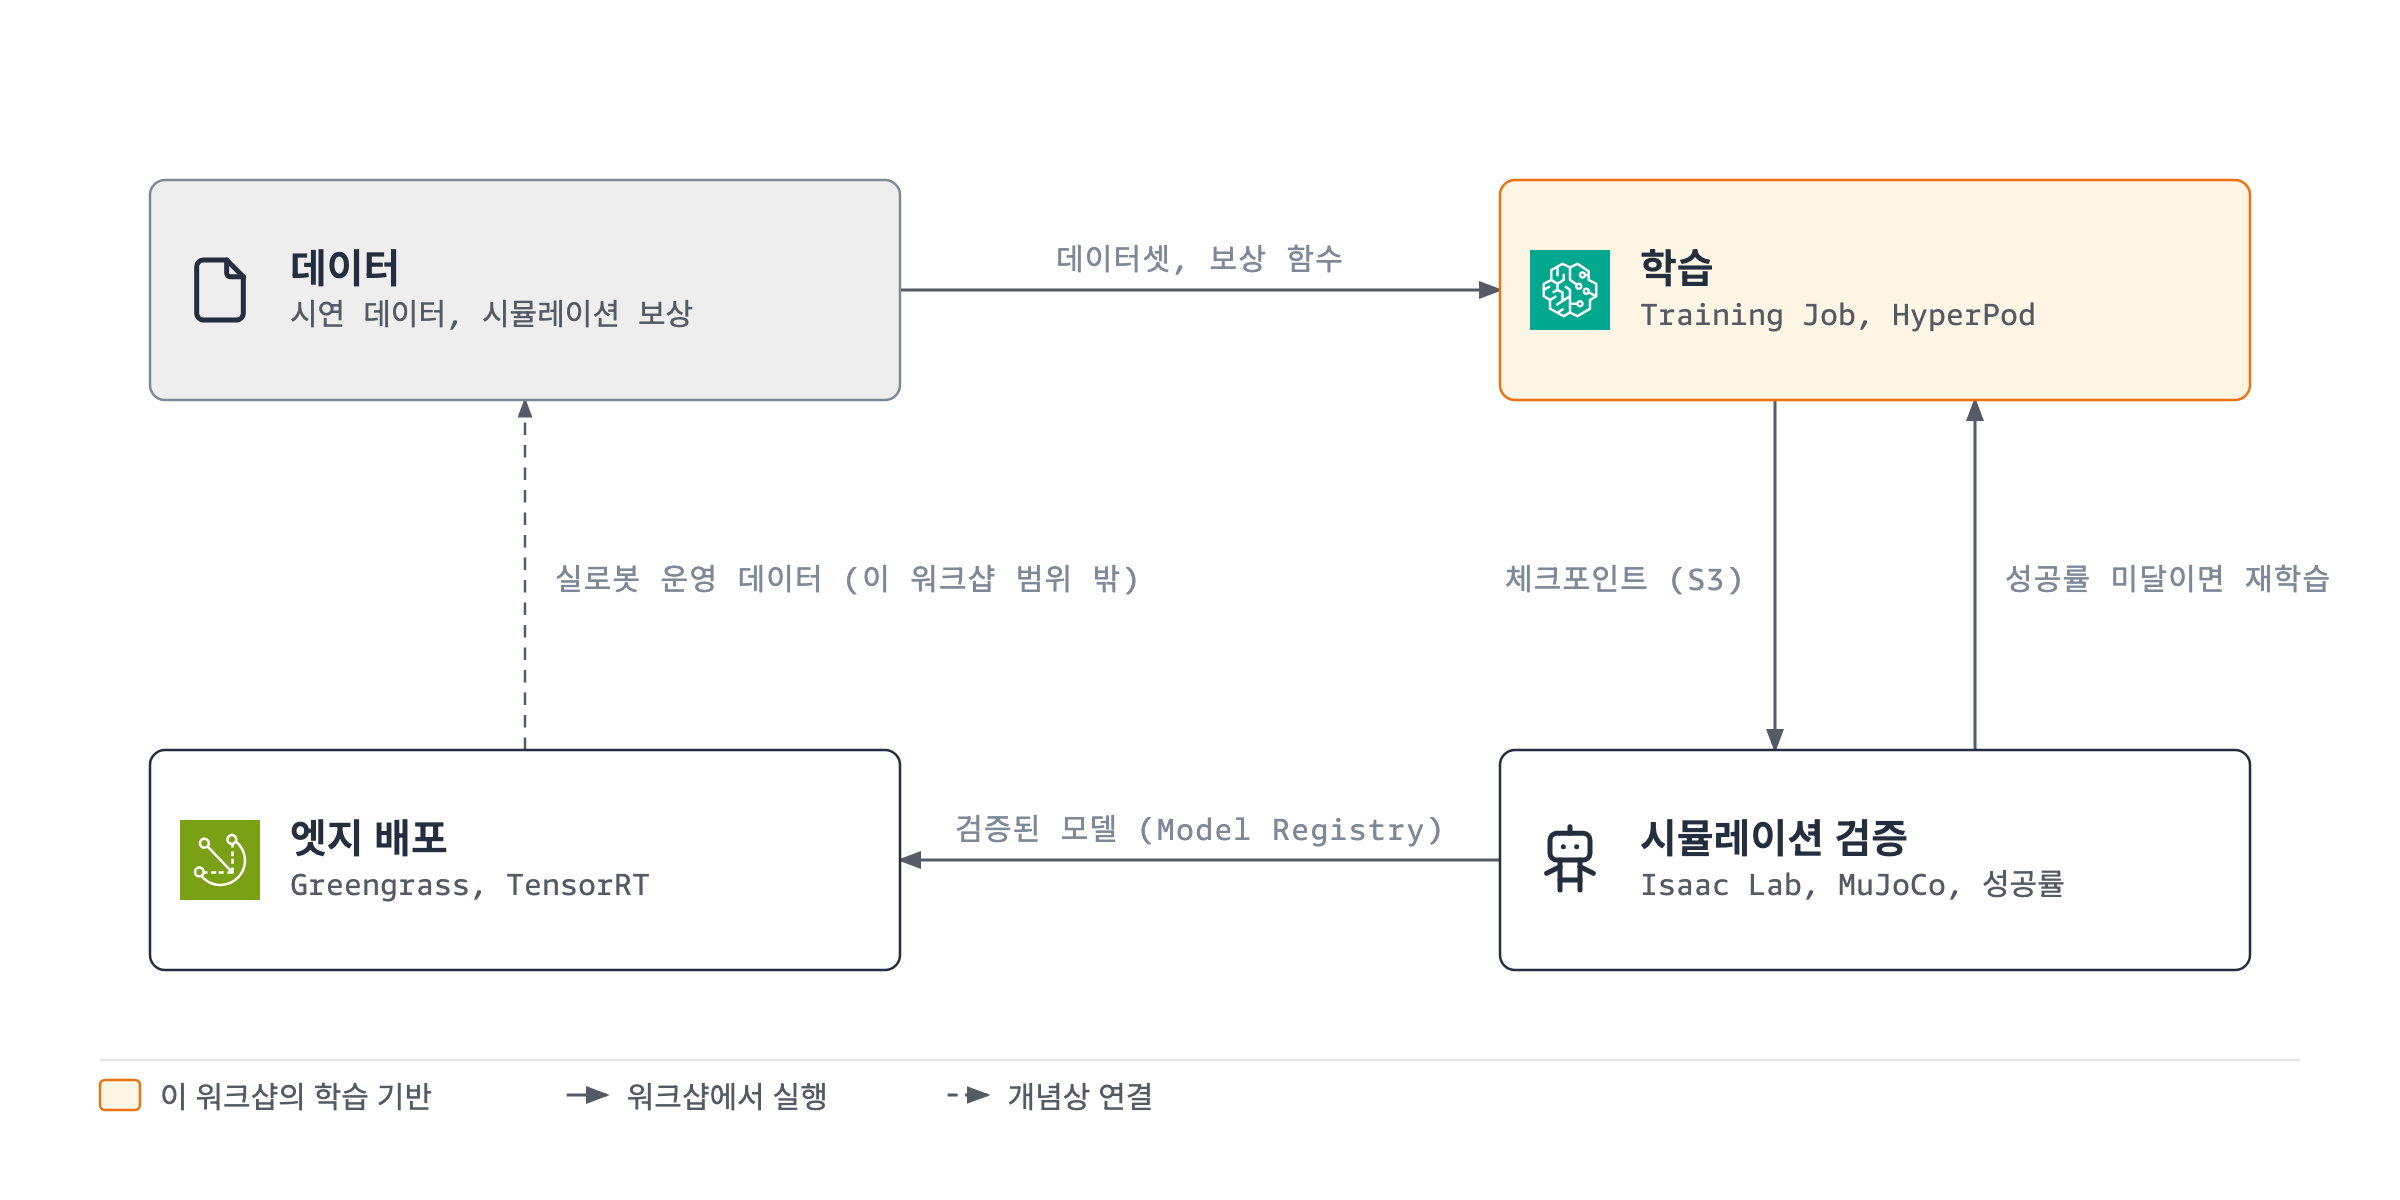
그림 4. 데이터 수집, 학습, 시뮬레이션 검증, 엣지 배포를 반복하는 개발 흐름
여기서 인프라 문제가 시작됩니다. Physical AI 개발에는 세 종류의 컴퓨터가 필요합니다. 모델을 학습하는 컴퓨터, 시뮬레이션으로 합성 데이터를 만들고 정책을 검증하는 컴퓨터, 로봇 위에서 실시간으로 추론하는 컴퓨터입니다.
이 셋은 요구하는 하드웨어가 다릅니다. 학습 컴퓨터에는 모델과 옵티마이저 상태를 담을 메모리와 충분한 연산 성능이 필요합니다. 시뮬레이션 컴퓨터는 물리 연산과 함께, 카메라 관측값이나 영상을 위한 렌더링도 필요합니다. Isaac Sim의 렌더링에는 RT 코어가 필요하므로 A100, H100처럼 RT 코어가 없는 GPU를 그대로 사용할 수 없습니다. 추론 컴퓨터는 로봇에 실리는 Jetson 같은 엣지 장치로, 로봇과 가까운 곳에서 관측을 받아 행동을 반환하며 장치의 메모리와 응답 지연에 맞춰 모델을 실행합니다.
이 세 종류의 하드웨어를 온프레미스로 갖추고 유지하는 일은 대부분의 팀에게 현실적이지 않습니다.
1.2 각 환경에 AWS 서비스 배치하기
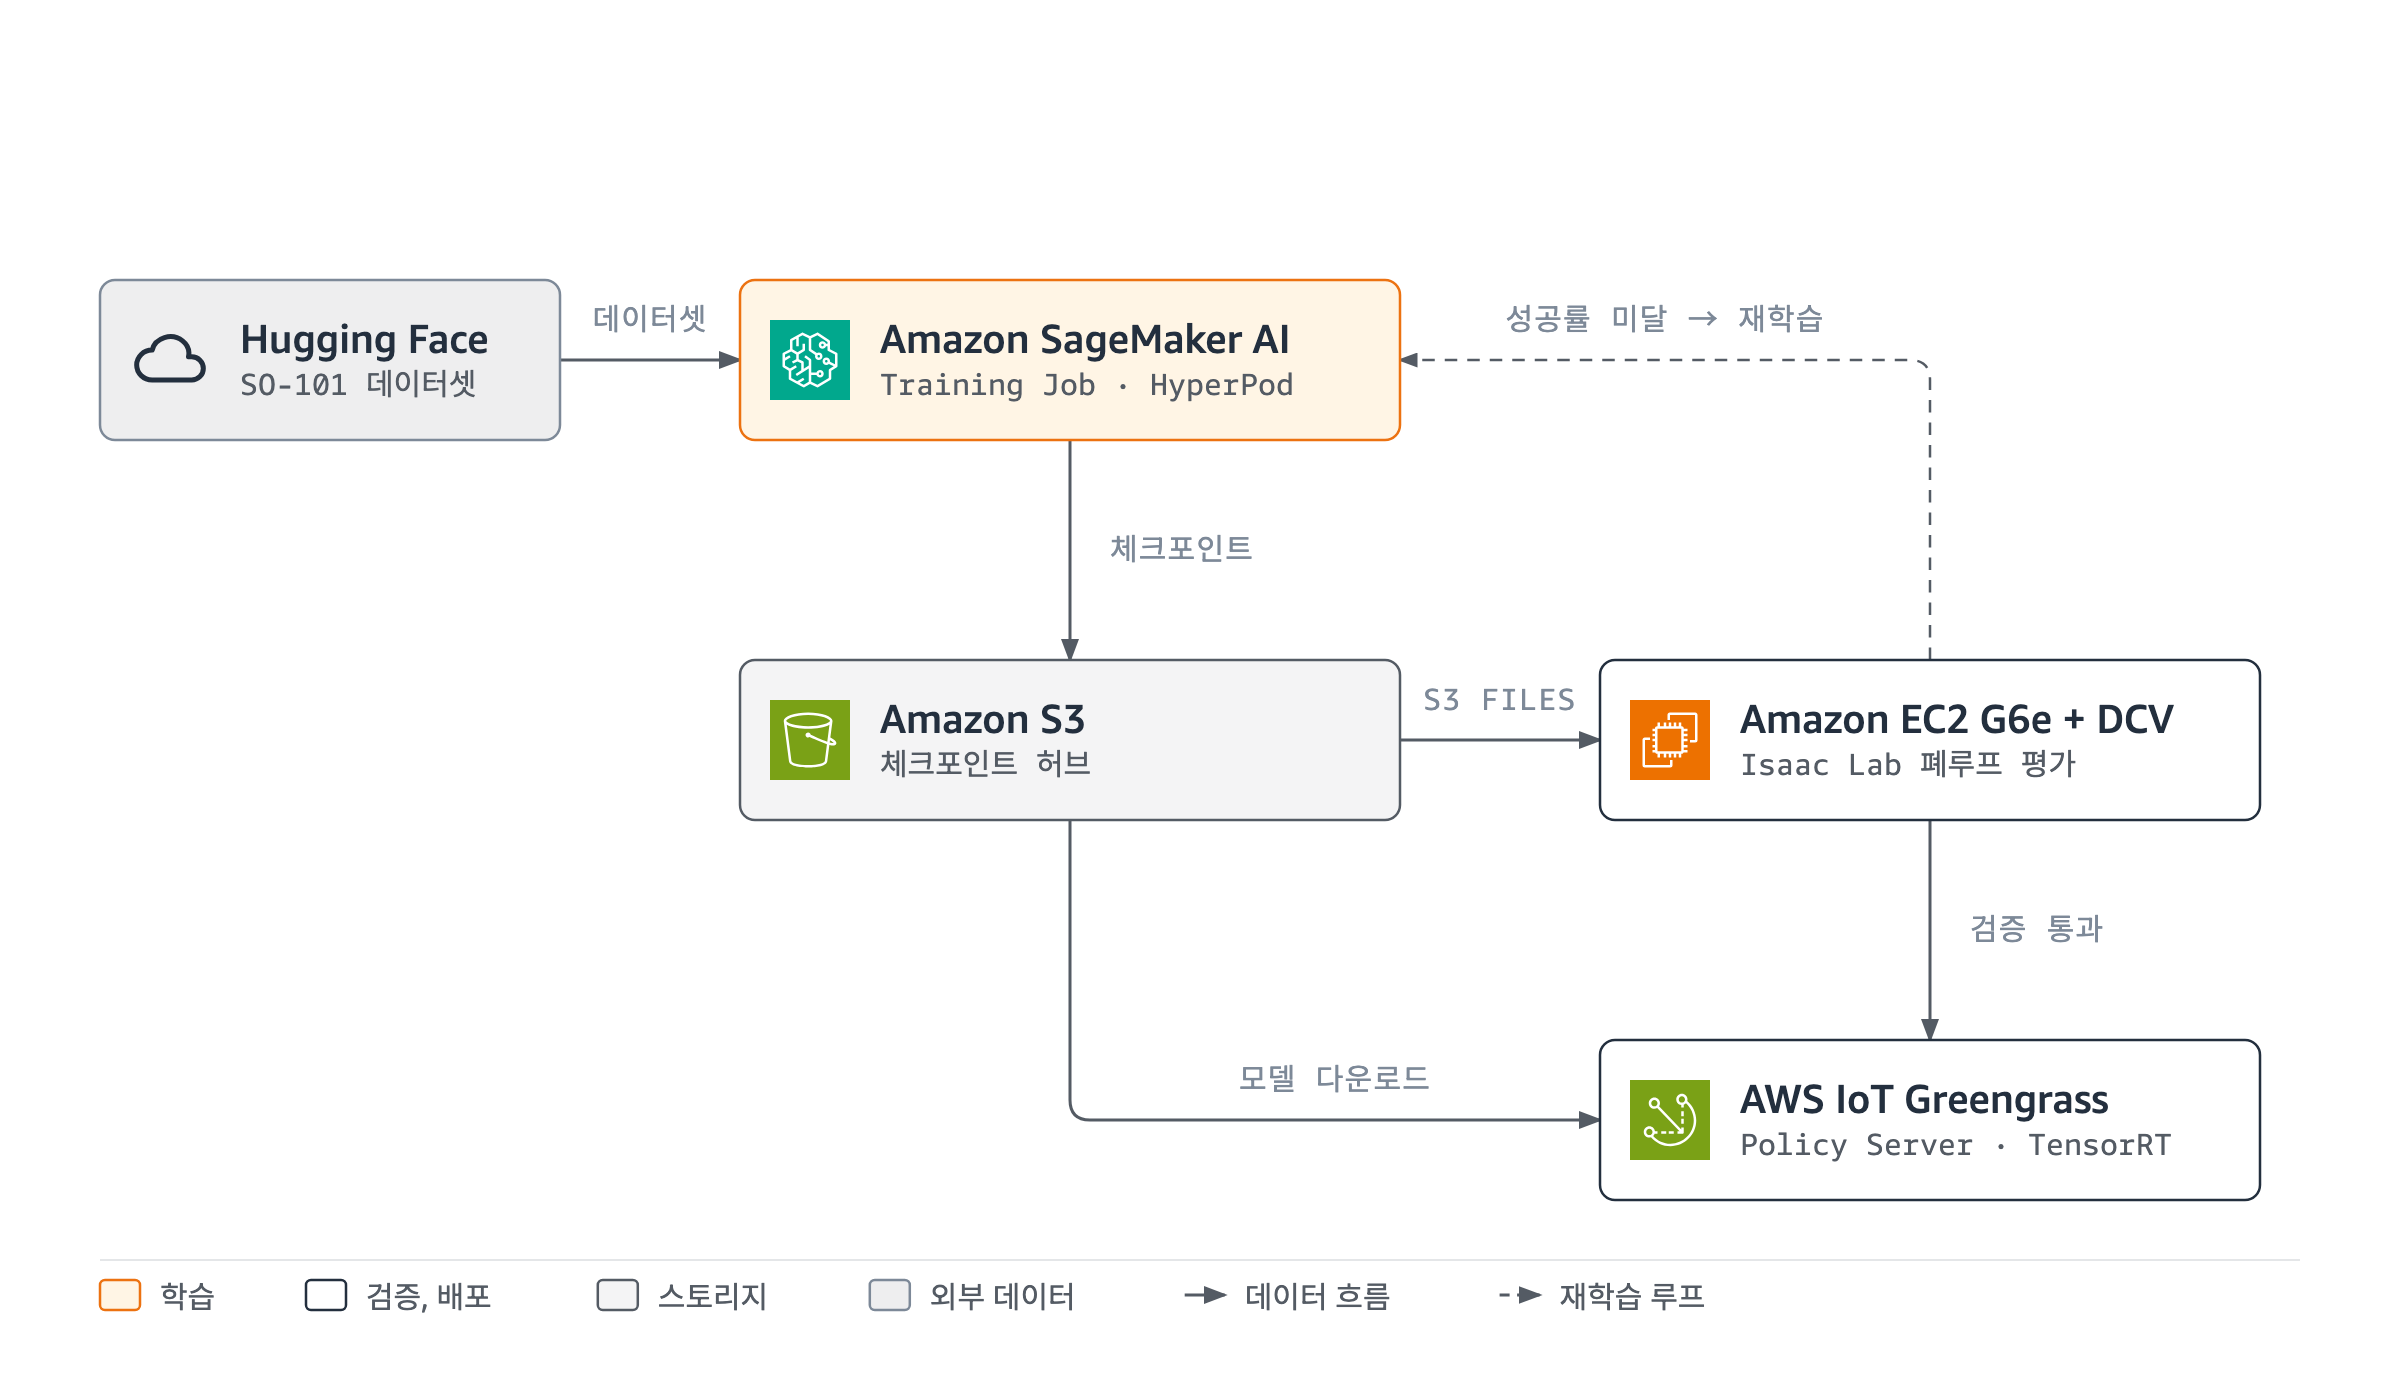
그림 5. 학습, 검증, 배포 파이프라인 아키텍처
워크숍은 학습에 SageMaker AI의 Training Job과 HyperPod를, 시뮬레이션과 검증에는 NVIDIA L40S를 탑재한 Amazon Elastic Compute Cloud(Amazon EC2) G6e 인스턴스와 Amazon DCV를 사용합니다. 엣지의 추론 프로세스는 AWS IoT Greengrass 컴포넌트로 배포합니다. 학습 데이터셋과 체크포인트는 Amazon Simple Storage Service(Amazon S3)에 저장하고 추론 점검을 통과한 모델의 버전은 Amazon SageMaker Model Registry에 등록합니다. 로봇 작업 성공률은 시뮬레이션 환경의 Closed-loop 평가에서 확인하며, 성능의 기준치를 통과한 모델만 엣지로 배포합니다.
2. 학습 방법에 따른 SageMaker AI 학습 환경 선택
로봇 제어 모델을 만드는 방식은 크게 둘로 갈립니다. 자연어로 지시하는 범용 VLA foundation model을 자기 로봇 데이터로 fine-tuning할 수도 있고, 보상 함수만 주고 시뮬레이션 시행착오로 단일 태스크 정책을 처음부터 학습하는 강화학습을 쓸 수도 있습니다. 각 학습 방법에 따라 그에 맞는 SageMaker AI 인프라도 달라집니다.
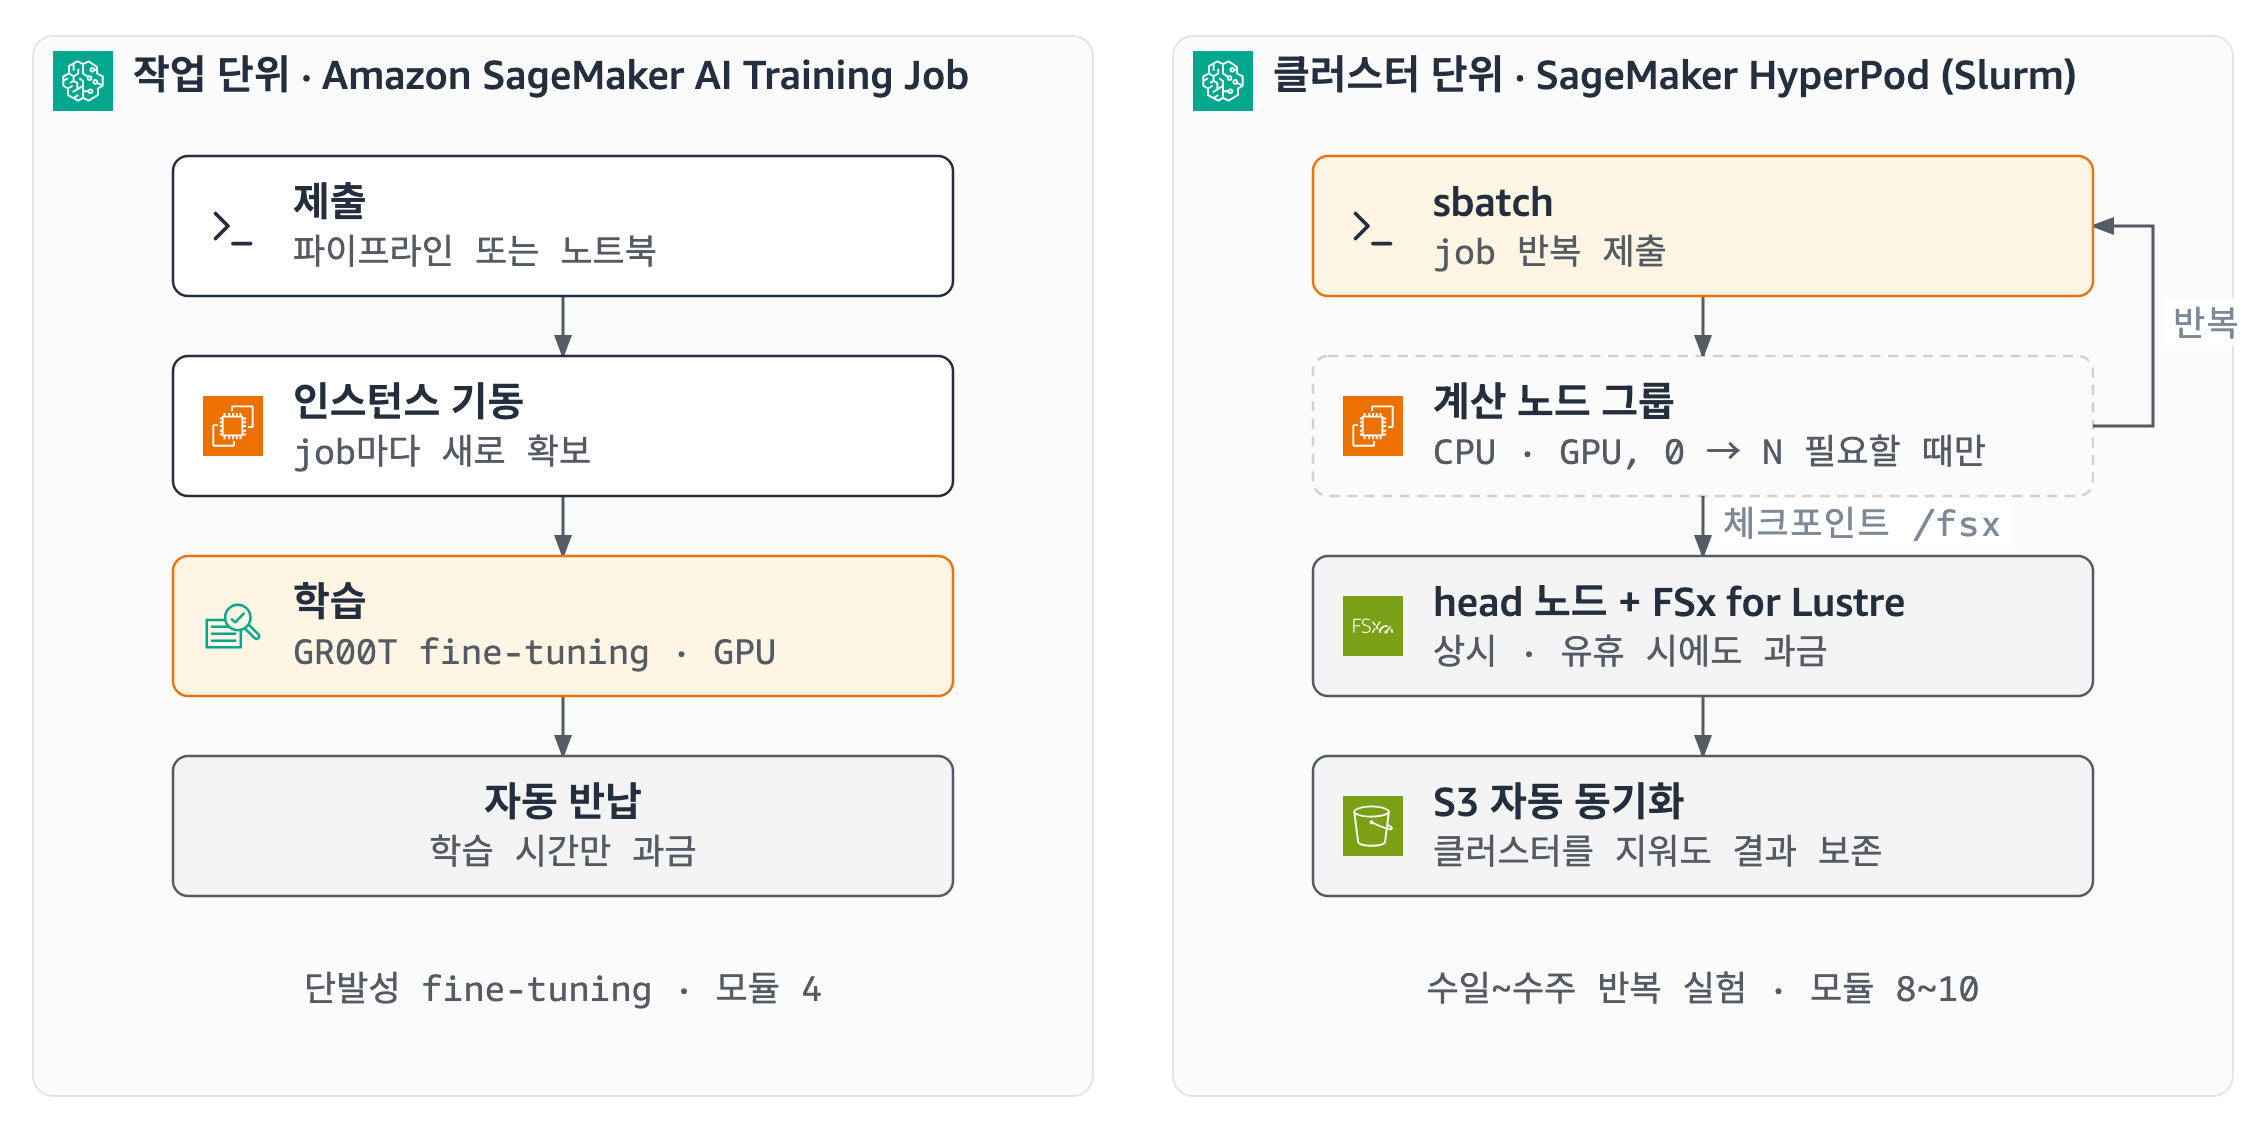
그림 6. 작업마다 자원을 준비하는 Training Job과 여러 실험이 클러스터를 공유하는 HyperPod의 운영 방식
입력 데이터와 하이퍼파라미터를 설정하여 학습 작업을 제출하는 경우에는 SageMaker AI의 Training Job을 고려할 수 있습니다. SageMaker Training Job은 완전관리형 학습 인프라로, SageMaker AI가 인스턴스를 준비하고 학습이 끝나면 자동으로 학습 인스턴스를 종료합니다. 학습이 끝나면 인스턴스를 반납하기에, 과금은 학습에 쓴 시간에만 발생하고 유휴 인스턴스가 남지 않습니다.
여러 실험이 같은 환경과 스케줄러, 공유 스토리지를 사용해야 한다면 HyperPod 클러스터를 고려할 수 있습니다. VLA 모델을 pre-training하거나 강화학습 정책을 만들려면 모델과 태스크를 바꿔 가며 수일에서 수주 동안 실험을 반복해야 하는데, HyperPod는 연산 노드와 실행 환경을 지속적으로 유지하면서 학습과 평가를 여러 job으로 제출하게 해 줍니다. HPC의 Slurm 환경에 익숙한 팀은 Slurm 구성을, Kubernetes와 팀별 자원 정책을 관리하는 팀은 Amazon EKS 구성을 선택할 수 있습니다.
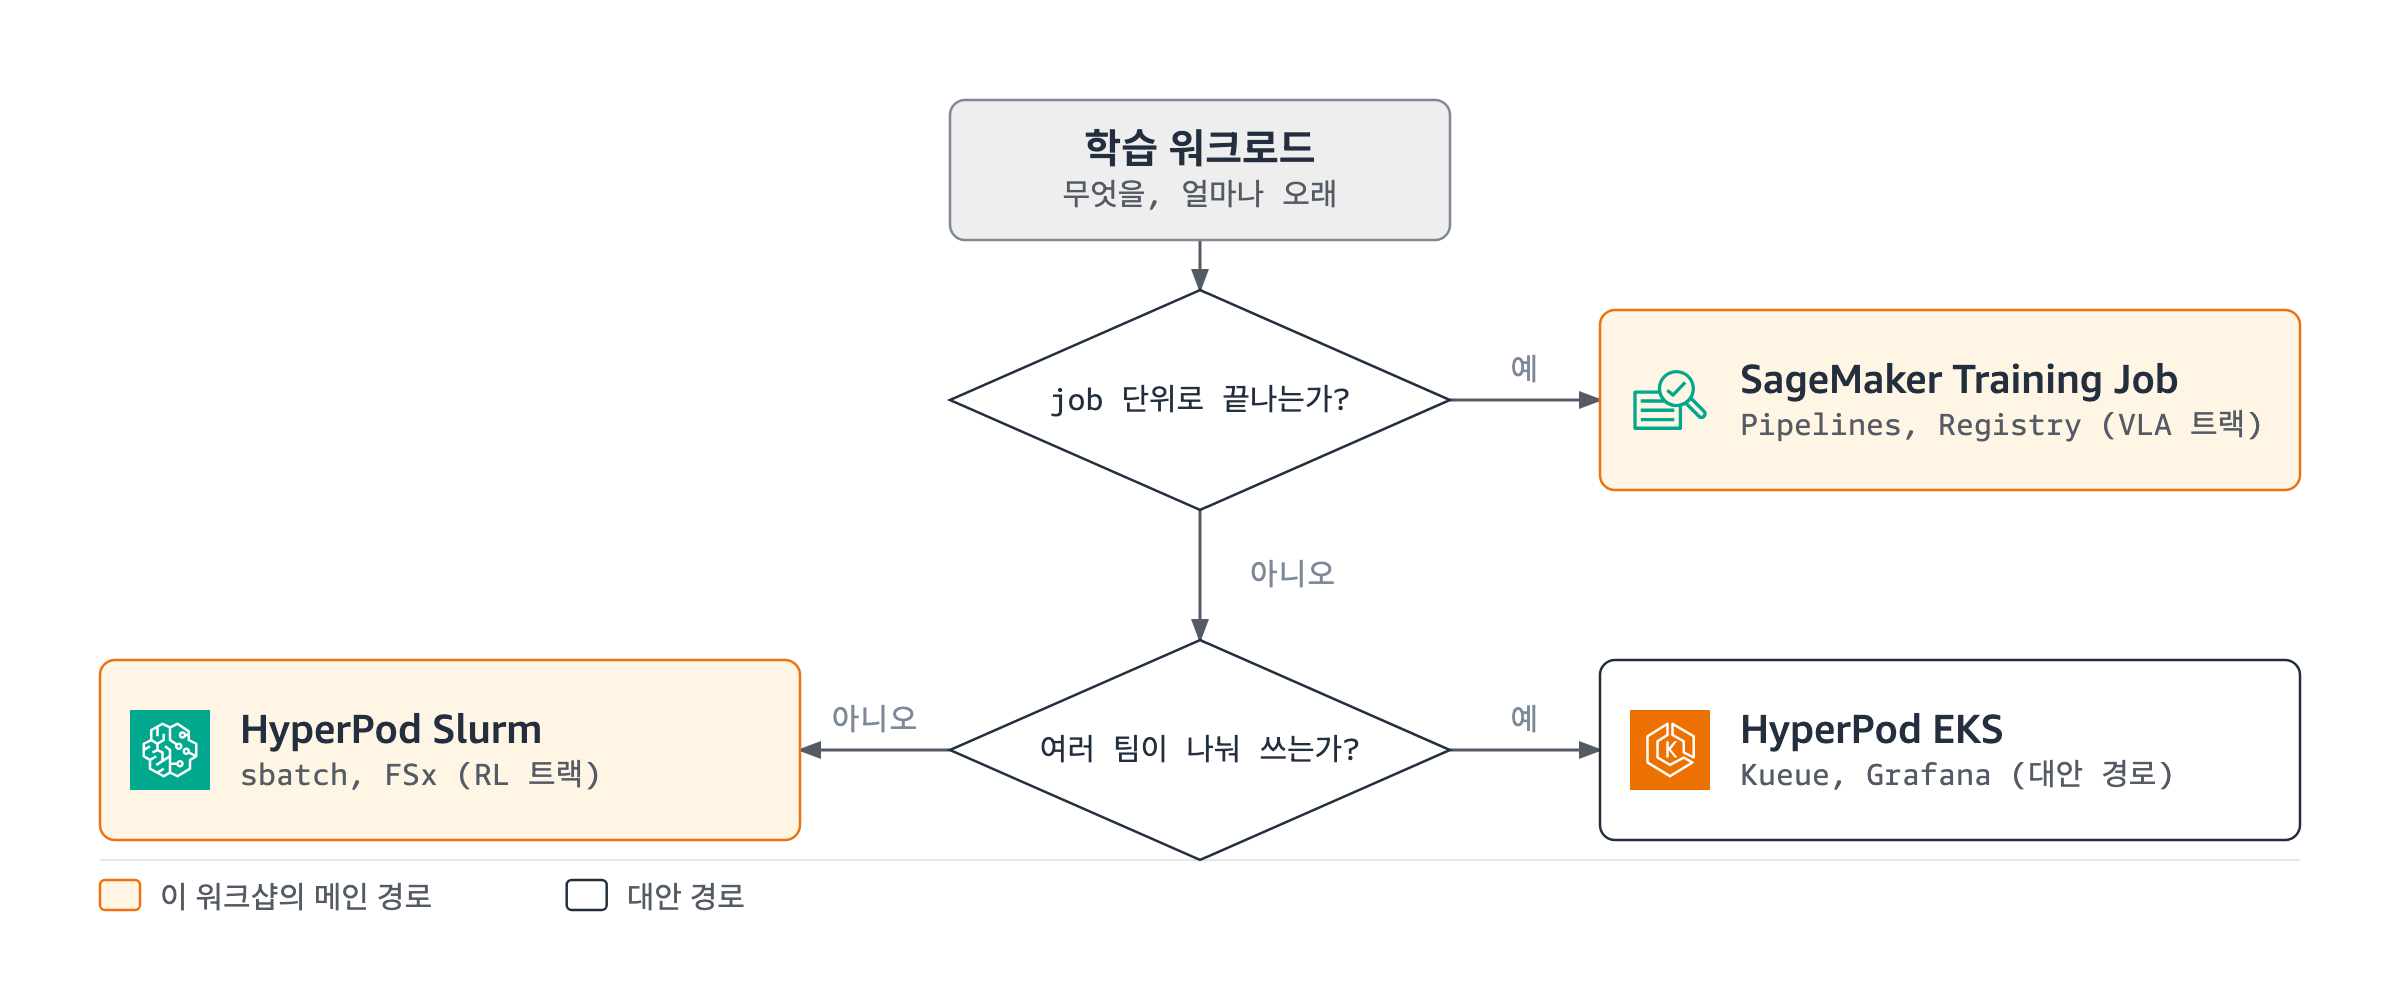
그림 7. 학습 성격에 따른 SageMaker AI 인프라 선택
정리하면, job 단위로 시작하고 끝나는 학습이면 SageMaker Training Job과 Pipelines를, 수일에서 수주 동안 환경을 유지하며 실험을 반복하면 HyperPod를 고르고, HyperPod 안에서는 팀 규모와 운영 요구에 따라 Slurm과 EKS를 나눕니다.
| 기준 | SageMaker AI Training Job | SageMaker HyperPod |
|---|---|---|
| 작업 방식 | 입력 데이터와 코드로 개별 작업 실행 | 공유 환경에서 여러 실험 운영 |
| 인스턴스 수명 | 작업 실행에 맞춰 준비·종료 | 클러스터·노드 그룹 단위로 관리 |
| 자원 조절 | 작업에 인스턴스 유형과 수 지정 | 운영 정책에 따라 노드 수 조절 |
| 작업 종료 후 | 학습 인스턴스 종료; 저장소 등은 별도 | 유지한 노드와 스토리지 비용 지속 |
표 1. 이 워크숍에서 비교하는 학습 환경의 운영 방식
3. 전체 인프라 아키텍처
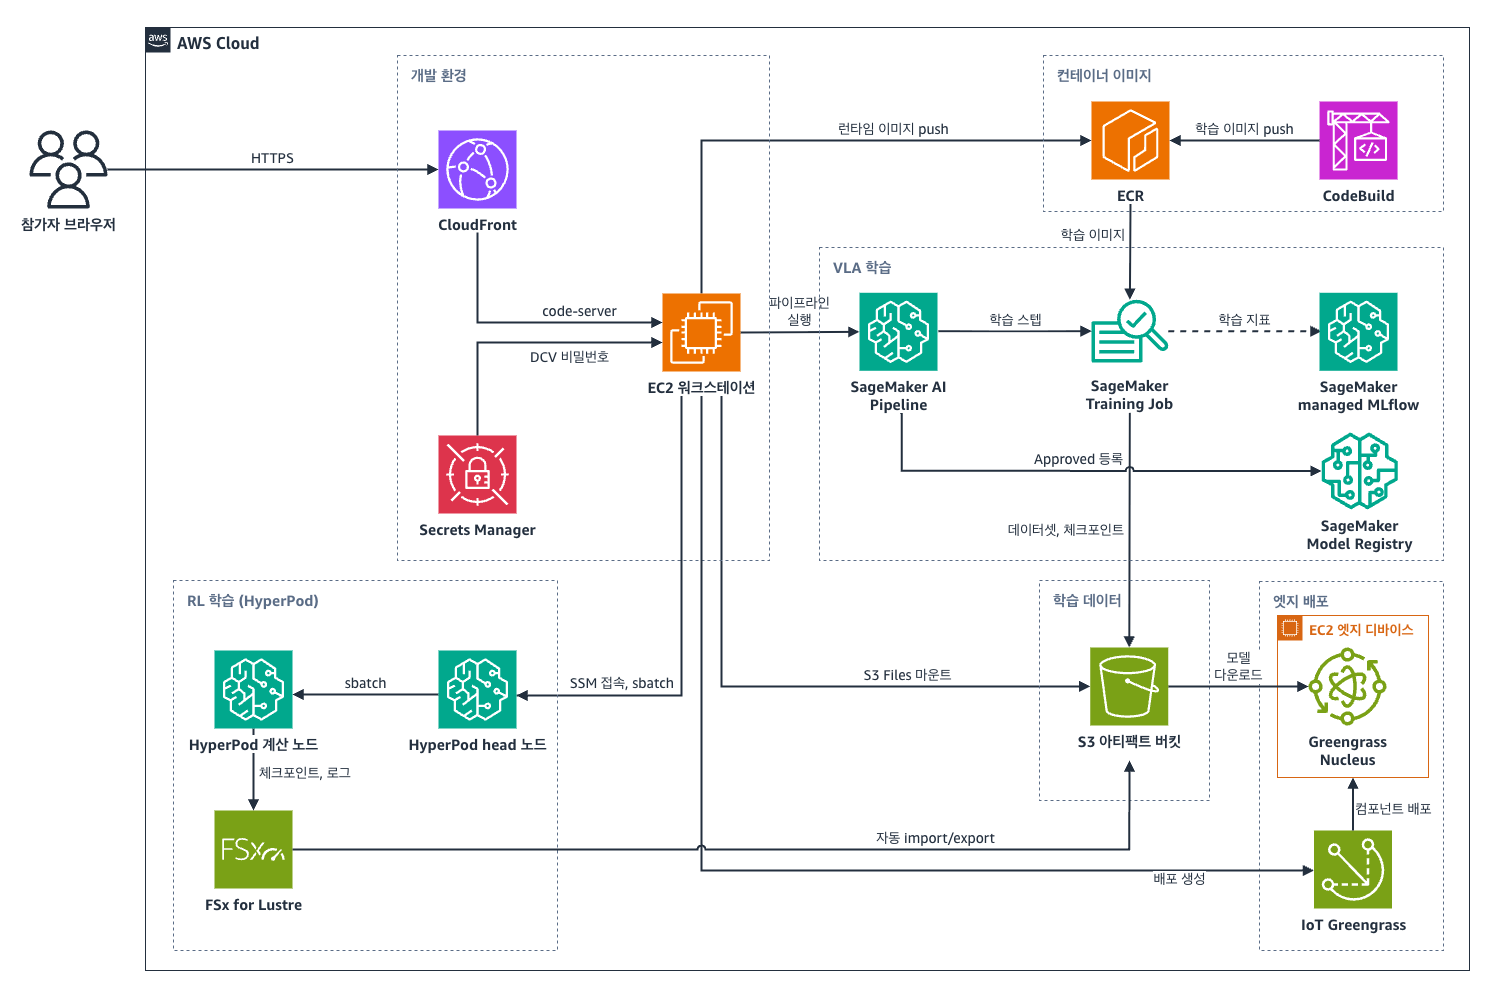
그림 8. 공통 워크스테이션과 S3를 중심으로 VLA 학습, 엣지 배포, HyperPod 학습을 연결한 전체 구성
실험을 위한 워크스테이션
공통 워크스테이션과 네트워크는 IsaacLab 스택이, VLA 학습 이미지와 SageMaker 리소스는 GrootFinetune 스택이 생성합니다. AWS CodeBuild는 GR00T 런타임 이미지와 학습 이미지를 빌드해 Amazon Elastic Container Registry(Amazon ECR)에 저장합니다.
워크스테이션은 Amazon EC2 인스턴스로, 원격 데스크톱 Amazon DCV와 브라우저 코드 편집기 code-server가 올라가 있어, 참가자는 브라우저 하나로 Isaac Sim 화면을 보고 파이프라인을 실행합니다. Amazon CloudFront가 code-server 앞에서 HTTPS를 제공하고, AWS Secrets Manager가 DCV와 code-server 비밀번호를 생성해 보관합니다.
학습 데이터를 저장하는 스토리지
S3를 데이터셋과 학습 산출물의 공통 저장소로 사용합니다. 데이터셋을 S3에 올리면 SageMaker AI가 학습에 쓰고, 학습 체크포인트도 S3에 쌓이며, 평가와 엣지 배포는 그 체크포인트를 S3에서 가져갑니다. 워크스테이션은 Amazon S3 Files로 아티팩트 버킷에 연결된 파일시스템을 마운트해 체크포인트에 접근합니다.
네트워크 설정 및 보안
공통 워크스테이션과 VLA 리소스는 Amazon Virtual Private Cloud(Amazon VPC)에 배치합니다. AWS Identity and Access Management(IAM) 역할로 S3, ECR, SageMaker AI 등의 접근 권한을 부여하고 노드 접속에는 AWS Systems Manager를 사용합니다. HyperPod 클러스터는 기본적으로 별도 VPC와 FSx for Lustre를 생성하며 기존 네트워크와 스토리지를 공유하는 구성은 별도 옵션으로 선택합니다.
3.1 컨테이너 빌드와 학습 실행 분리
AWS CodeBuild는 학습 및 런타임 이미지를 빌드하고Amazon Elastic Container Registry(Amazon ECR)에 저장합니다. 학습용 이미지와 추론을 위한 런타임 이미지는 패키지가 다르기에 별도의 CodeBuild를 통해 이미지를 빌드합니다. 이미지를 한번 빌드해 두면 동일한 모델을 학습할 때에 데이터셋과 학습 파라미터를 바꾸어 파이프라인을 다시 실행할 수 있습니다.
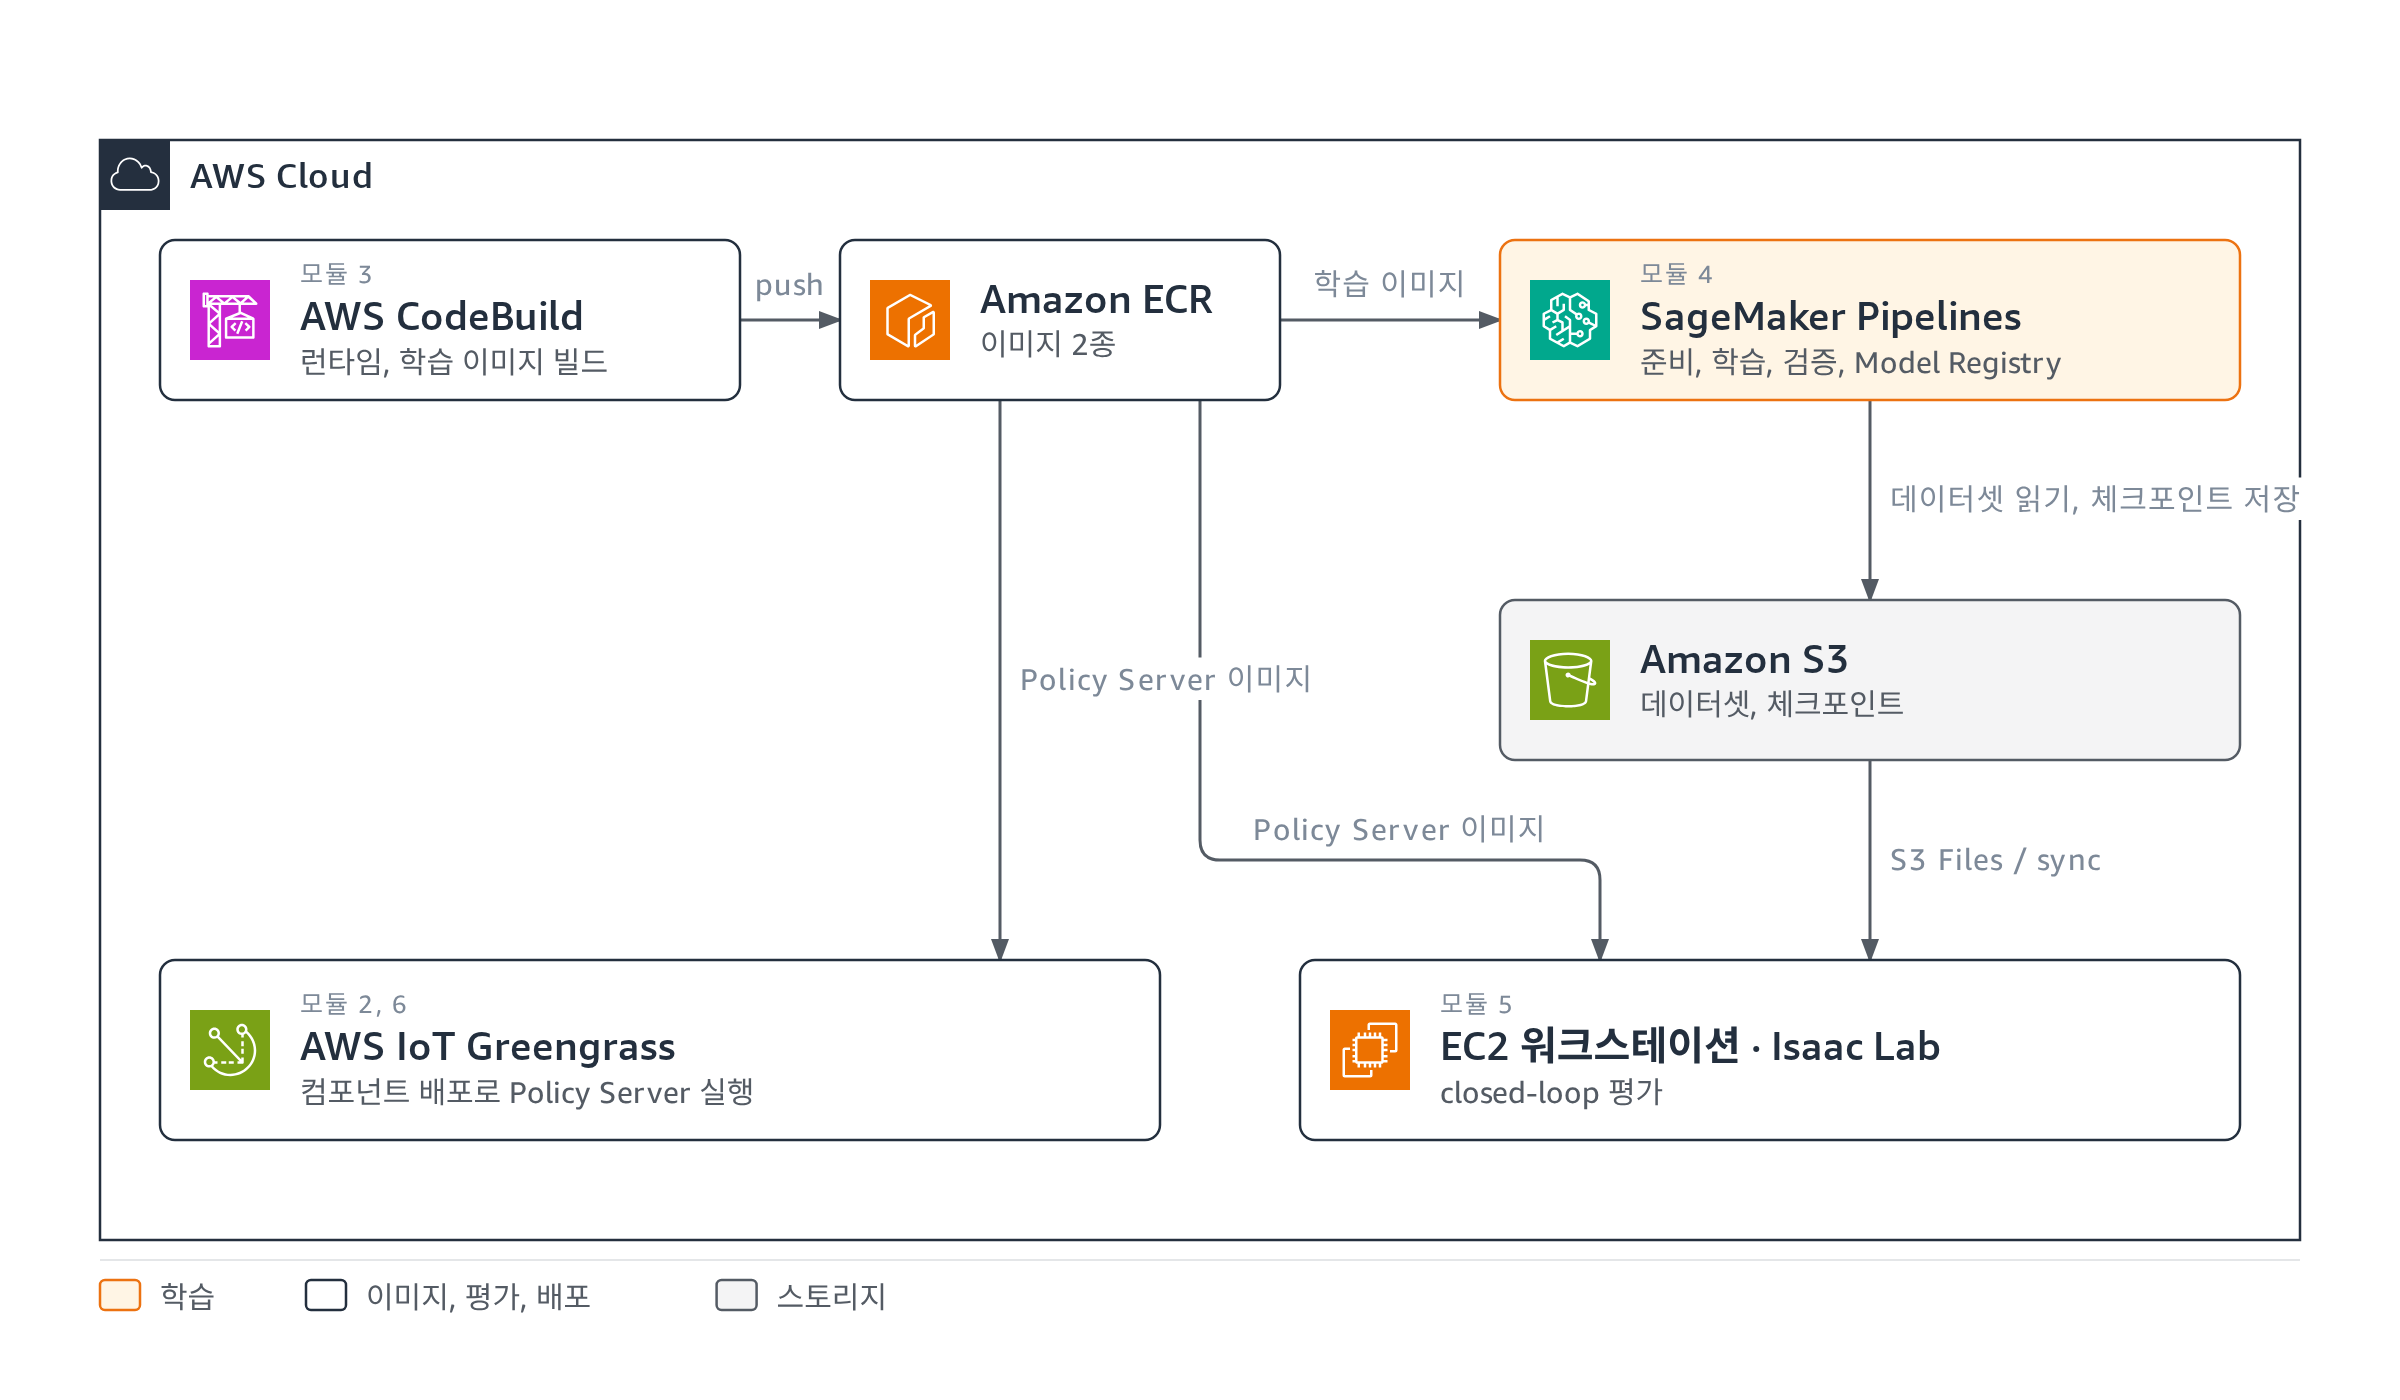
그림 9. 컨테이너 준비, VLA 학습, 시뮬레이션 평가 및 배포의 서비스 관계
Amazon SageMaker Pipelines는 준비된 이미지와 데이터로 학습 작업을 실행하고, 결과는 S3에 저장되어, 평가용 워크스테이션은 S3의 산출물을 읽어 시뮬레이션을 실행합니다.
3.2 GPU 워크스테이션과 원격 개발 환경
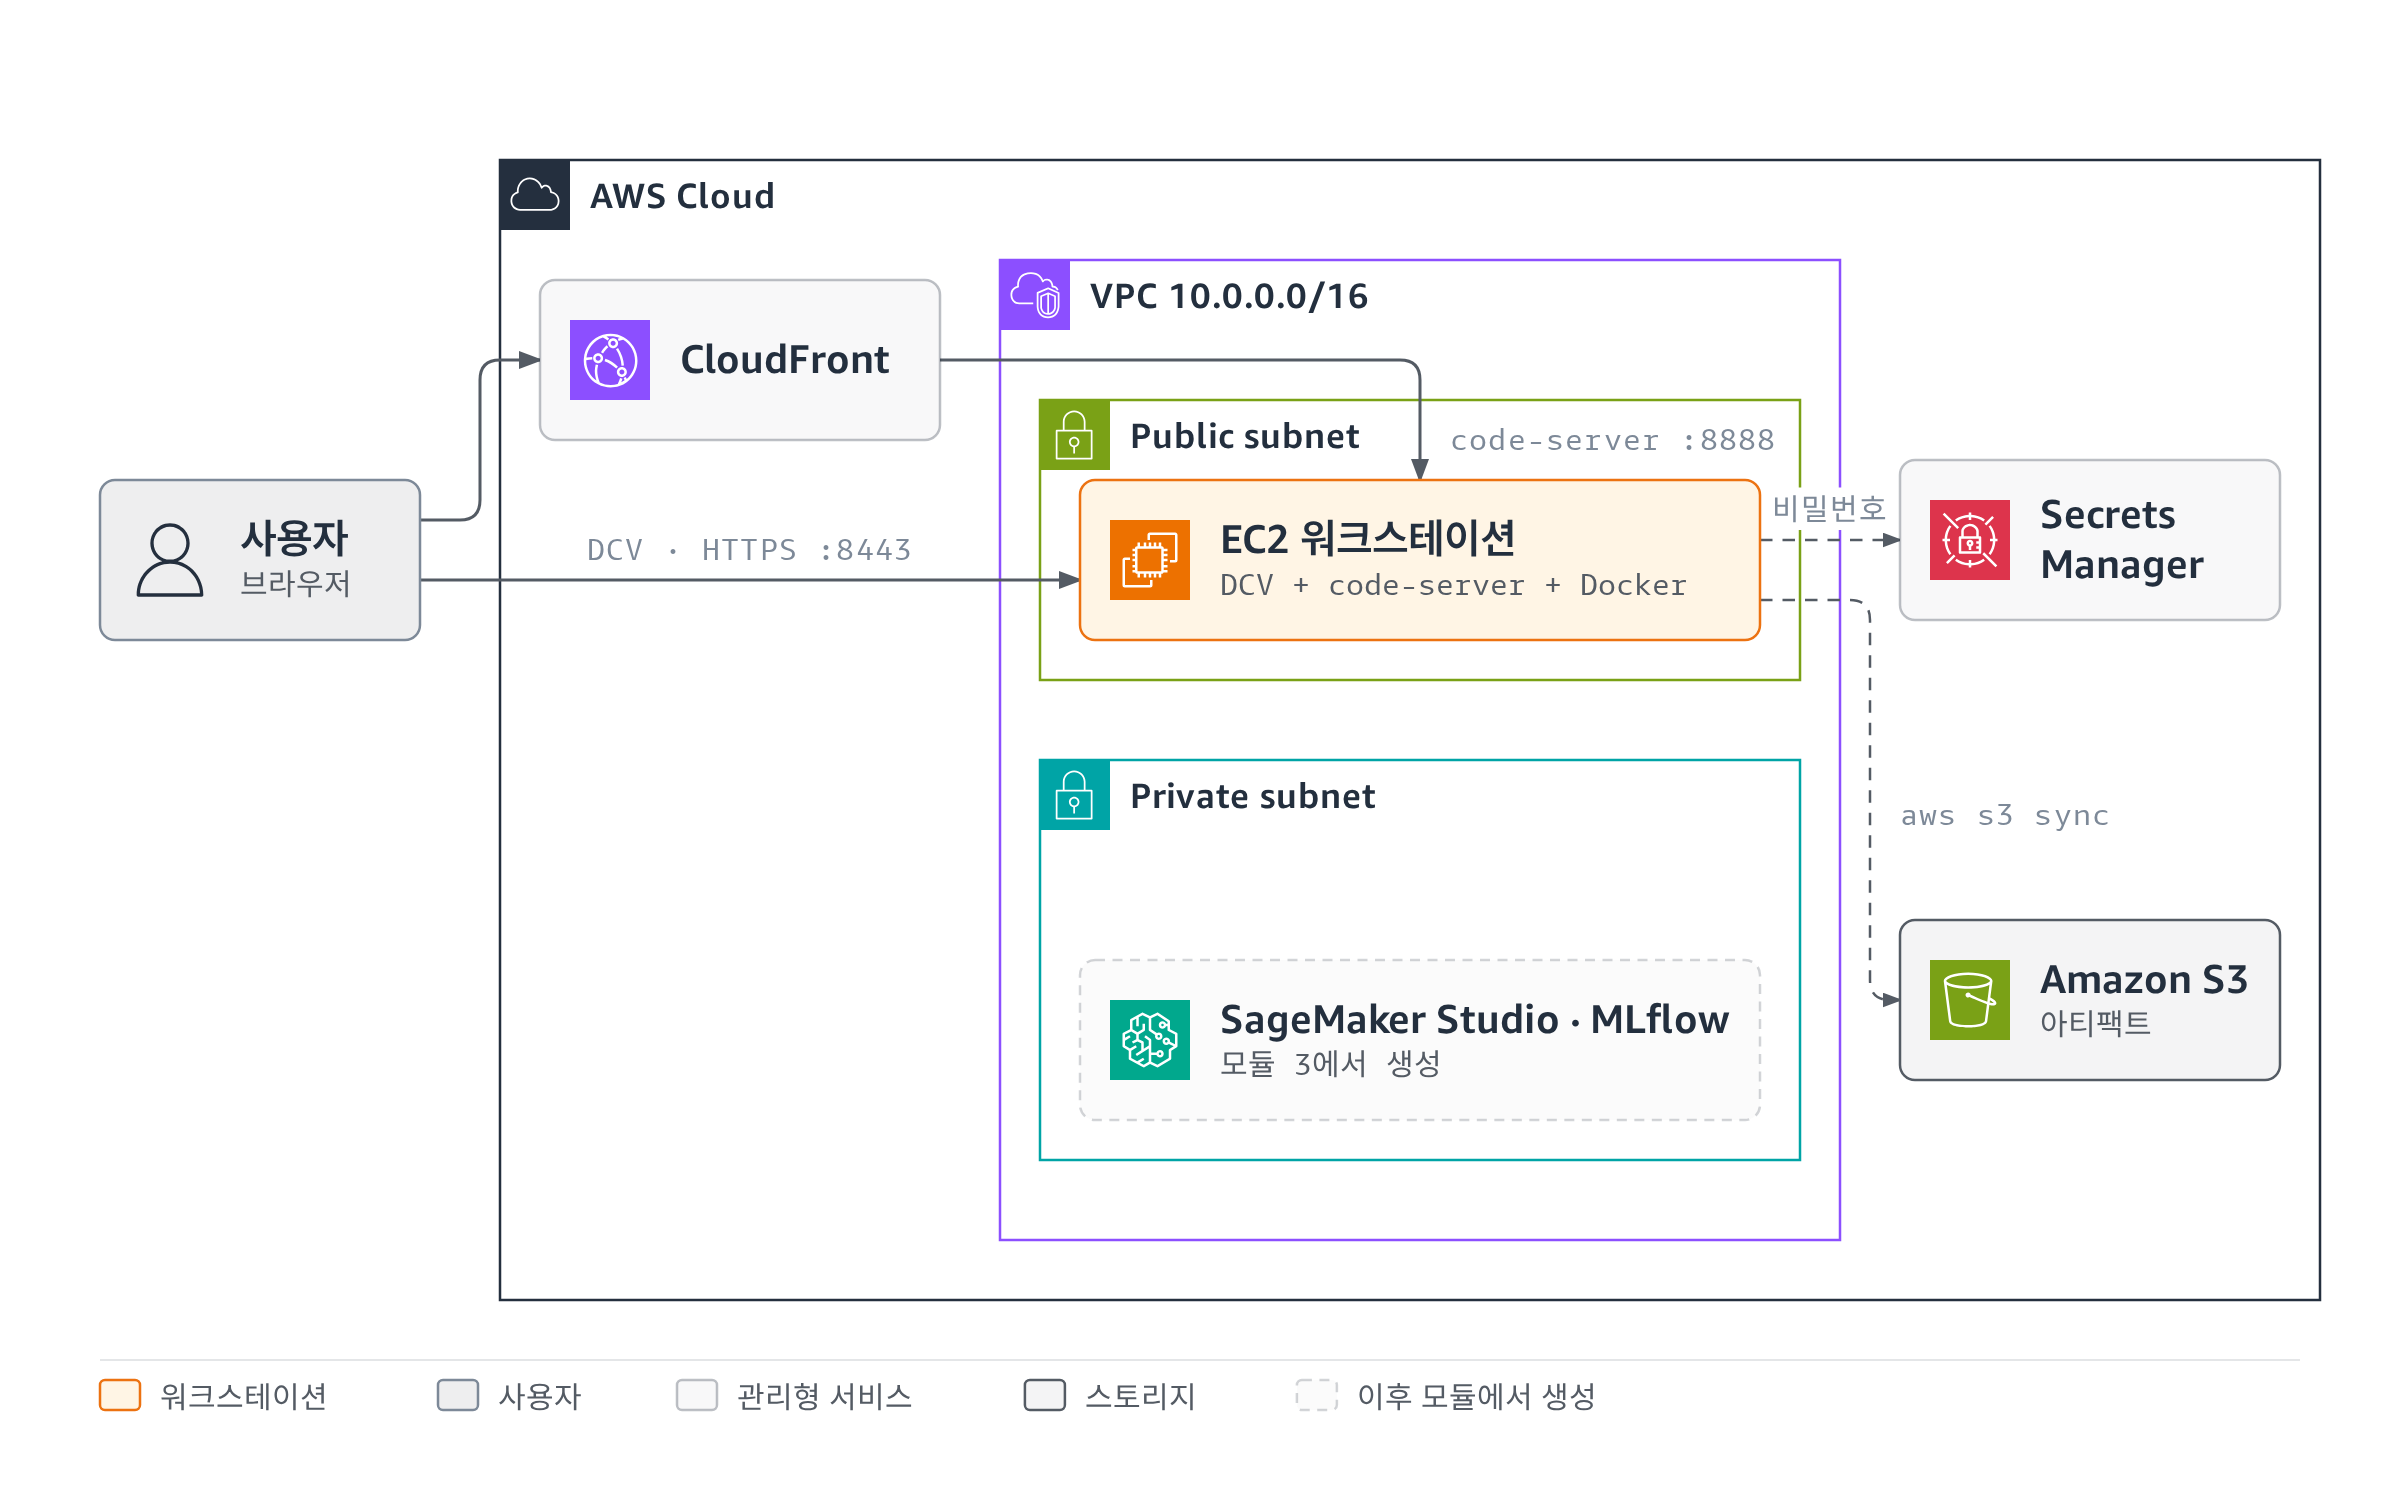
그림 10. 워크스테이션 접속 구성
실험을 위한 터미널
터미널과 노트북은 code-server(브라우저 VS Code)를 통해 사용합니다. code-server는 인스턴스에서 HTTP 8888 포트로만 리스닝하고, 그 앞의 Amazon CloudFront는 브라우저와 CloudFront 사이에 HTTPS를 제공하고 AWS Secrets Manager는 접속 비밀번호를 보관합니다.
시뮬레이션 환경 렌더링
시뮬레이션 검증을 위한 이 EC2는 실험을 위한 워크스테이션으로 Isaac Lab 시뮬레이션, GR00T Policy Server, Closed-loop 평가, 그리고 모든 명령 실행이 이루어집니다. Isaac Sim처럼 GPU 렌더링이 필요한 화면은Amazon DCV 원격 데스크탑으로 확인 가능합니다. DCV는 AWS의 고성능 원격 디스플레이 프로토콜로, GPU 가속 데스크탑을 브라우저 클라이언트에 스트리밍하고 EC2에서는 별도 라이선스가 필요하지 않습니다.
인스턴스 선택 기준
워크스테이션은 GPU 메모리 여유와 실행 구성을 고려해 L40S를 사용합니다. L40S를 고른 이유는 앞서 말한 Isaac Sim의 RTX 요구사항입니다. 일반적으로 학습에 사용하는 p 타입 인스턴스는 RT 코어가 없는 GPU (A100, H100 GPU)를 제공하여 시뮬레이션 렌더링에 쓸 수 없습니다. 그래서 학습 인스턴스와 시뮬레이션 인스턴스는 분리하여 사용합니다. 이러한 구조를 채택함으로써, 시뮬레이션 인스턴스는 항상 켜놓고, 학습 인스턴스는 job이 있을 때만 실행시키는 형태로 비용 효율적으로 활용할 수 있습니다.
네트워크와 스토리지 구성
네트워크는 Amazon Virtual Private Cloud(Amazon VPC) 하나입니다. 공통 VPC의 퍼블릭 서브넷에는 워크스테이션과 NAT 게이트웨이를, 프라이빗 서브넷에는 Amazon SageMaker Studio와 S3 Files 마운트 타깃을 둡니다. 프라이빗 리소스는 NAT 게이트웨이로 PyPI와 Hugging Face에 접근하고 S3 통신에는 게이트웨이 엔드포인트를 사용하여, 인터넷을 거치지 않도록 구성합니다.
학습 산출물은 모두 Amazon S3에 저장됩니다. 데이터셋을 S3에 올리면 SageMaker AI가 학습에 사용하고, 학습이 완료된 후의 체크포인트도 S3에 저장된 후, 평가와 엣지 배포 시에는S3에 저장된 체크포인트를 가져갑니다. 워크스테이션은 이 버킷을 내려받는 대신 Amazon S3 Files로 NFS 마운트합니다.
3.3 서비스별 선택 이유 요약
| 서비스 | 워크샵에서의 역할 | 선택 이유 |
|---|---|---|
| Amazon EC2 G6e + Amazon DCV | 시뮬레이션과 평가를 실행하는 GPU 워크스테이션 | Isaac Sim은 RTX 계열 GPU가 필요하고, GPU 렌더링 화면을 브라우저로 스트리밍해야 함 |
| Amazon CloudFront | code-server의 HTTPS 프록시 | 인스턴스에 인증서를 두지 않고 브라우저 구간 TLS 확보 |
| Amazon SageMaker AI (Training Job, Pipelines) | GR00T fine-tuning 파이프라인 | job이 끝나면 인스턴스를 반납하는 단발성 학습에 맞고, 데이터 준비부터 등록까지 한 정의로 반복 실행 |
| Amazon SageMaker AI의 관리형 MLflow, Model Registry | 실험 추적과 모델 버전 관리 | 추적 서버를 직접 운영하지 않고 run을 비교하고, Approved 상태로 게이트 통과 모델만 관리 |
| Amazon SageMaker HyperPod | RL 학습 클러스터 | 장기 반복 실험에 맞는 클러스터 모델, 노드 헬스체크와 교체, Slurm 또는 EKS 오케스트레이션 |
| Amazon FSx for Lustre | HyperPod 공유 파일시스템 | 모든 노드가 같은 경로로 체크포인트를 읽고 쓰며 S3와 자동 동기화 |
| Amazon S3, Amazon S3 Files | 데이터셋과 체크포인트의 허브, 워크스테이션 마운트 | 학습 결과를 다운로드 없이 시뮬레이터가 읽음 |
| AWS IoT Greengrass | 엣지 배포 | 컴포넌트와 배포 정의로 모델 교체를 설정 변경으로 처리 |
| Amazon ECR, AWS CodeBuild | 컨테이너 이미지 저장과 빌드 | 학습, 추론, 엣지 런타임을 같은 이미지 계열로 재현 |
| AWS CDK | 인프라 코드화 | 어느 계정에서 배포해도 같은 모양의 환경, 변경 이력이 코드에 남음 |
표 2. 워크샵이 사용하는 AWS 서비스와 선택 이유
학습, 평가, 배포에 쓰는 IAM 역할은 각 단계에 필요한 S3 경로, ECR 리포지토리, SageMaker 리소스로만 권한을 제한합니다. 노드 접속은 인바운드 포트를 열지 않고 AWS Systems Manager Session Manager로만 수행합니다.
4. VLA 트랙: GR00T fine-tuning을 SageMaker Pipelines로
4.1 전체 학습 구조
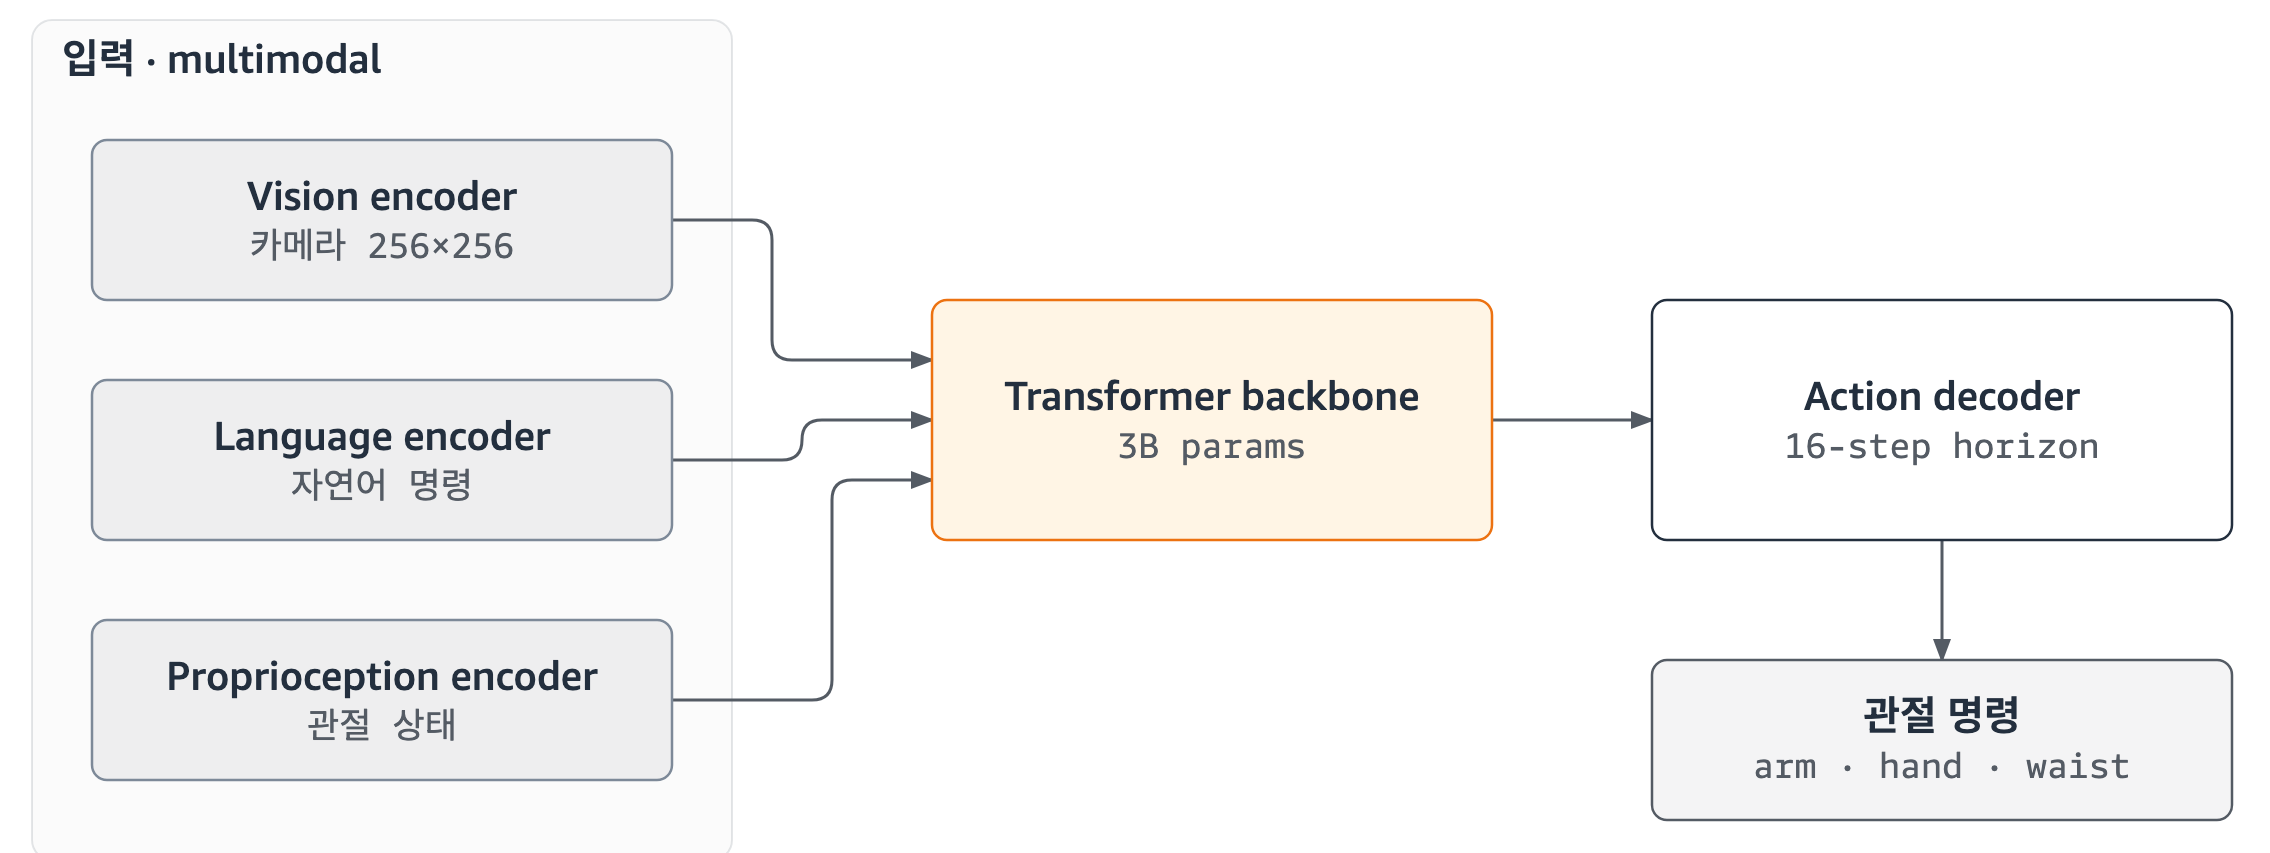
그림 11. GR00T N1 모델 구조: 카메라, 자연어 명령, 관절 상태를 받아 16-step 액션을 내는 VLA
VLA 트랙은 3B 파라미터의 NVIDIA GR00T N1.x 모델을 사용합니다. 모델은 카메라 영상, 자연어 명령, 관절 상태를 받아 행동 시퀀스를 출력하는데, 워크샵에서는 action horizon을 16으로 설정하고,이 모델을 SO-101 팔로 오렌지를 집는 LeRobot 형식 데이터셋(leisaac-pick-orange)으로 fine-tuning합니다.
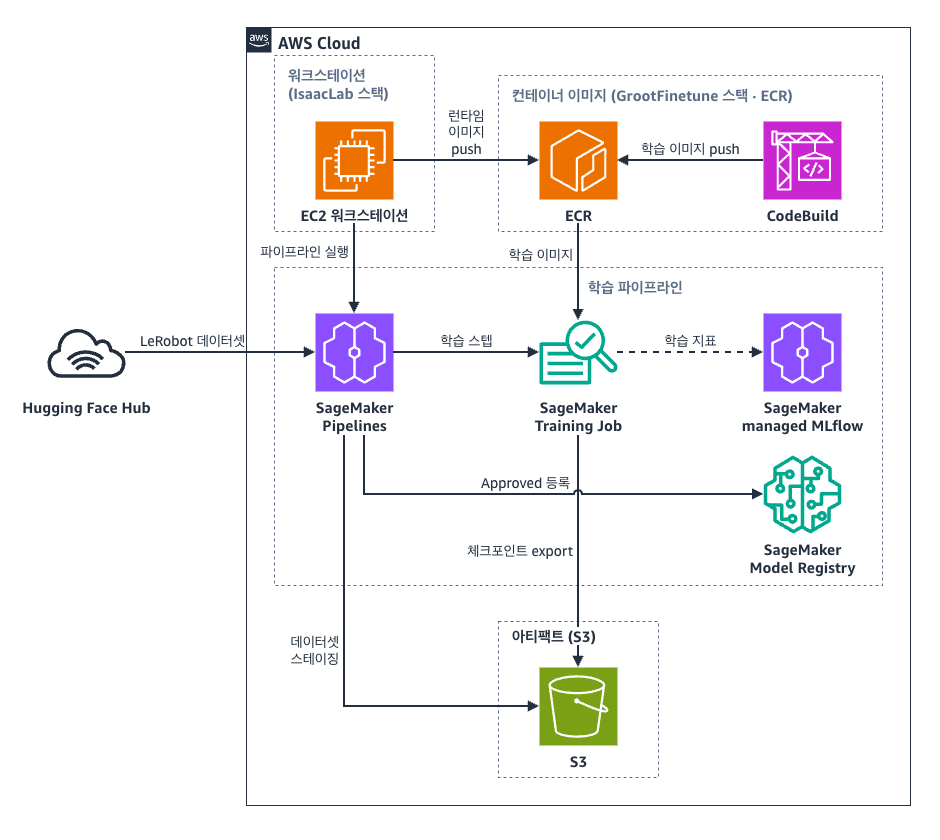
그림 12. SageMaker Pipeline으로 구성된 VLA 학습 파이프라인
CodeBuild가 빌드한 학습 이미지와 Hugging Face의 데이터셋으로 SageMaker Pipelines가 학습하고, 체크포인트는 S3에 저장하고 Amazon SageMaker AI의 관리형 MLflow에 실험 파라미터와 지표를 저장합니다. 추론 점검을 통과한 모델 버전은 Model Registry에 등록하고, 워크스테이션은 S3 Files 마운트로 그 체크포인트를 읽습니다.
4.2 데이터 검증부터 모델 등록까지
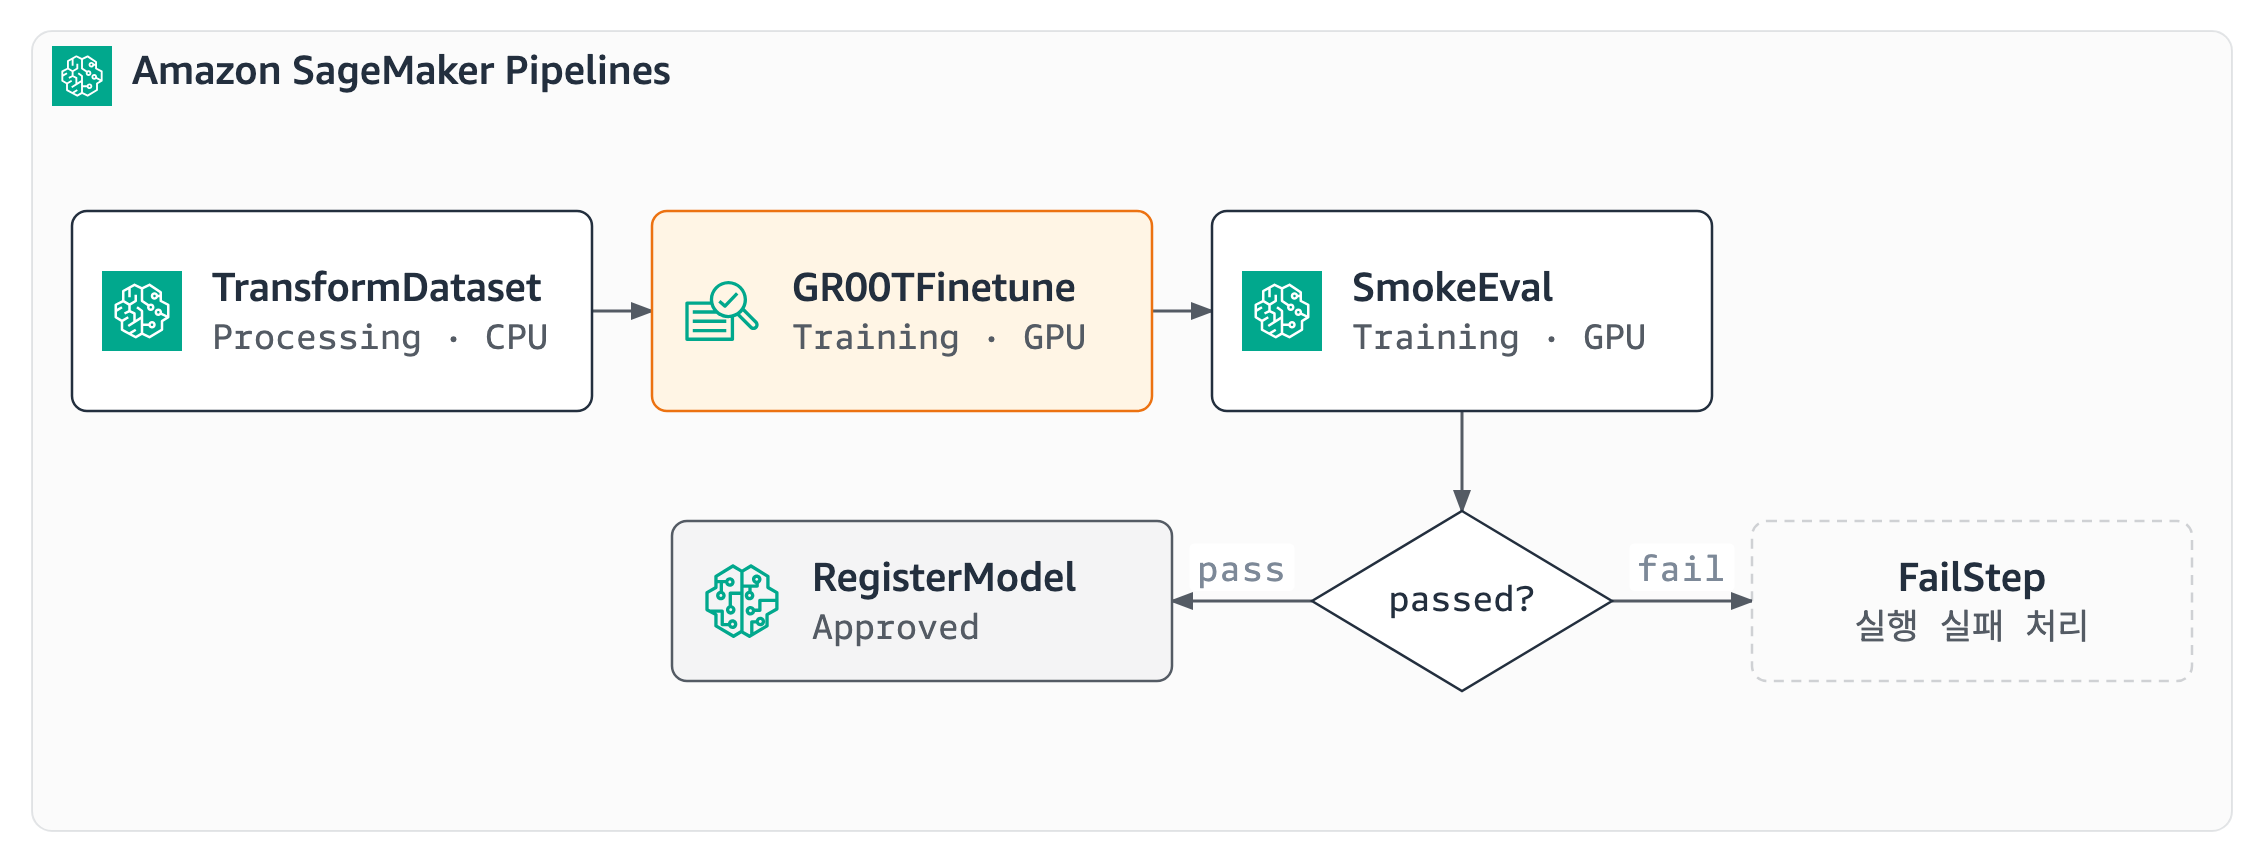
그림 13. SageMaker Pipelines 다섯 단계: 데이터 변환, 학습, 스모크 평가, 게이트, 모델 등록
SageMaker Pipelines는 데이터 변환, 학습, 스모크 평가, 조건 분기, 모델 등록의 다섯 논리 단계로 구성합니다. fine-tuning 자체는 Training Job 하나로도 가능하지만, 파이프라인을 구성하는 이유는 데이터 준비, 학습, 검증, 모델 등록을 한 번 정의해 두고 파라미터만 바꿔 재실행하기 위함입니다. 데이터셋이나 하이퍼파라미터를 바꾸는 실험에서 인프라와 코드를 변경하지 않고도 같은 작업을 반복할 수 있습니다.
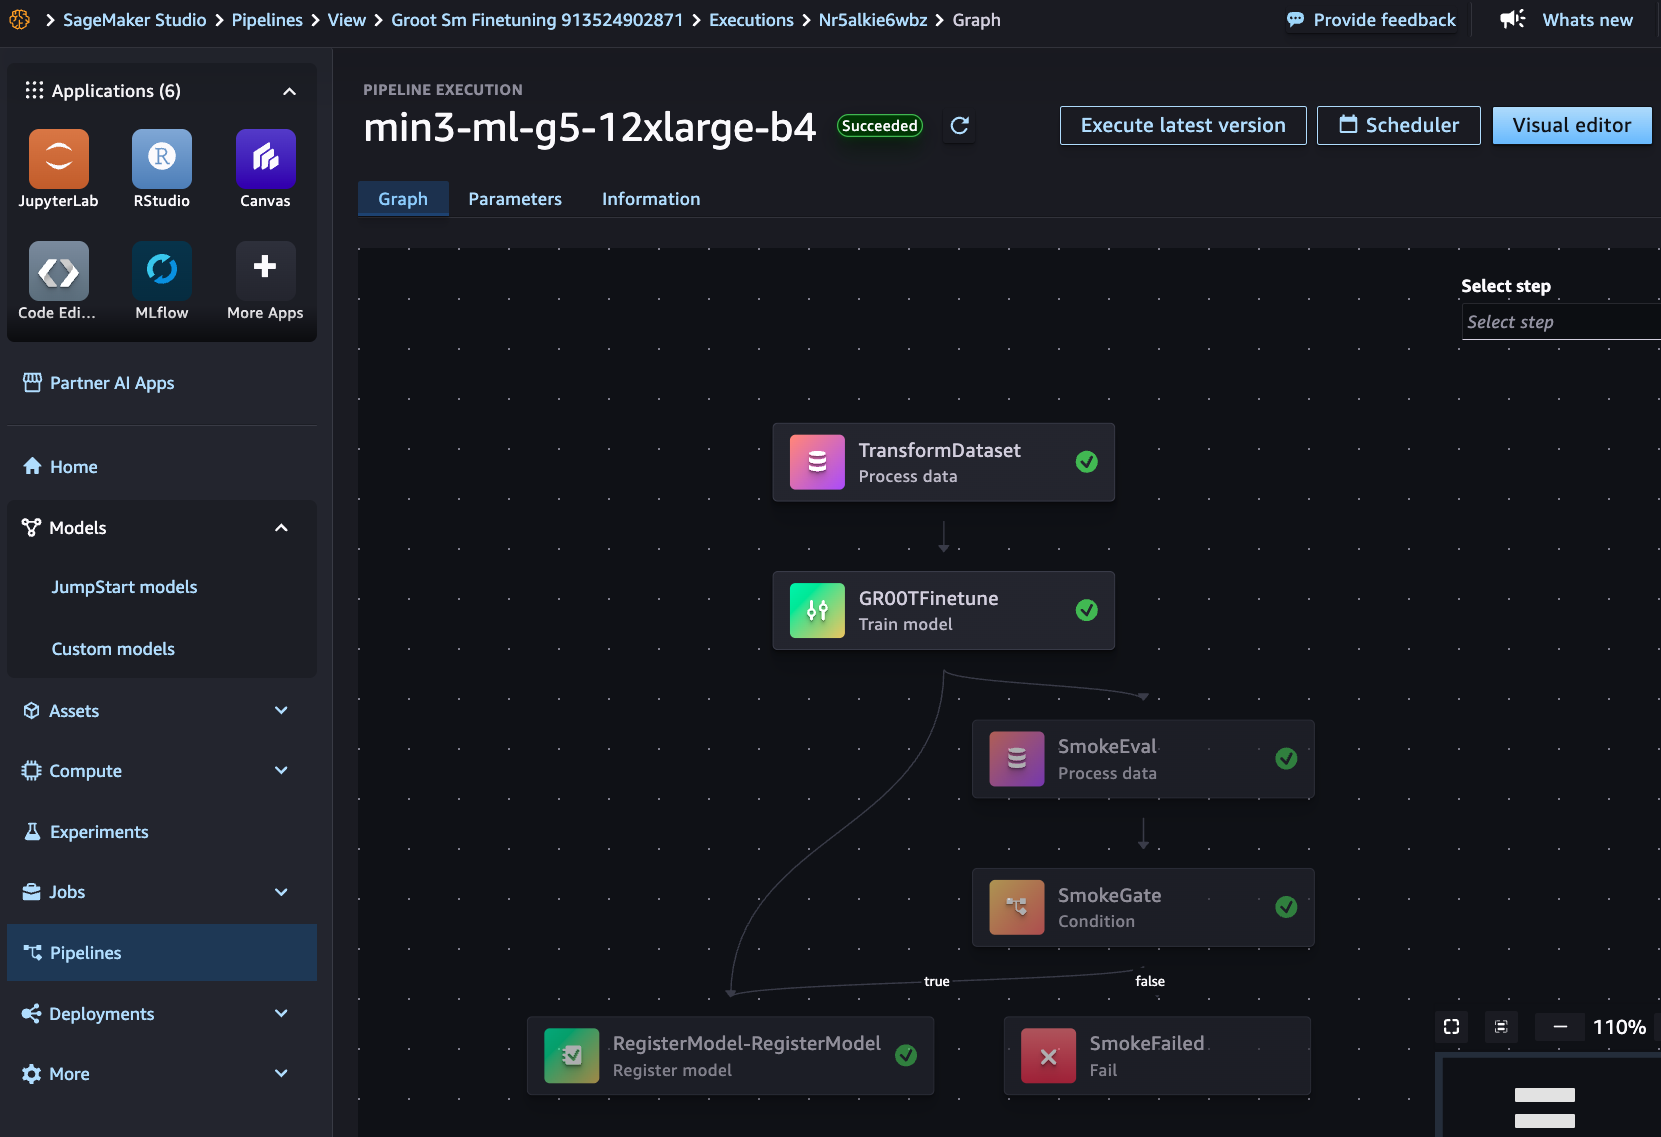
그림 14. SageMaker Studio의 파이프라인 실행 그래프
- TransformDataset: 학습을 위한 LeRobot 데이터셋을 내려받고 LeRobot v3 형식이면 v2.1로 변환하는 ProcessingStep입니다. 필수 메타데이터와 파일 구조를 검사한 뒤 S3에 저장하며 기본 개인 계정 구성에서는 CPU 인스턴스를 사용합니다. 같은 데이터셋으로 다시 실행하면 Pipelines의 스텝 캐시가 이 단계를 건너뛰어서 비용과 시간을 절약할 수 있습니다. 워크샵은 캐시 유효 기간을 30일로 두었습니다.
- GR00TFinetune: GPU 인스턴스의 Training 스텝입니다. 학습 컨테이너로 GR00T 모델 fine-tuning 을 수행합니다. 학습이 중단되면 같은 실행 ID의 체크포인트 경로에서 자동으로 재개하고, 학습이 완료되면 S3에 직접 export 합니다.
- SmokeEval: 학습된 체크포인트를 시뮬레이션에서 짧게 평가합니다. 체크포인트를 오프라인으로 로드해 유효한 action이 나오는지 확인합니다.
- SmokeGate: 평가를 통과하면 등록으로 넘어가고, 실패하면 FailStep이 실행을 실패로 끝내는 컨디션 스텝입니다.
- RegisterModel: SmokeGate를 통과한 모델만 Amazon SageMaker Model Registry의 모델 패키지 그룹에 Approved 상태로 등록합니다.
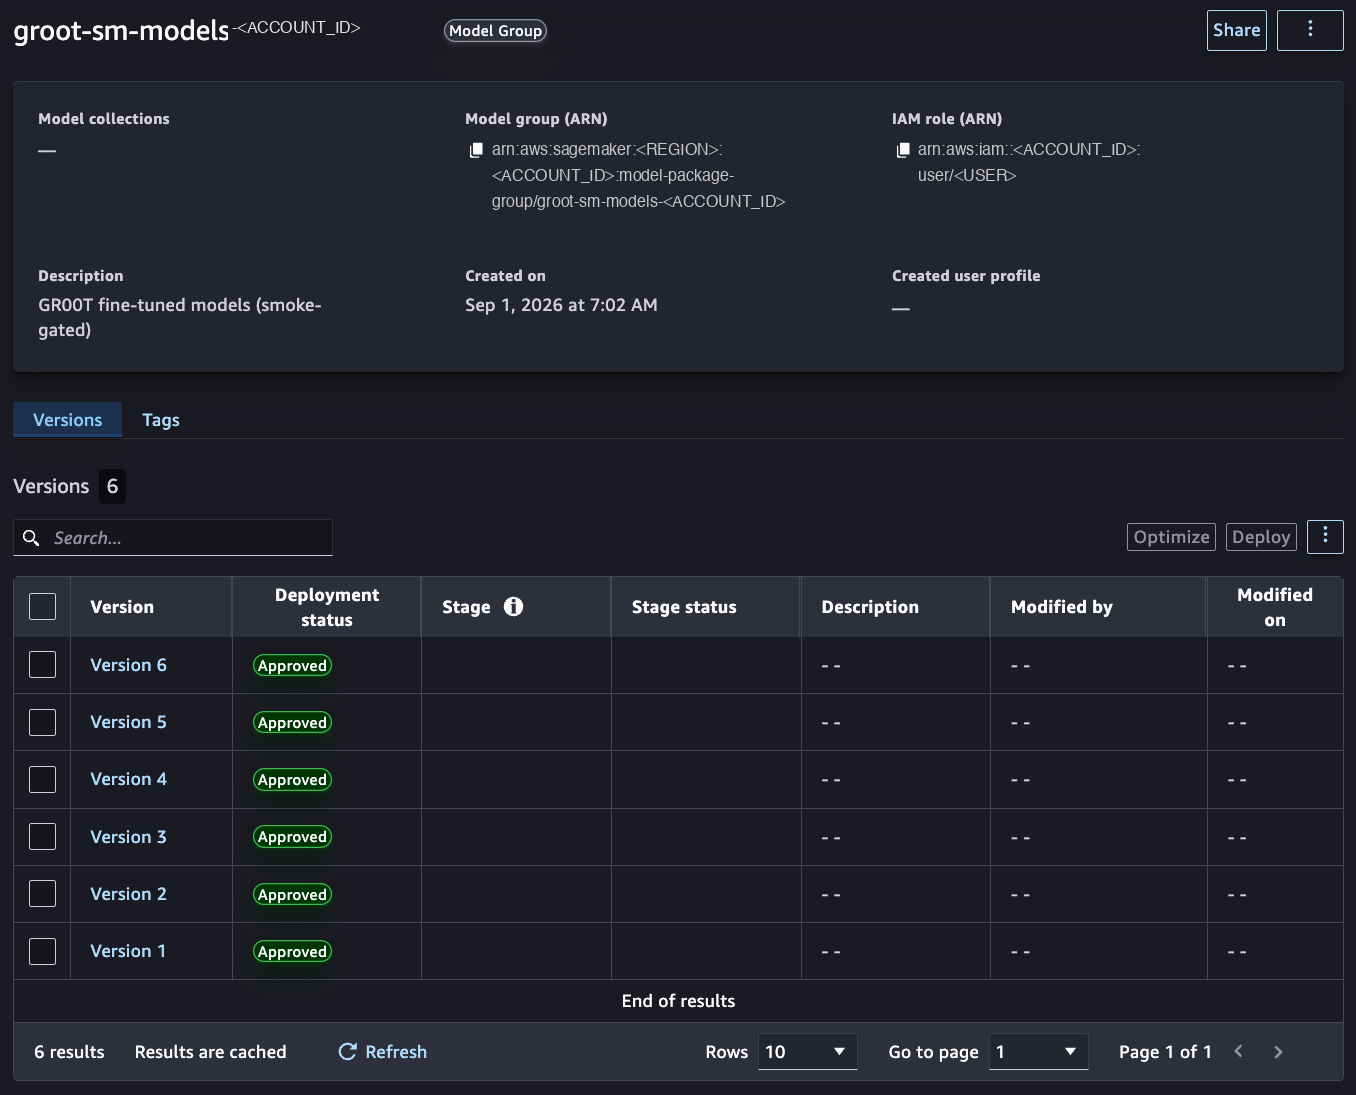
그림 15. SageMaker Model Registry의 모델 패키지 그룹과 Approved 상태의 버전 목록
실험의 파라미터와 학습 지표는 Training Job이 Amazon SageMaker AI의 관리형 MLflow에 기록하고, 표준 출력은 Amazon CloudWatch Logs에 남습니다. 참가자는 실험 추적 서버를 따로 설치하지 않고 run을 비교합니다.
5. 시뮬레이션 Closed-loop 평가: 학습이 끝난 자리에서 바로 검증
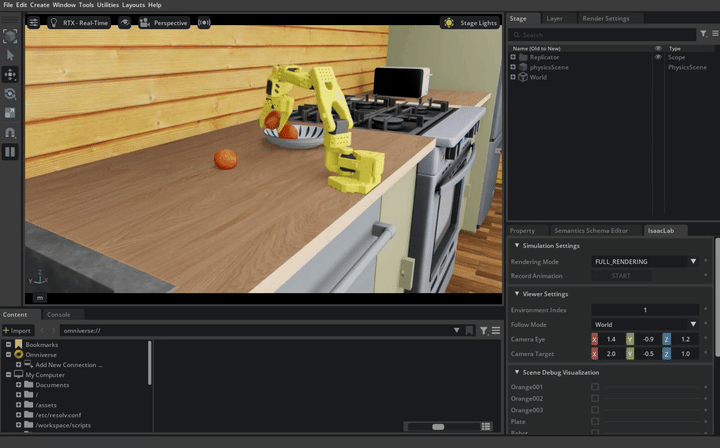
그림 16. DCV 데스크탑에서 본 Isaac Sim 창. fine-tuning한 GR00T 모델이 SO-101 팔로 오렌지를 집는 Closed-loop 평가 장면
SmokeEval은 짧은 스모크 테스트입니다. 모델이 실제로 오렌지를 집는지는 모듈 5에서 워크스테이션의 Isaac Lab 폐루프(closed-loop) 평가로 확인합니다. 학습이 완료되면 워크스테이션의 Isaac Lab 위에서 실제 씬을 돌려 태스크 성공률을 측정하여 Closed-loop 평가로 확인합니다.
시뮬레이션 평가를 클라우드 학습과 엣지 배포 사이에 두는 이유는 세 가지입니다. 실제 로봇을 건드리기 전에 모델 품질을 숫자로 확인하고, 성공률이 낮으면 다시 학습 단계로 돌아가 파라미터를 바꿔 재학습하는 반복 루프를 만들며, 시뮬레이션에서 실패한 모델을 엣지로 보내지 않기 위해서입니다.
5.1 S3 Files을 통해 평가용 체크포인트 로드
평가에 쓸 체크포인트를 워크스테이션으로 가져오는 방법은 세 가지입니다.
- Amazon S3 Files로 아티팩트 버킷을 /mnt/s3/groot에 마운트해 그대로 가리키는 방법
- aws s3 sync로 로컬 디스크에 다운로드 받는 방법
- 학습을 건너뛰고 Hugging Face에 공개된 fine-tuned 체크포인트를 내려받는 방법
워크샵에서는S3 Files로 워크스테이션에서 마운트 하는 방법을 안내합니다. S3 Files는 S3 버킷에 연결된 공유 파일시스템으로, 파일을 읽을 때 내용을 필요한 만큼만 고성능 스토리지에 올리고, 1 MiB 이상의 큰 읽기는 고성능 스토리지에 있어도 S3에서 직접 스트리밍합니다. 읽기 처리량은 연결된 인스턴스 수와 인스턴스 안의 병렬도에 따라 늘어나고, 클라이언트당 최대 읽기 처리량은 3 GiB/s입니다. 워크샵 실측으로는 단일 스트림 읽기 약 140MB/s, 8개 병렬 스트림에서 약 760MB/s가 나왔고, Policy Server가 6.5GB 체크포인트를 여는 데 약 30초가 걸렸습니다(로컬 디스크는 몇 초).
한 번 쓰고 끝나는 평가에서는 수 분의 다운로드를 아끼기 위해 이러한 방법을 사용할 수 있고, 같은 체크포인트를 반복해서 열거나 대역폭 제약이 있으면 로컬 복사가 낫습니다. 마운트는 ubuntu 사용자에게 읽기 전용으로 보이므로 평가가 아티팩트 버킷을 손상시킬 수 없습니다.
5.2 평가를 위한 Policy Server와 시뮬레이터
이 평가는 DCV 데스크탑 세션에서 실행합니다. SSH 터미널만으로는 Isaac Sim의 렌더링 파이프라인이 동작하지 않기 때문입니다. 평가에는 세 프로세스가 동시에 실행됩니다.
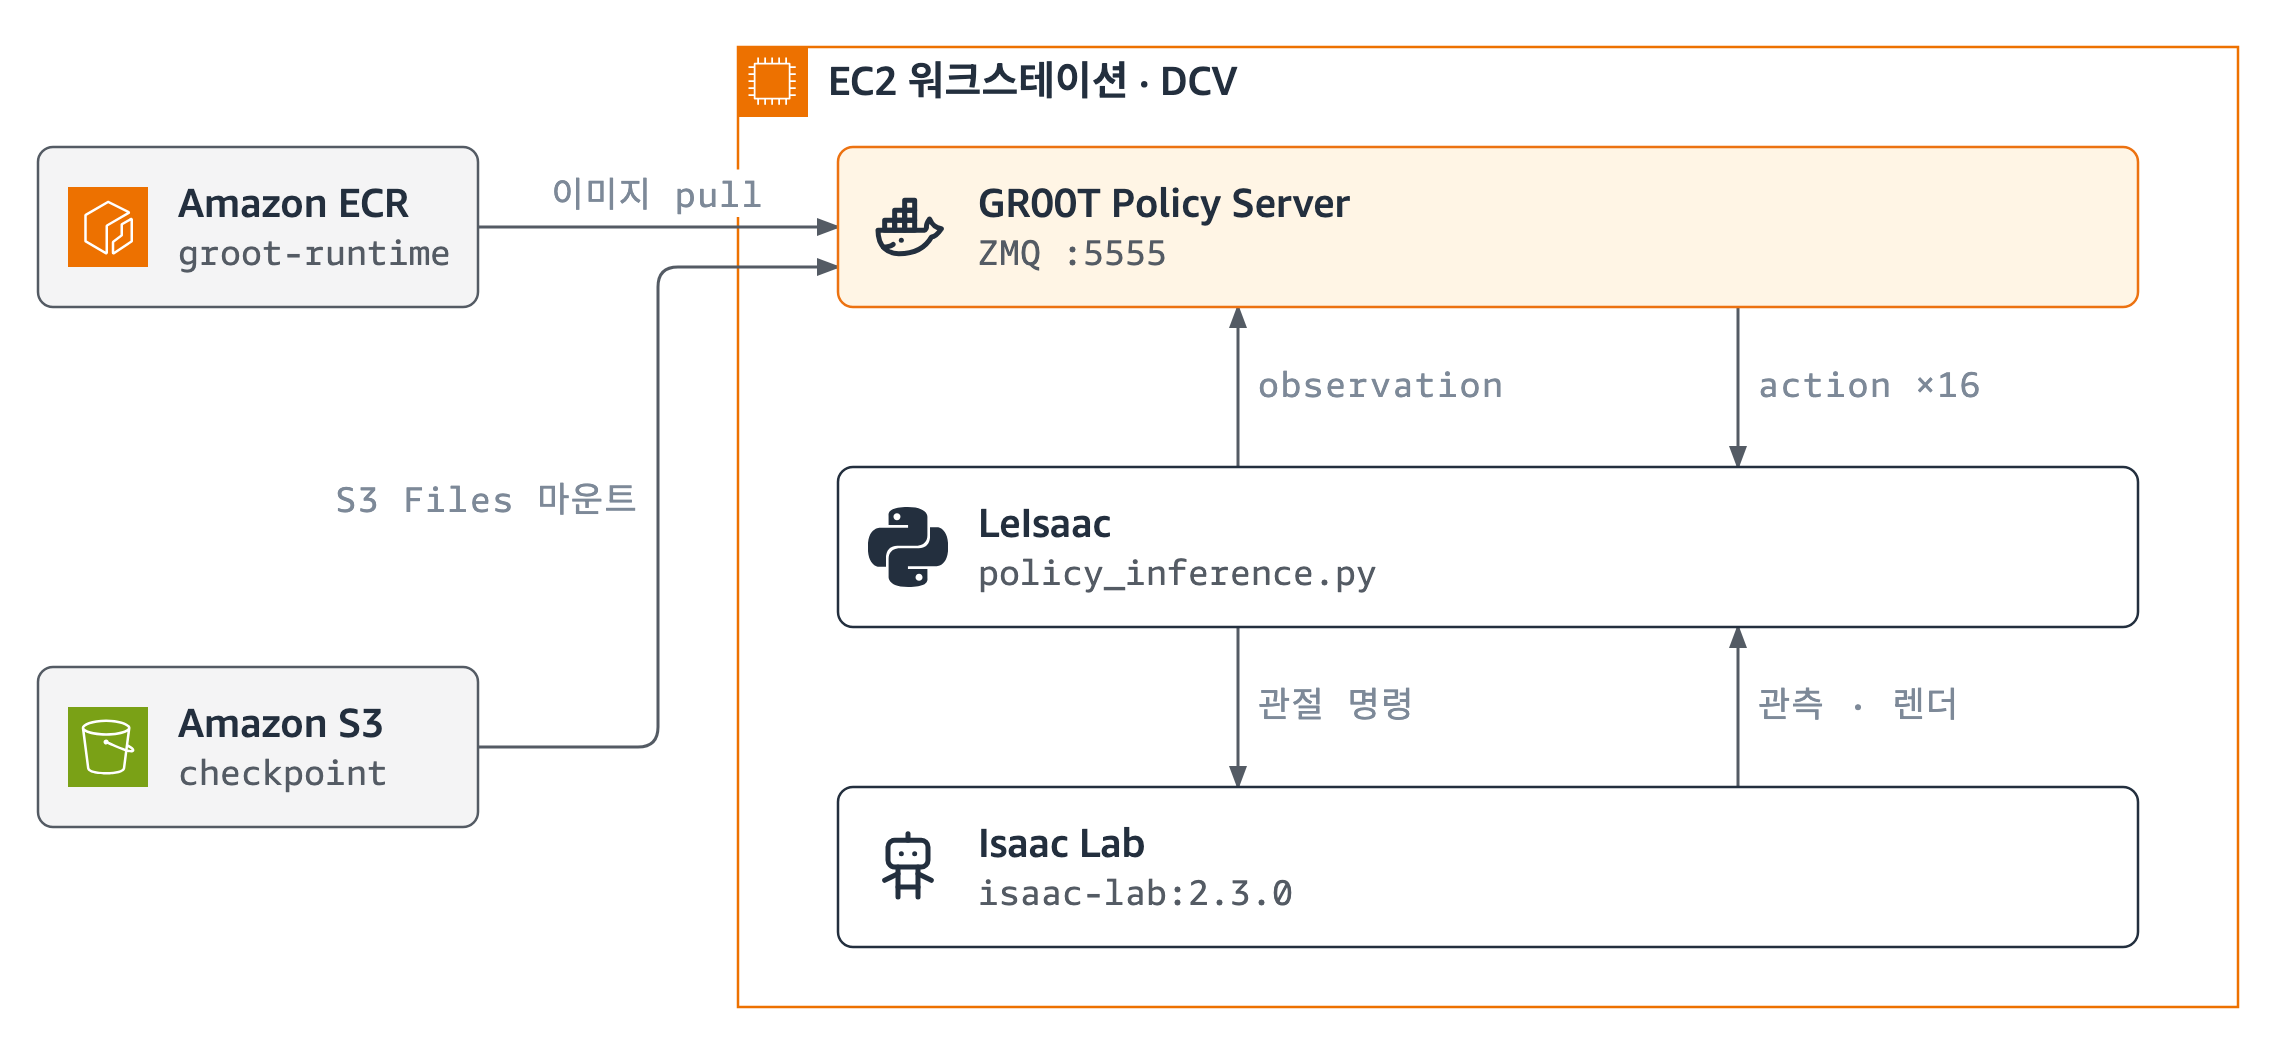
그림 17. Closed-loop 평가 구성
- GR00T Policy Server는 ECR의 런타임 이미지로 뜨고, S3 Files로 마운트한 체크포인트를 읽어 ZMQ 포트 5555에서 요청을 기다립니다.
- LeIsaac은 Isaac Lab 위에서 Closed-loop 평가를 조율하는 오픈소스 도구로, 카메라와 관절 상태를 읽어 Policy Server에 보내고 16 스텝 액션을 받아 Isaac Lab에 적용합니다.
- Isaac Lab은 주방 씬에서 SO-101 팔의 물리와 렌더링을 담당합니다.
Policy Server와 시뮬레이터는 프로세스로 분리됩니다. GR00T 저장소의 서버는 ZeroMQ REP 소켓을 5555 포트에 바인딩하고 msgpack으로 관측과 액션을 주고받는 동기 REQ/REP 패턴입니다. NVIDIA가 이렇게 분리한 1차 이유는 GR00T와 시뮬레이터의 파이썬 의존성이 한 환경에서 충돌하기 때문이고, 더 나아가 원격 추론까지 지원하기 위함입니다.
워크샵은 두 컨테이너를 –network host로 띄워 localhost:5555로 통신시키며, Policy Server가 약 8GB, Isaac Lab이 약 10GB의 GPU 메모리를 쓰므로 48GB L40S 한 장에서 함께 돕니다. base 모델과 fine-tuned 모델의 비교는 Policy Server의 체크포인트 경로만 바꿔 같은 구성에서 수행합니다.
6. 엣지 배포: AWS IoT Greengrass 컴포넌트와 TensorRT
로봇 제어 모델은 엣지에서 추론해야 합니다. 카메라 프레임마다 클라우드를 왕복하면 지연이 쌓이고, 네트워크가 끊기면 로봇이 멈추기 때문입니다. AWS IoT Greengrass를 활용하면 클라우드에서 학습한 모델을 엣지에 손쉽게 배포할 수 있습니다. 학습한 모델과 추론 서버를 Greengrass 컴포넌트로 정의해 두면, 디바이스 fleet에 같은 배포를 반복할 수 있고 모델 교체가 필요한 경우에는 배포 구성에서 모델 경로만 바꾸면 됩니다. 컴포넌트를 한 번 선언해 두면 디바이스가 스스로 내려받아 설치하고 실행하며, 프로세스가 죽으면 다시 띄우고 로그를 모아 줍니다.
AWS IoT Greengrass는 컴포넌트를 배포 단위로 씁니다. 컴포넌트는 recipe(메타데이터, 설정 파라미터, 의존성, lifecycle)와 artifact(스크립트, 바이너리, S3에 둔 파일)로 정의하고, 배포(deployment)로 디바이스 그룹에 내려보냅니다.
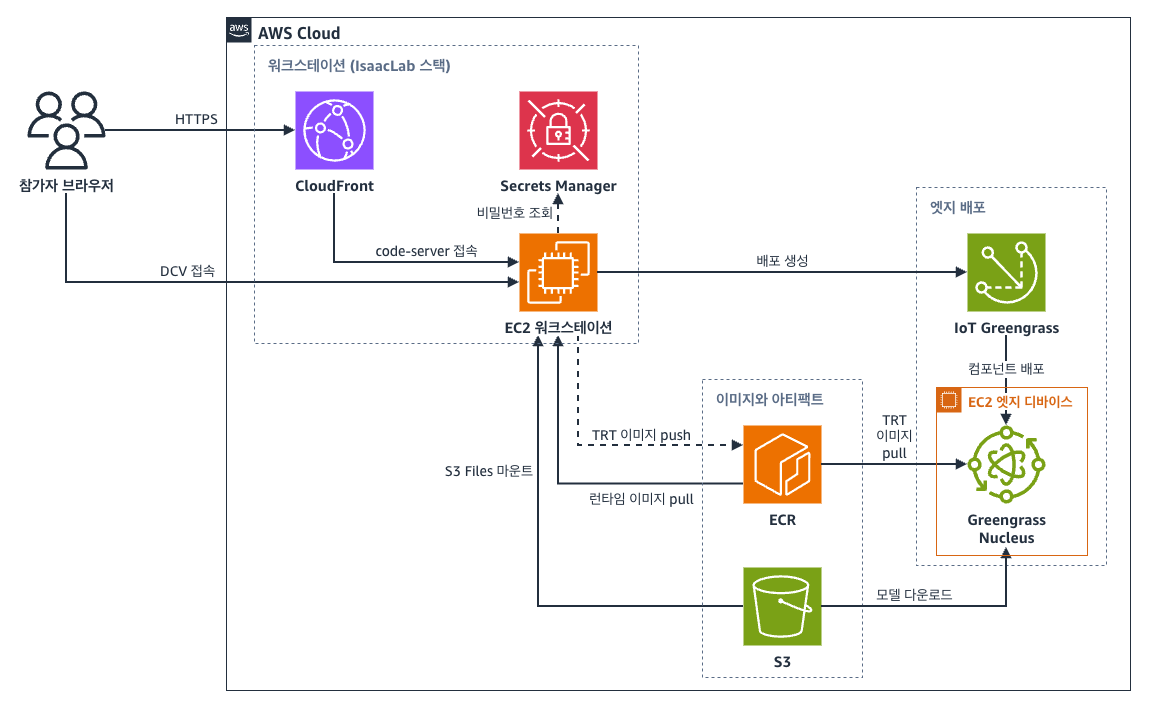
그림 18. Greengrass 엣지 배포 구성
위 그림은 엣지 배포 아키텍처입니다. AWS IoT Core가 배포를 전달하고, 디바이스가 ECR 이미지와 S3 모델을 직접 가져옵니다. Greengrass 배포는 아래 세 컴포넌트를 디바이스에 내립니다.
- setup 컴포넌트: 모델을 받아 ONNX로 내보내고 TensorRT 엔진을 빌드합니다.
- inference 컴포넌트: Policy Server를 띄워 ZMQ 포트 5555에서 요청을 받습니다.
- benchmark 컴포넌트: PyTorch 추론과 TensorRT 추론의 지연을 비교합니다.
디바이스에서는 Greengrass Nucleus 2.17.0이 이 컴포넌트를 실행합니다. 컴포넌트 로그는 LogManager 컴포넌트가 Amazon CloudWatch Logs로 올립니다.
TensorRT 최적화는 모델의 어느 부분을 컴파일하는지가 결과를 정합니다. GR00T N1.6에서는 DiT action head만 TensorRT 엔진(약 2.1GB)으로 빌드하고 백본 VLM은 PyTorch로 둡니다. N1.7은 백본까지 전체 파이프라인을 가속합니다. 워크샵이 측정한 N1.6의 추론 지연은 표 3과 같습니다.
| GPU | TensorRT 적용 전 | DiT action head TensorRT 적용 후 | 개선 |
|---|---|---|---|
| L40S | 126ms | 60ms | 2.1배 |
| Thor | 156.3ms | 124.4ms | 1.26배 |
표 3. GR00T N1.6 추론 지연 측정값
표의 L40S는 서버급 GPU(EC2 워크스테이션)이고 Thor는 엣지 디바이스(NVIDIA Jetson Thor)로 장치 클래스가 다릅니다. 서버 GPU 수치는 엣지 배포 전 TensorRT 최적화 효과를 확인하기 위한 참고치이며, 실제 로봇에 탑재되는 추론 지연은 엣지 디바이스(Thor) 기준으로 해석해야 합니다.
Greengrass 코어 디바이스는 AWS IoT에 X.509 인증서로 등록되며, 디바이스별 인증서와 IoT 정책으로 배포 수신 범위를 제한합니다. 디바이스가 ECR 이미지와 S3 모델을 가져올 때는 Token Exchange Role을 사용하며, 이 역할의 권한을 필요한 리포지토리와 버킷 경로로만 한정합니다.
7. RL 트랙: SageMaker HyperPod Slurm 클러스터
7.1 단일 노드에서 IsaacLab의 RL 학습
시뮬레이션 환경에서 RL 학습을 확인하기 위해 워크스테이션 GPU 한 장으로 Isaac Lab 강화학습을 먼저 돌려 봅니다. Isaac Sim 5.1.0, Isaac Lab 2.3.2, skrl 2.1.0 컨테이너에서 Unitree H1 휴머노이드 보행 태스크를 2,048개 환경으로 72,000 timestep 학습하면 L4 기준 약 50분이 걸리고 GPU 메모리는 약 5GB를 씁니다. Isaac Lab이 수천 개 환경을 단일 GPU에서 병렬 실행할 수 있는 이유는 PhysX 5의 GPU 파이프라인입니다.
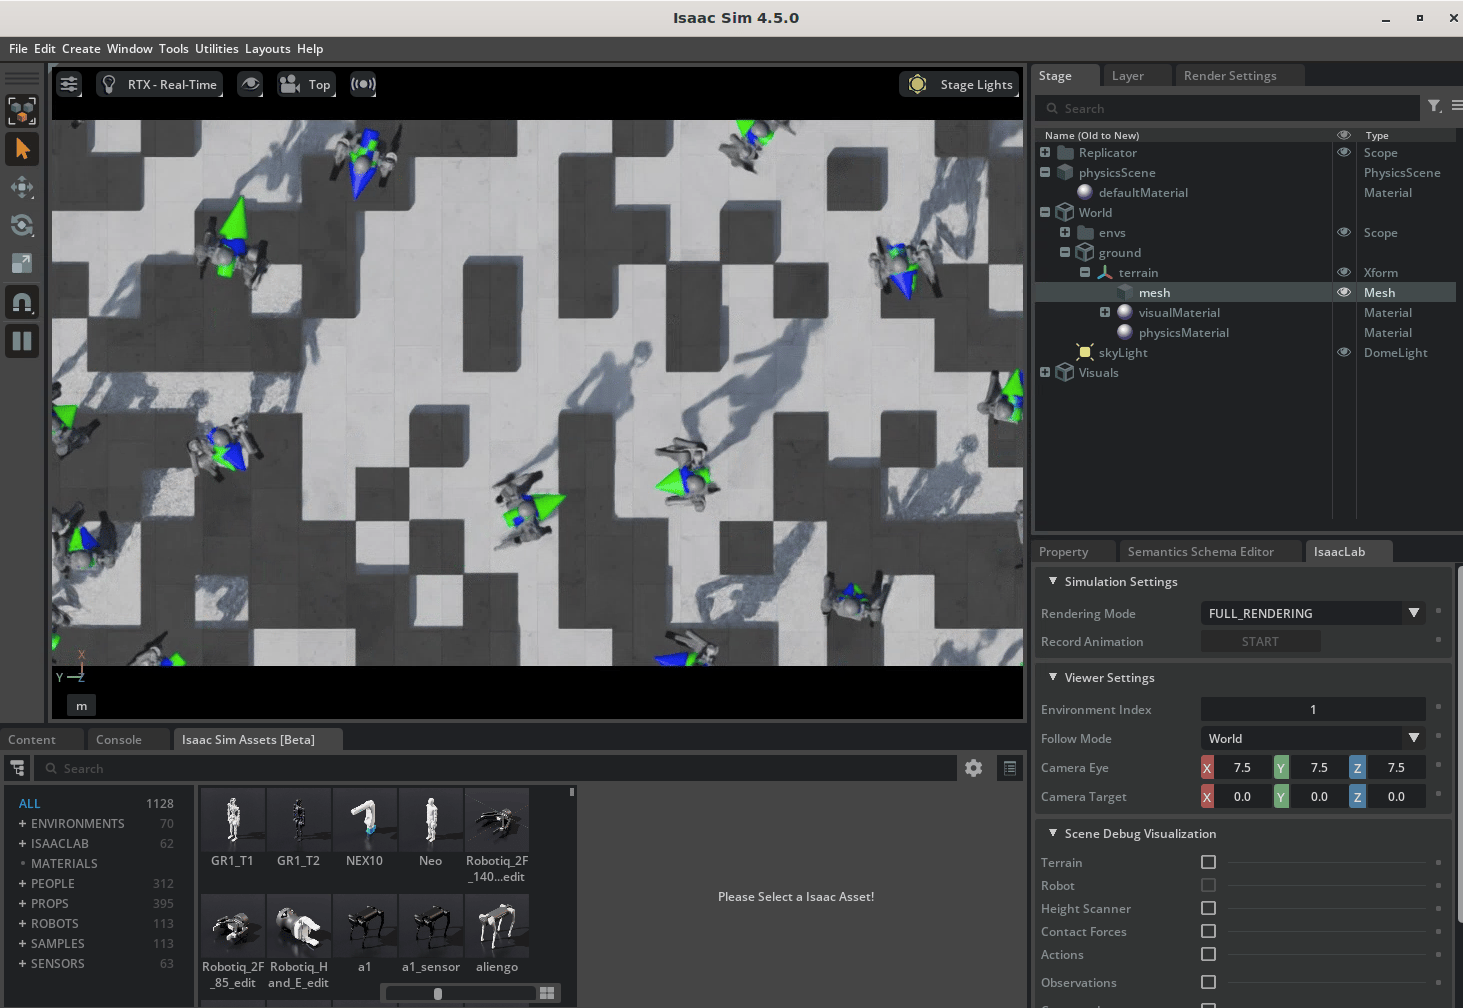
그림 19. IsaacLab에서 2,048개 환경으로 Unitree H1 휴머노이드 보행 태스크 학습 과정
이 단일 노드 실행은 학습이 어떻게 도는지 눈으로 확인하는 데는 충분하지만 실제 프로젝트의 한계가 금방 옵니다. 태스크와 하이퍼파라미터별로 수십 개 실험을 병렬로 돌리고, 수일에서 수주 걸리는 학습을 중단 없이 유지하고, 체크포인트를 팀이 공유할 스토리지가 필요해집니다. 모듈 8이 SageMaker HyperPod 클러스터를 배포하는 이유입니다.
7.2 왜 SageMaker HyperPod인가
SageMaker HyperPod는 장시간 분산 학습을 위한 관리형 클러스터입니다. Slurm과 Amazon EKS 두 오케스트레이션을 지원하고, 노드 하드웨어 상태를 자동으로 감시해 장애 노드를 재부팅하거나 교체하며, 교체된 노드는 job을 받기 전에 심층 헬스체크를 통과해야 합니다. Slurm 환경에서는 하드웨어 장애 후 마지막 체크포인트에서 job을 자동 재개하는 auto-resume도 제공합니다.
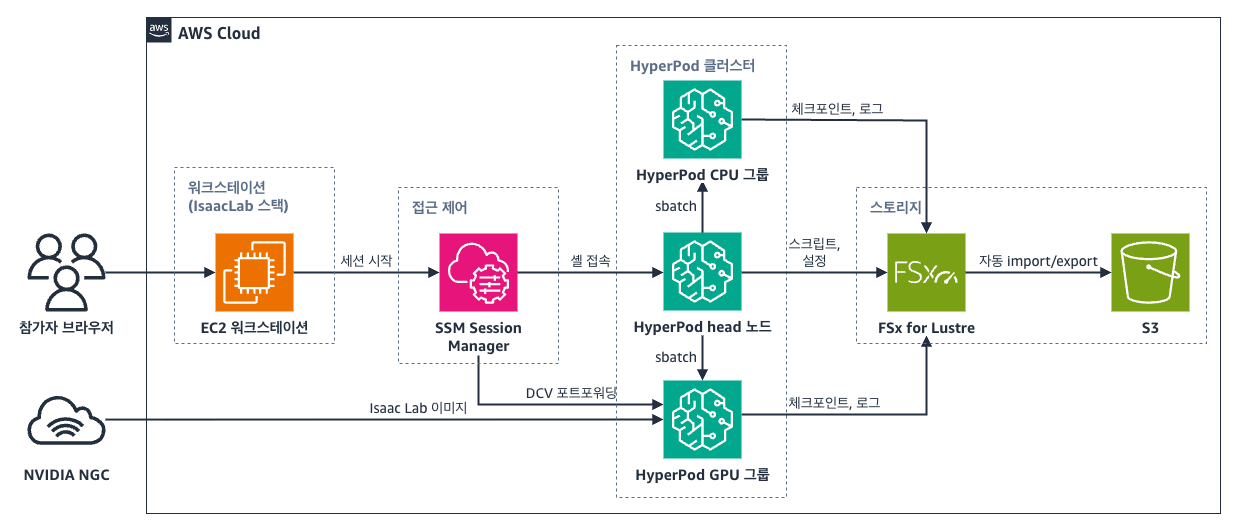
그림 20. HyperPod Slurm 클러스터와 FSx for Lustre 학습 구성
7.3 인스턴스 그룹
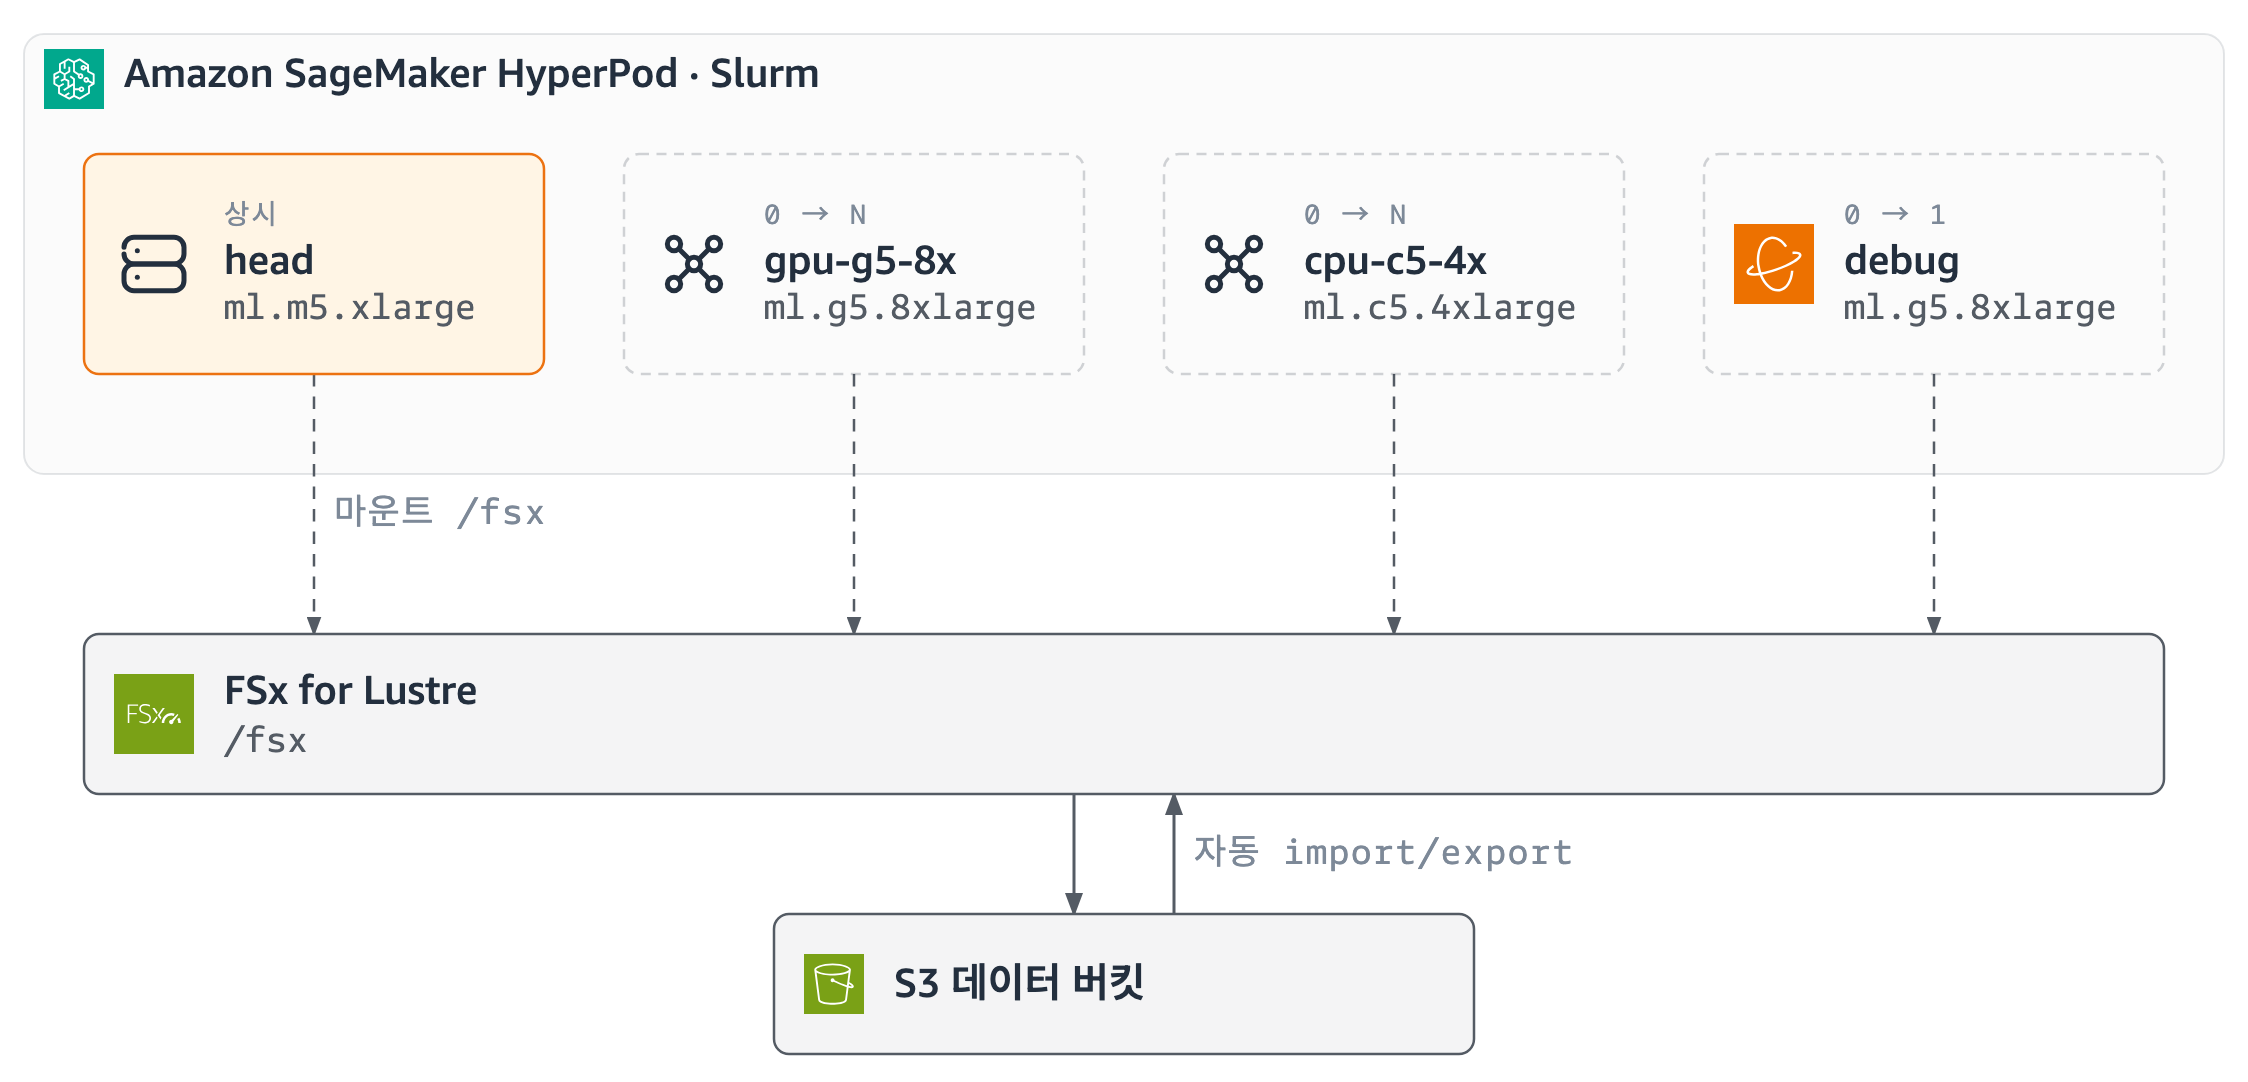
그림 21. HyperPod Slurm의 인스턴스 그룹 구성
HyperPod의 인스턴스 그룹은 노드 수를 독립적으로 조절하는 단위이고, 요금은 인스턴스 기준이므로 정의만 된 그룹은 비용이 발생하지 않습니다. head 노드와 FSx for Lustre만 상시 두고, GPU 그룹과 CPU 그룹은 0대로 시작하여, 상시 비용을 최소화합니다. GPU 학습용, CPU 학습용, 시각화용 그룹을 함께 정의해 두면, 필요한 때에만 해당 노드 수를 올려서 사용할 수 있습니다. 범용 dev와 CPU 전용 cpu로 나눠 CPU job이 GPU 노드로 가지 않게 합니다. HyperPod Slurm은 job을 제출해도 노드를 자동으로 올리지 않으므로 노드 수 조절은 사람이 합니다.
7.4 Lifecycle 스크립트
학습 job이 필요할 때에만 인스턴스 그룹의 노드 수를 바꾸면, 노드가 올라옵니다. 노드가 올라올 때마다 lifecycle 스크립트가 노드 구성을 담당합니다. 노드가 뜰 때마다 같은 스크립트가 NVIDIA 드라이버, Amazon DCV, Enroot와 Pyxis 컨테이너 런타임을 설치하므로 사람이 노드마다 손으로 맞출 일이 없고, HyperPod가 하드웨어 문제를 감지해 노드를 교체할 때도 새 노드가 같은 구성으로 생성됩니다.
7.5 FSx for Lustre 스토리지
참가자는 head 노드에서 sbatch로 job을 제출합니다. Slurm은 Enroot와 Pyxis로 컨테이너를 실행하고, 체크포인트는 모든 노드가 마운트한 FSx의 /fsx 경로에 저장됩니다. FSx for Lustre의 데이터 저장소 연결(Data Repository Association)이 /fsx의 변경을 S3로 자동으로 동기화 하므로, 파일시스템에서 파일이 생성, 수정, 삭제될 때 S3로 자동 반영됩니다. 학습 중에는 병렬 파일시스템에 쓰고, 노드를 0대로 내려도 체크포인트는 S3에 남습니다.
7.6 SSM으로 클러스터 접속
클러스터 접속은 SSH가 아니라 AWS Systems Manager Session Manager를 사용합니다. 인바운드 포트를 열지 않고 SSH 키를 배포하지 않아도 IAM 권한만으로 프라이빗 서브넷의 노드에 들어갈 수 있습니다. head node는 퍼블릭 IP가 없는 프라이빗 서브넷에 있고, 노드는 sagemaker-cluster 접두어의 대상 이름으로 SSM에 등록되므로 클러스터 정보만으로 셸을 열 수 있습니다.
7.7 HyperPod 노드에서의 학습과 검증
HyperPod 클러스터에서는 필요한 노드만 올려서 학습 및 검증할 수 있어서, GPU를 활용하는 작업과 CPU를 활용하는 작업을 구분해서 사용할 수 있습니다.
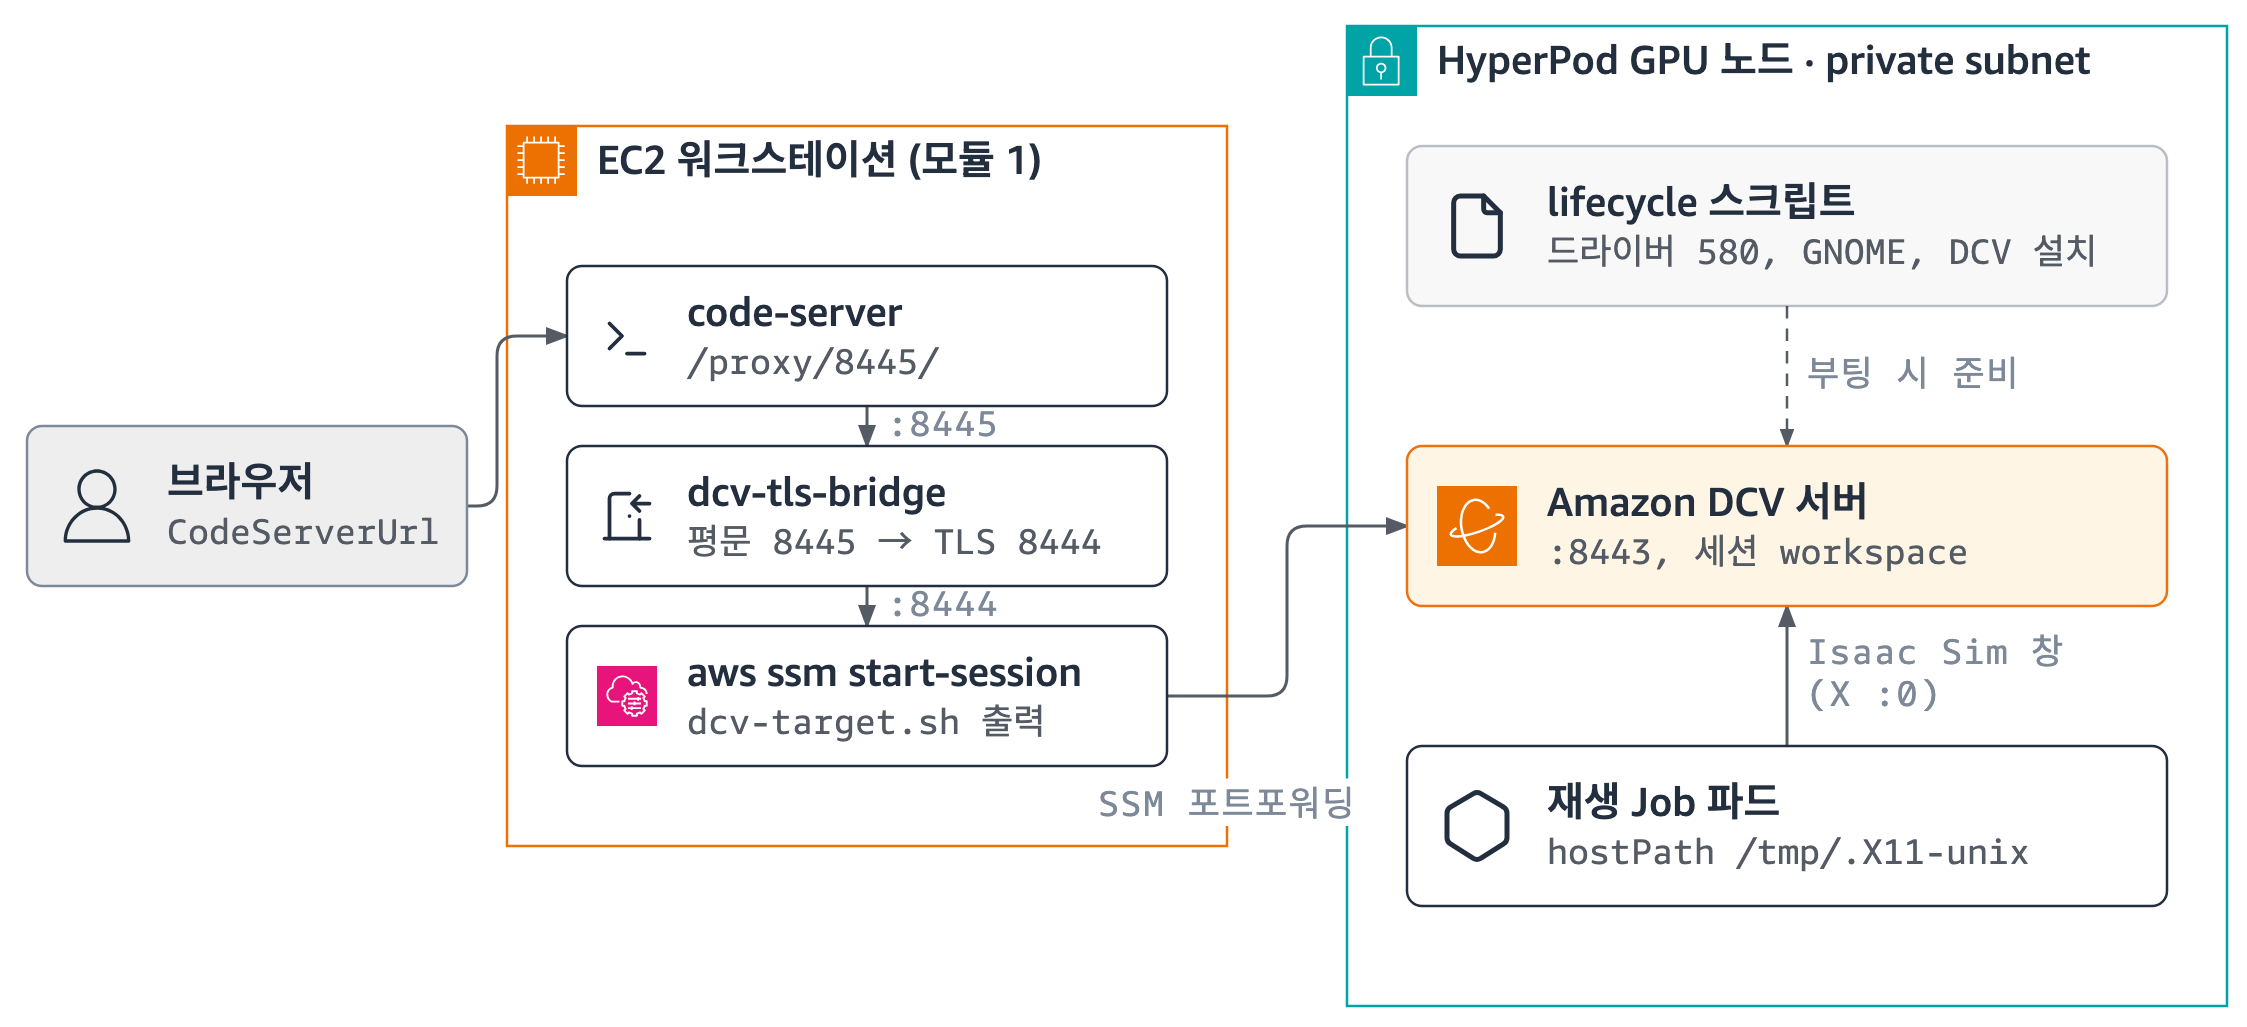
그림 22. HyperPod 노드에서 DCV 로 검증
GPU 노드를 실행하여 Isaac Lab과 RSL-RL의 PPO로 SO-101 Reach 태스크를 학습합니다. 노드는 ml.g5.8xlarge(A10G 24GB 1장)이고, Isaac Lab 컨테이너(isaac-lab:2.3.0, 15GB)는 Enroot로 import해 sqsh 파일 하나로 /fsx/enroot에 두고 Pyxis로 Slurm job 안에서 실행합니다. ml.g5.8xlarge 한 대에서 환경 2,048개를 동시에 시뮬레이션하고, iteration마다 49,152개 샘플(2,048 환경 × 24 스텝)을 모아 300 iteration을 15분에서 20분에 마칩니다. 초당 약 4만 스텝, GPU 메모리 약 5GB입니다.
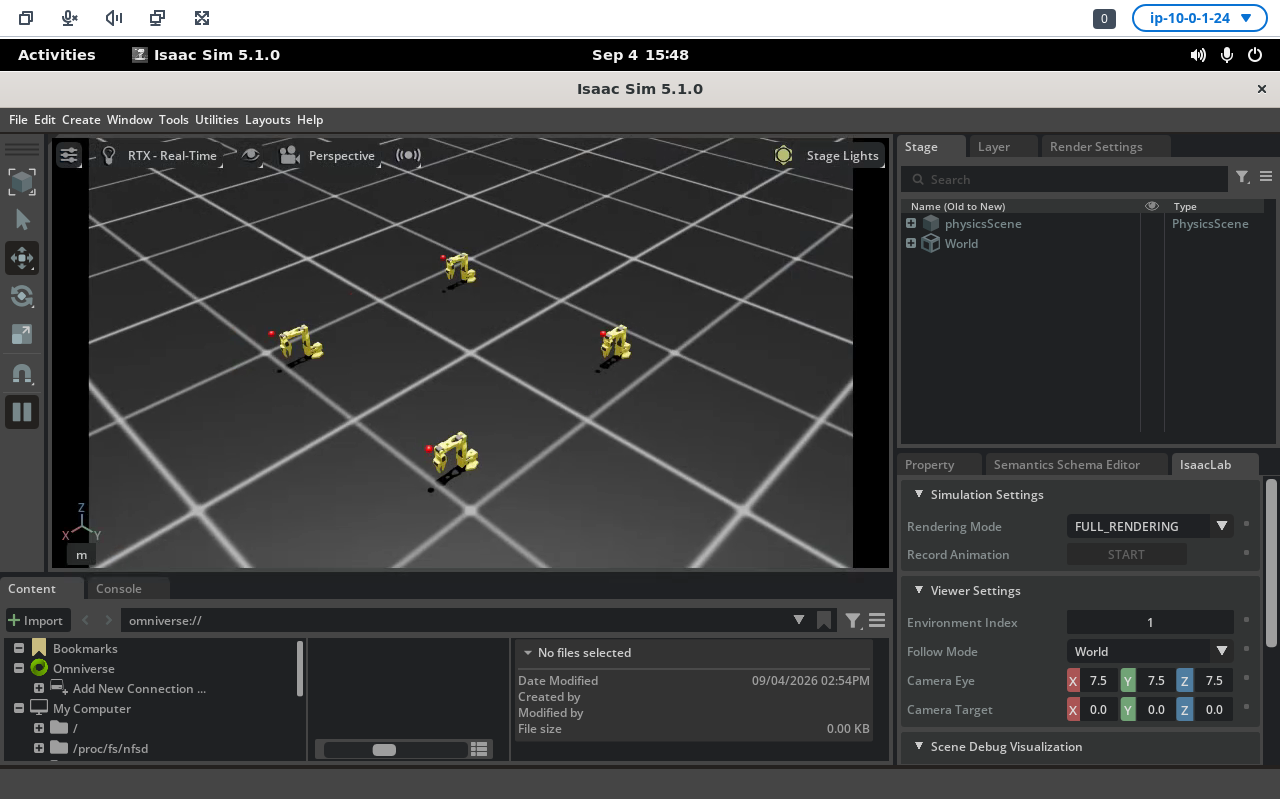
그림 23. HyperPod의 GPU 노드에서 실행시킨 IsaacLab 환경
GPU 노드에서 학습을 마친 뒤에는 같은 노드에 DCV 세션을 띄워 정책을 재생할 수 있습니다.
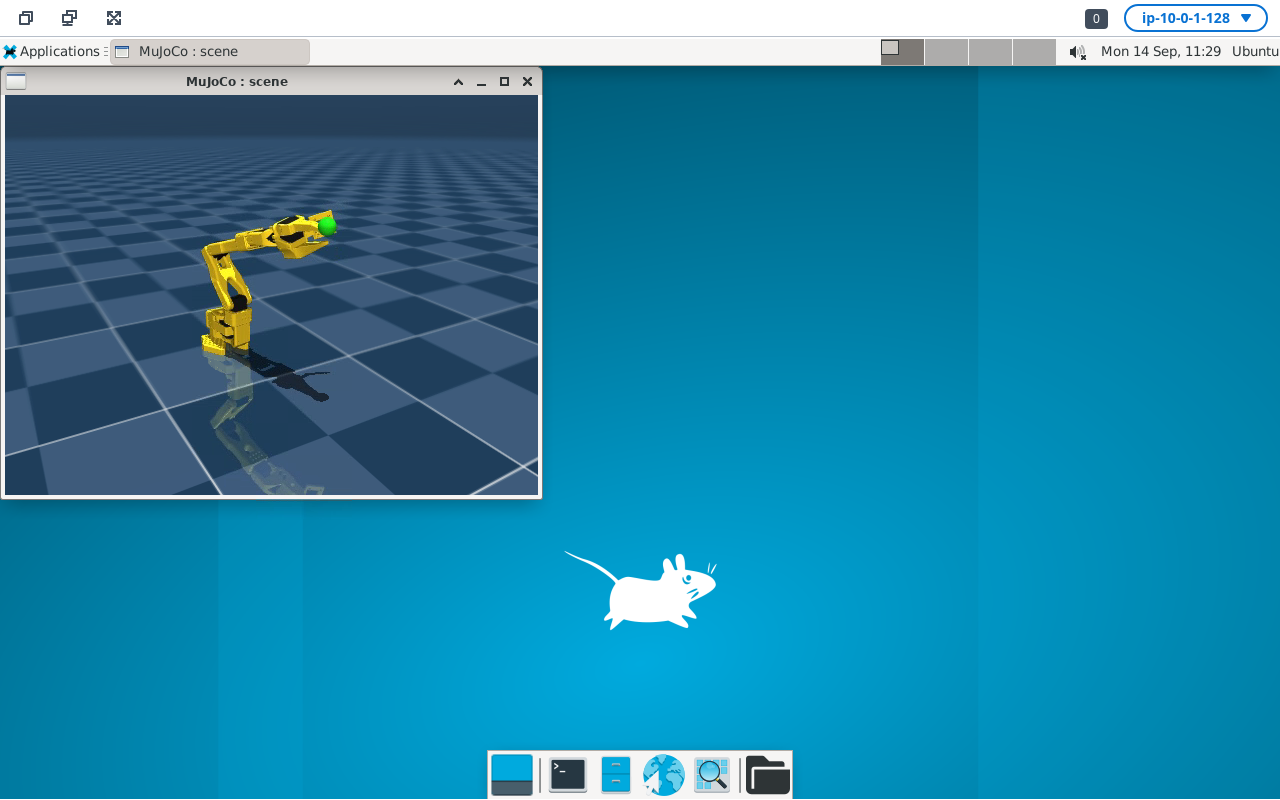
그림 24. HyperPod의 CPU 노드에서 실행시킨 DCV 세션 (MuJoCo)
CPU 노드를 사용하는 경우에는 MuJoCo 환경에서 동일한 RL 정책을 학습합니다. DCV 가상 세션은 GPU가 없어도 동작하기에, CPU 노드에서 DCV세션을 띄워 동작을 눈으로 확인할 수 있습니다.
8. 대안 경로: HyperPod EKS와 태스크 거버넌스
Slurm 클러스터는 한 팀이 쓰기에 단순합니다. 여러 팀이 한 클러스터를 나눠 쓰고 GPU 사용률을 대시보드로 봐야 한다면 HyperPod의 Amazon EKS 오케스트레이션을 고려할 수 있습니다. 같은 HyperPod를 Amazon EKS 오케스트레이션으로 배포하면 학습 job을 Kubernetes 매니페스트로 제출하고, HyperPod 콘솔의 애드온으로 운영 기능을 추가할 수 있습니다.
8.1 HyperPod Task governance
공유 클러스터에서는 노드 수만 늘려서는 팀별 자원 배분을 관리할 수 없습니다. HyperPod task governance는 팀의 연산 할당량, 우선순위, 유휴 자원의 대여와 회수, 선점 정책을 제공합니다. 예를 들어 팀 A의 논리 할당량이 16 vCPU일 때, 12 vCPU를 요청하는 작업 두 개는 합계 24 vCPU를 요구합니다. 공유 정책이 허용하면 다른 팀의 유휴 할당량 중 8 vCPU를 빌릴 수 있고, 원래 팀이 자원을 요청하면 정책에 따라 빌려 쓰던 작업이 중단될 수 있습니다.
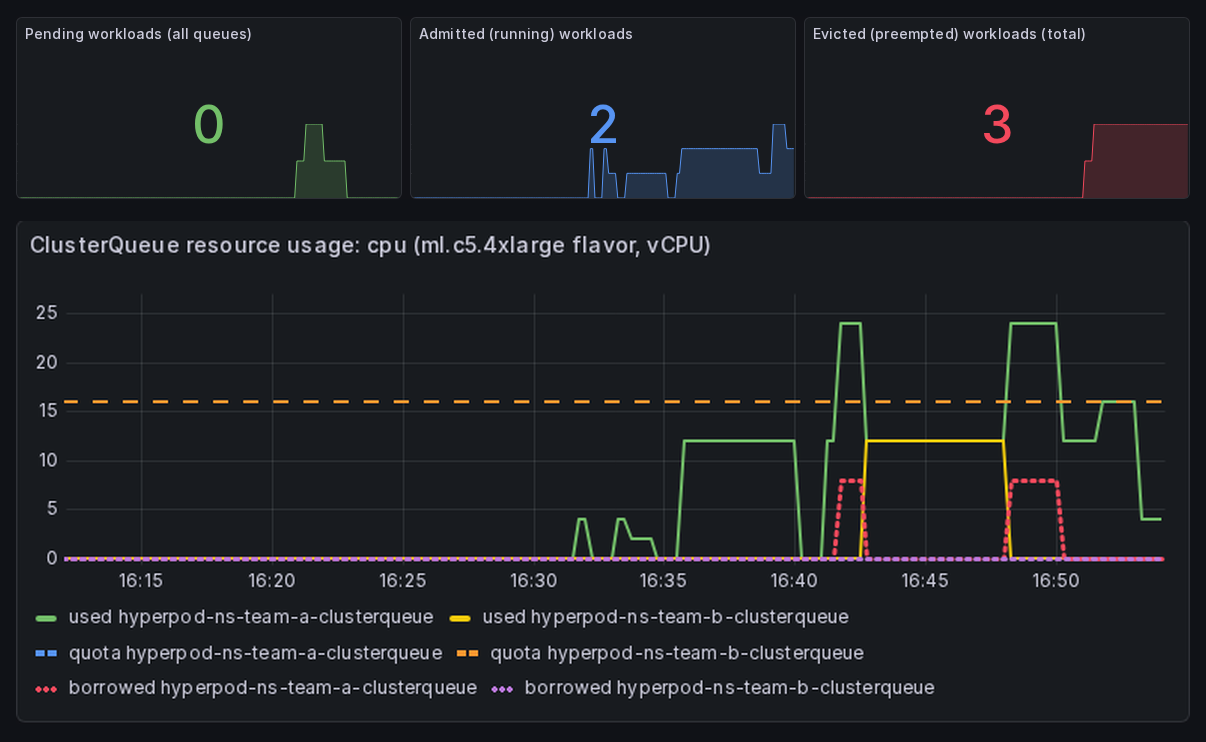
그림 25. Task Governance 화면의 상태 및 CPU 할당 패널
여기서 Admitted는 큐가 자원 사용을 허가한 상태입니다. Pod가 실제 Running이 되려면 노드 자원과 볼륨 등이 준비되어야 합니다. 팀 할당량과 대기 상태를 나타내는 지표, 노드나 GPU의 실제 사용률, 모델 학습 지표를 구분해 보아야 합니다.
8.2 HyperPod Observability
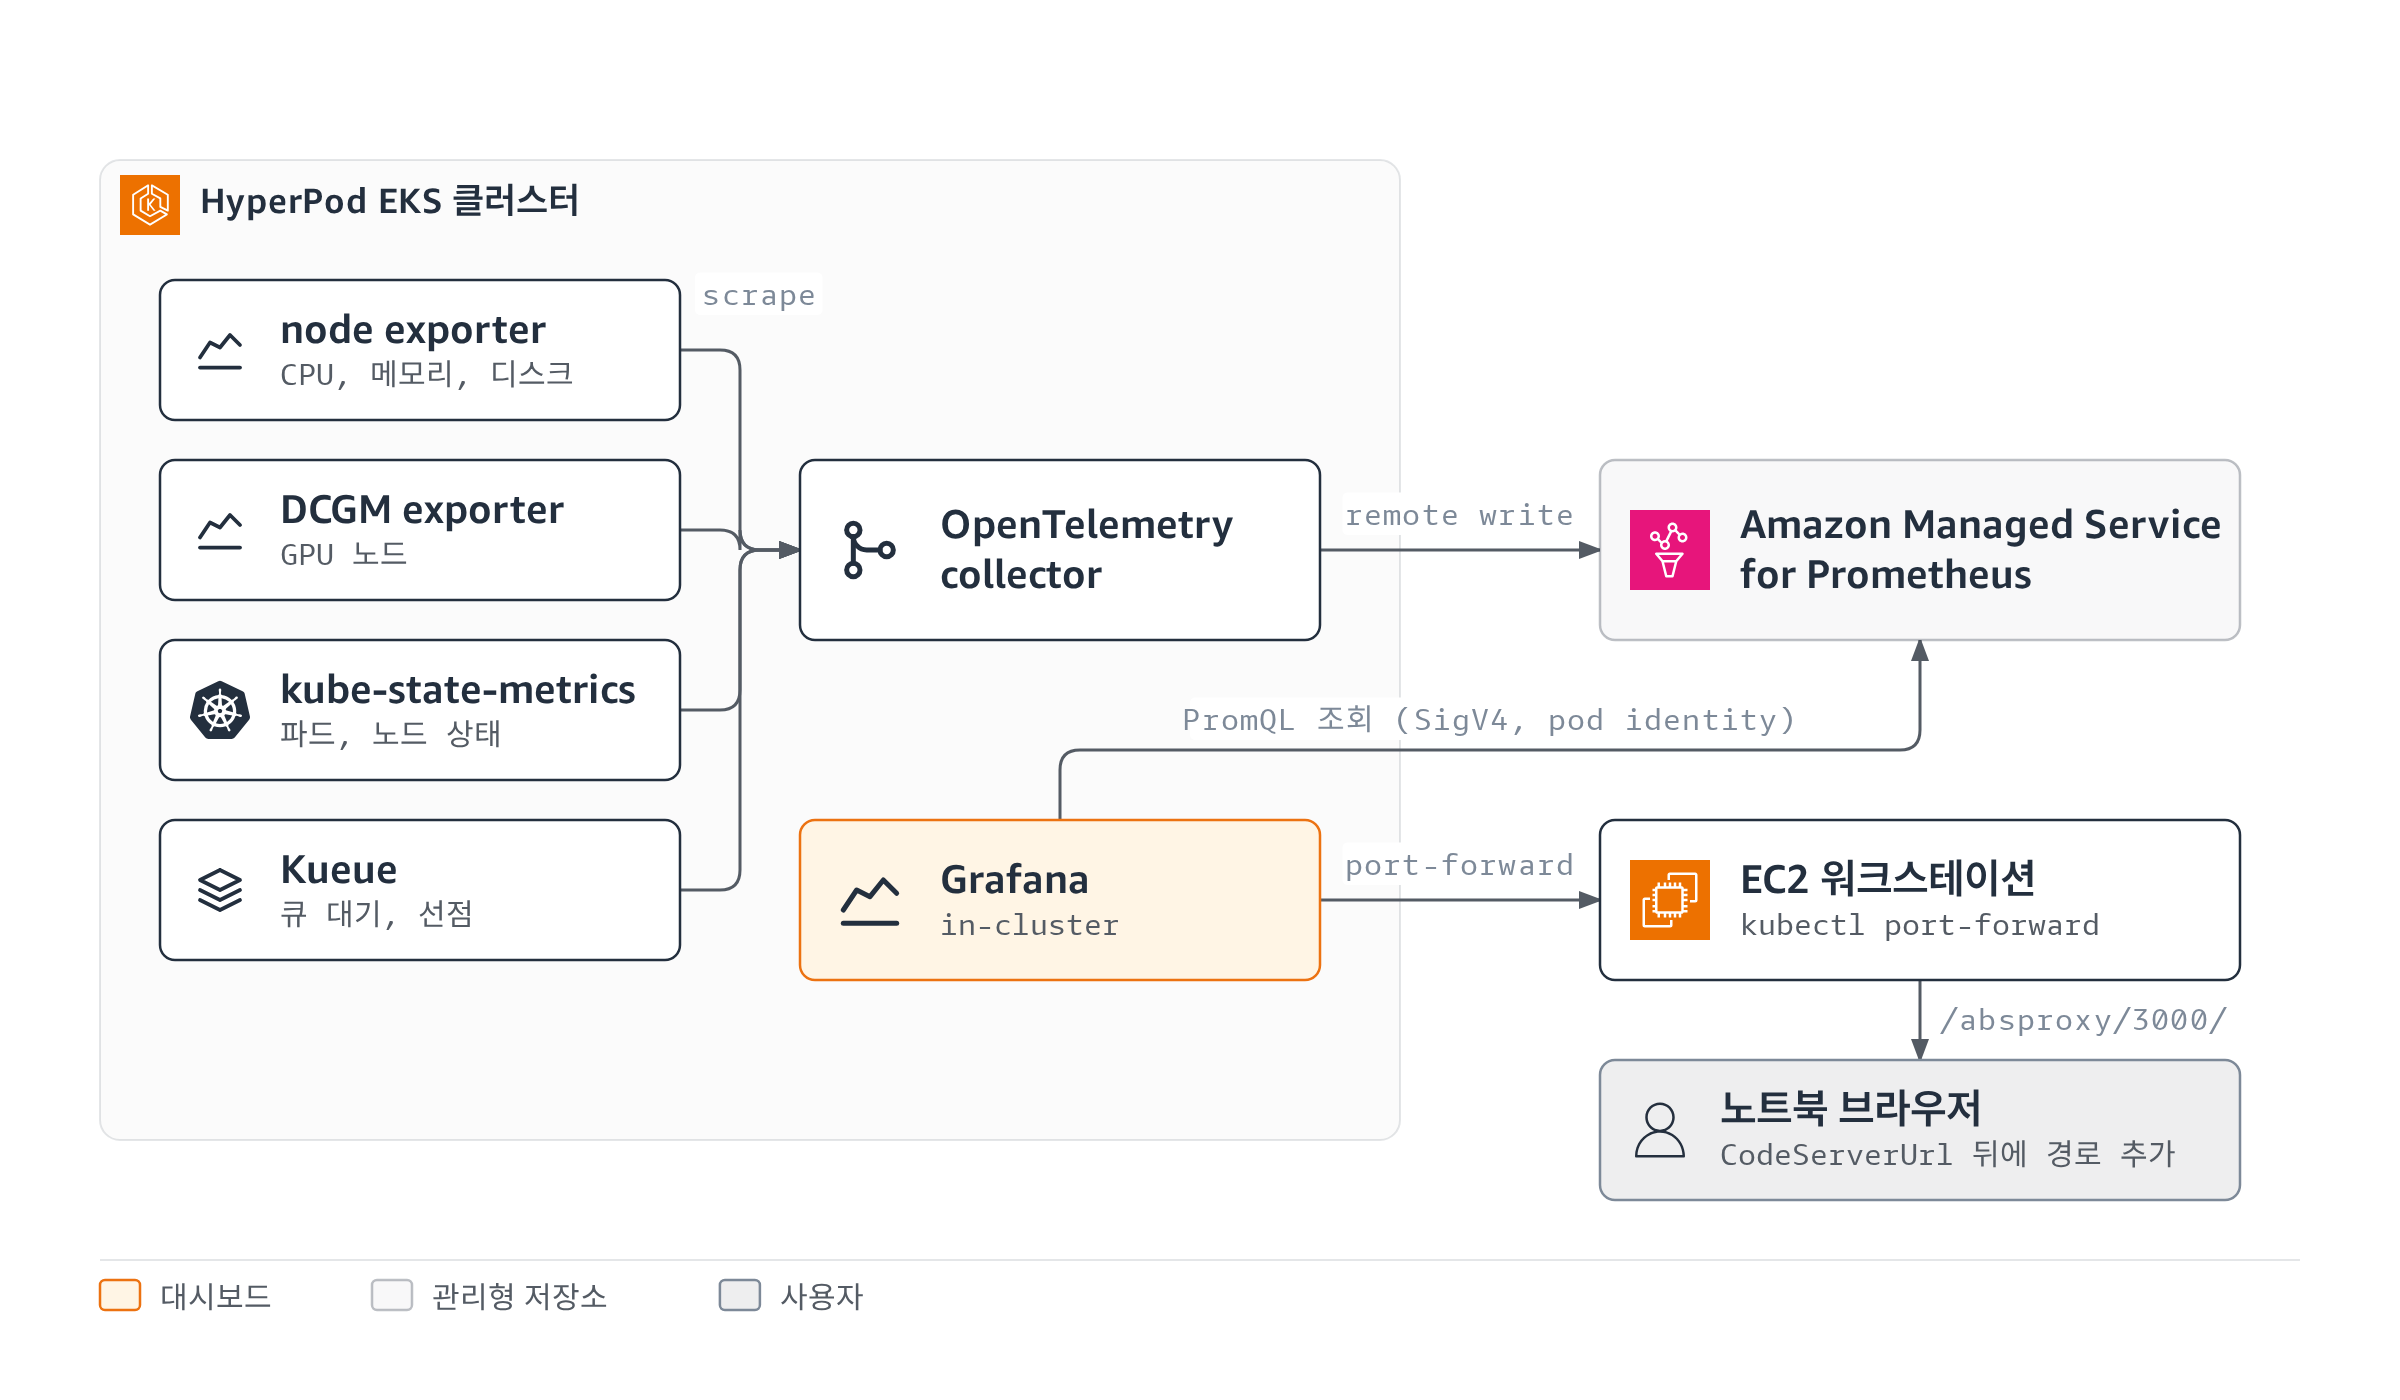
그림 26. Observability 애드온의 메트릭 경로
Observability 애드온은 노드마다 node exporter(CPU, 메모리, 디스크 메트릭을 수집하는 각 노드의 에이전트)와 GPU 노드의 DCGM exporter(GPU 사용률, 메모리, 온도), 클러스터 하나당 kube-state-metrics(파드와 노드 상태)와 Kueue 메트릭(큐 대기와 선점)을 배포합니다. OpenTelemetry collector(중앙 수집기)가 이들을 수집해 Amazon Managed Service for Prometheus(AMP, AWS의 관리형 메트릭 저장소)로 보내고, Grafana가 대시보드로 보여 줍니다. 애드온이 exporter와 collector를 관리형으로 배포하고 AMP가 저장과 쿼리를 맡으므로 노드가 1대에서 수십 대로 늘어도 운영할 모니터링 서버를 별도로 구성할 필요가 없습니다.
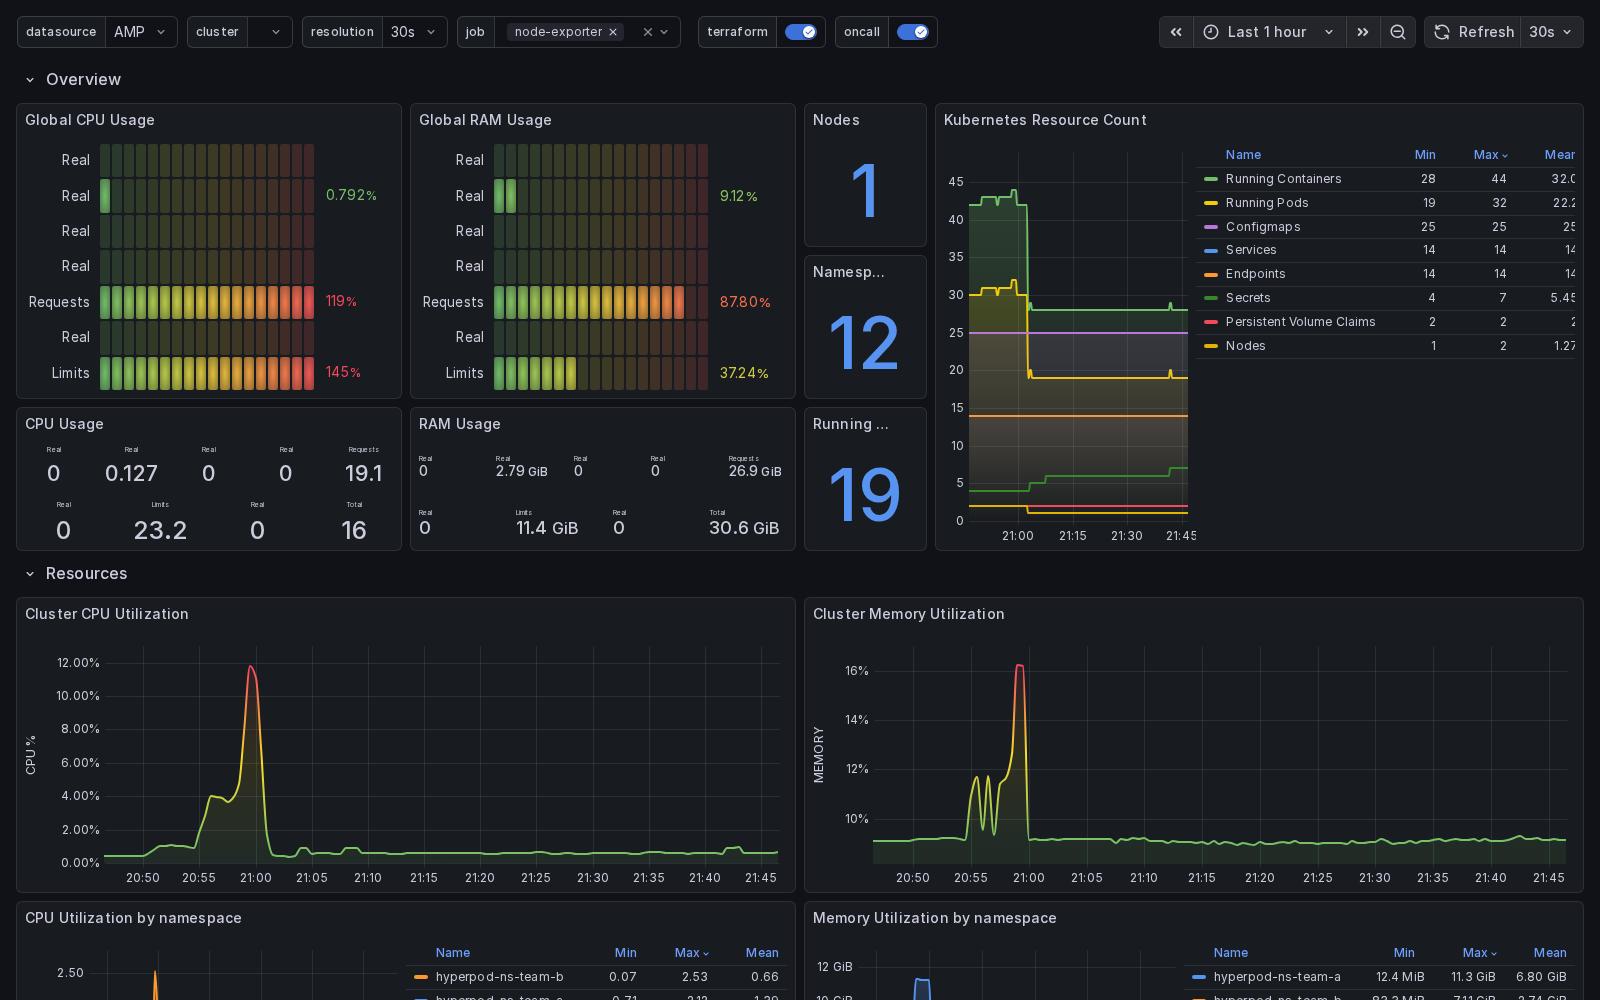
그림 27. HyperPod EKS observability 애드온이 구성한 Grafana의 대시보드
Kubernetes를 운영하는 팀이 이미 있거나 여러 팀이 클러스터를 정책으로 나눠야 하거나 실시간 GPU 대시보드가 필요하면 Slurm 클러스터보다 EKS 클러스터가 적합합니다.
9. 정리
이 글은 로봇 제어 모델을 개발할 때, 학습과 검증과 배포를 AWS 위에서 어떻게 구축하는지에 대한 내용을 설명했습니다. 결국 Physical AI 모델 개발에서의 병목은 모델이 아니라 학습, 시뮬레이션 검증, 엣지 배포의 기반이 되는 인프라입니다. AWS 인프라 상에서 Physical AI를 구축하는 것의 가치는 작업 단위 학습, 시뮬레이션 평가, 공유 연산 자원과 엣지 배포를 각각의 요구에 맞게 구성하고 산출물들을 모듈식으로 연결하는 데 있습니다.
- 시뮬레이션 GPU와 학습 GPU는 하드웨어 요구가 다르므로 분리합니다. 시뮬레이션은 RTX 계열 GPU의 EC2 워크스테이션에서, 학습은 job이 있을 때만 뜨는 SageMaker AI 인스턴스에서 실행합니다.
- 단발성 fine-tuning은 작업 단위인 Training Job으로, 장기 반복 실험은 GPU 클러스터를 띄워두는 형태의 HyperPod이 적합합니다.
- SageMaker Pipelines를 한 번 정의하고, 데이터셋과 하이퍼파라미터를 변경하는 실험을 그대로 반복합니다. 데이터 검증은 CPU 인스턴스에서 실행하고, GPU를 활용한 학습이 끝나면, 검증을 통과한 모델만 Model Registry에 등록하여 버전 관리를 합니다.
- HyperPod Slurm 클러스터는 head 노드와 FSx만 상시 두고 컴퓨트 노드는 필요할 때 올립니다.
- 학습한 모델은 Greengrass 컴포넌트로 엣지에 내리고, 컴포넌트만 구성되어 있으면 모델 교체는 단순하게 설정만 변경합니다.
이와 같은 학습 인프라 구성을 이해하고 Physical AI 모델 학습 파이프라인을 구축할 때에는 각 목적과 모델 학습 방법에 맞게 인프라를 선택할 수 있습니다.
참고 자료
- 워크샵: From Training to Edge: Physical AI on AWS
- Amazon SageMaker HyperPod, HyperPod Slurm 복원력 기능
- Amazon SageMaker AI 개발자 가이드: Training Job
- SageMaker Pipelines 스텝 유형, 스텝 캐싱, Model Registry 승인 상태
- SageMaker 학습 출력 비압축 저장
- Amazon SageMaker AI with MLflow
- Amazon SageMaker HyperPod 개발자 가이드, Amazon SageMaker HyperPod task governance
- Amazon FSx for Lustre: 데이터 저장소 연결, Amazon S3 Files
- Amazon DCV, AWS Systems Manager Session Manager
- AWS IoT Greengrass V2 개발자 가이드
- NVIDIA Isaac GR00T 저장소, GR00T N1 논문, GR00T N1.7 연구 블로그
- Isaac Sim 시스템 요구사항, Isaac Lab RL 라이브러리 비교
- MuJoCo 문서, MJX
- SO-101 로봇 팔, LeRobotDataset v3.0
- LeIsaac (LightwheelAI), leisaac-pick-orange 데이터셋
- NVIDIA Physical AI 용어집