Amazon Web Services ブログ
Amazon Bedrock の自動推論チェックによる信頼できる AI システムの構築 – パート 1
本ブログは 2025 年 10 月 31 日に公開された AWS Blog “Build reliable AI systems with Automated Reasoning on Amazon Bedrock – Part 1” を翻訳したものです。
規制産業の企業では、すべての AI 応答が定められたポリシーとドメイン知識に準拠していることを、数学的な確実性をもって示すことがしばしば求められます。こうした業界では、AI 出力の統計的なサンプルだけをテストしてコンプライアンスを確率的に主張する従来の品質保証手法は使えません。AWS は、AWS re:Invent 2024 において Amazon Bedrock Guardrails の自動推論チェック (Automated Reasoning checks) をプレビューとして提供開始しました。この機能は、形式的検証の技術を適用し、エンコードされたビジネスルールとドメイン知識に照らして AI 出力を体系的に検証するという、新しい解決策をもたらしました。これらの技術により、検証結果は透明性が高く説明可能なものになります。
自動推論チェックは、さまざまな業界のワークフローで活用されています。金融機関は、AI が生成した投資アドバイスが規制要件を満たしていることを数学的な確実性をもって検証しています。医療機関は、患者向けのガイダンスが臨床プロトコルに沿っているかを確認しています。製薬企業は、マーケティング上の主張が FDA (米国食品医薬品局) 承認のエビデンスで裏付けられていることを確かめています。公益事業会社は災害時の緊急対応プロトコルを検証し、法務部門は AI ツールが必須の契約条項を漏れなく反映しているかを検証しています。
自動推論チェックの一般提供開始に伴い、AWS はドキュメント処理容量を拡張し、ポリシールールが実際に動作する例を自動的に作成するシナリオ生成などの新機能を追加しました。強化されたテスト管理システムにより、ドメインエキスパートは包括的なテストスイートを構築、保存して自動実行し、モデルやアプリケーションのバージョンをまたいで一貫したポリシー適用を維持できます。
2 部構成のテクニカルディープダイブの第 1 部となる本記事では、Amazon Bedrock Guardrails における自動推論チェックの技術的な基礎を解説し、生成 AI アプリケーションのために数学的に厳密なガードレールを構築する実装方法を紹介します。
本記事で学べる内容
- AI 出力の数学的な検証を可能にする形式的検証の技術を理解する
- 自然言語のドキュメントから自動推論ポリシー (Automated Reasoning policy) を作成し、改善する
- ビジネスルールに照らして AI 応答を検証するための効果的なテストケースを設計、実装する
- 注釈 (annotation) を用いてポリシーを改善し、精度を高める
- AWS のベストプラクティスに従い、Amazon Bedrock Guardrails を使用して自動推論チェックを AI アプリケーションのワークフローに統合し、生成されたコンテンツに対する高い信頼を維持する
この実装ガイドは、事実誤認やポリシー違反がエンドユーザーに届く前に、それらを体系的に防止するのに役立ちます。これは、AI システムに高い保証と数学的な確実性を求める規制産業の企業にとって、きわめて重要な能力です。
自動推論チェックの主要機能
このセクションでは、ポリシー開発のためのコンソール体験、ドキュメント処理アーキテクチャ、論理検証のメカニズム、テスト管理フレームワーク、統合パターンなど、自動推論チェックの機能を説明します。これらの中核となる構成要素の理解が、生成 AI アプリケーションのための効果的な検証システムを実装する基礎になります。
コンソール体験
Amazon Bedrock の自動推論チェックのコンソールは、ポリシー開発を論理的なセクションに整理し、作成、改善、テストのプロセスを順に案内します。インターフェイスでは一意の ID によってルールを明確に識別でき、ルール内で変数名をそのまま使用するため、複雑なポリシー構造も理解しやすく管理しやすくなっています。
ドキュメント処理容量
ドキュメント処理は最大 120,000 トークン (約 100 ページ) に対応するため、大規模なナレッジベースや複雑なポリシードキュメントを自動推論ポリシーにエンコードできます。包括的なポリシーマニュアル、詳細な手順書、広範な規制ガイドラインを取り込むことも可能です。この容量により、1 つのポリシー内でドキュメント全体を扱えます。
訳注: 上記の上限は記事公開時点の情報です。2026 年 9 月時点のユーザーガイドでは、ソースドキュメントのサイズは 5 MB、50,000 文字までと記載されています。参照: 自動推論ポリシーを作成する – Amazon Bedrock
検証機能
検証 API には、明確化が必要なステートメントを識別するあいまいさの検出、検証が失敗した理由を示す INVALID の検出結果に対する反例、境界条件を理解しやすくするために有効な例と無効な例の両方を示す SATISFIABLE の検出結果が含まれます。これらの機能は検証結果の背景となる情報を提供し、特定の応答がフラグ付けされた理由と改善方法を理解する助けになります。また、自然言語と論理構造の間の変換 (translation) に対する信頼度も示せるため、ユースケースに適したしきい値を設定できます。
反復的なフィードバックと改善のプロセス
自動推論チェックは、応答が検証に失敗した理由を説明する詳細で監査可能な検出結果を提供します。これにより、準拠していないコンテンツを単にブロックするのではなく、反復的な改善プロセスを進められます。この情報は基盤モデルにフィードバックでき、モデルはポリシールールに準拠するまで、具体的なフィードバックに基づいて応答を調整できます。このアプローチは、事実の正確さとコンプライアンスを推定ではなく数学的に検証しなければならない規制産業で特に有用です。
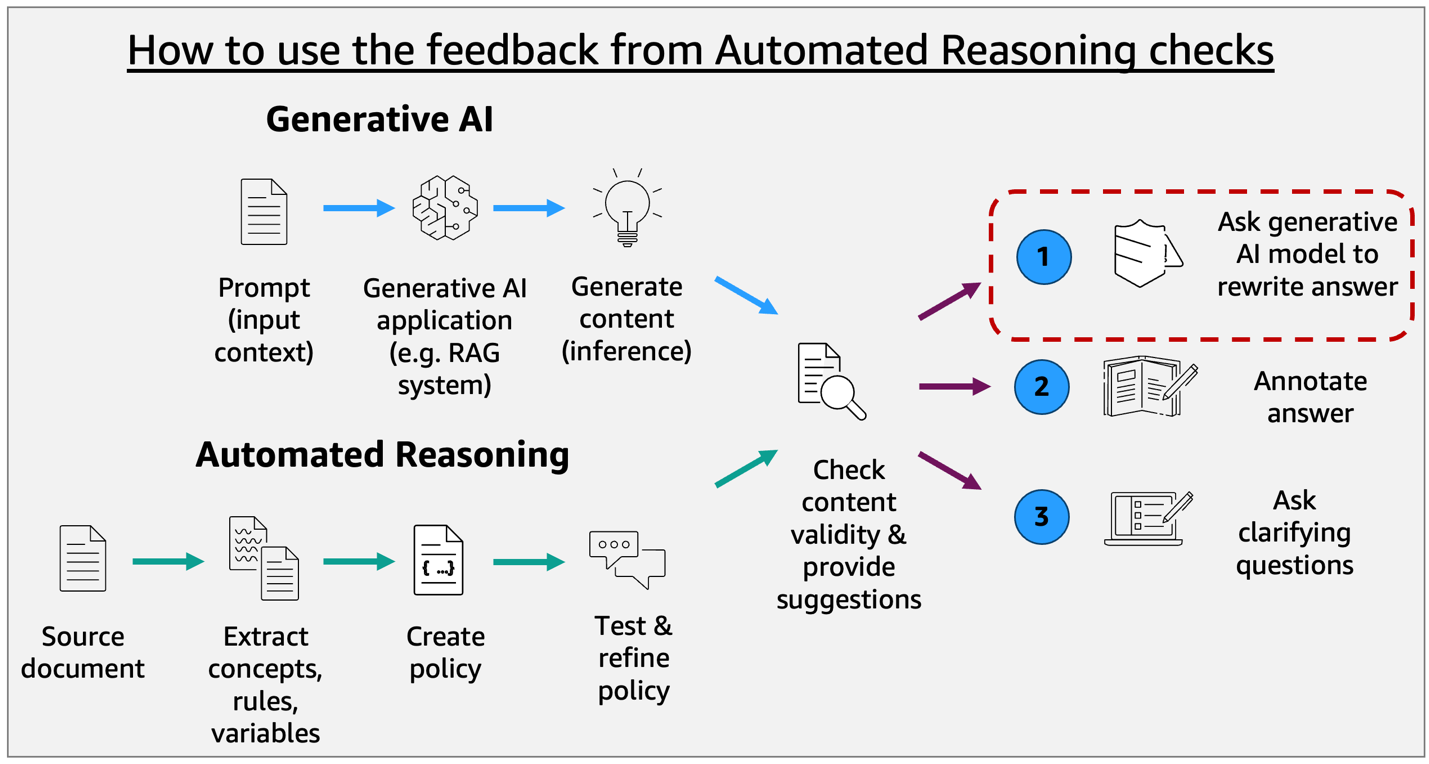
ポリシー例による検出結果タイプ
休日を判定するポリシーを例に考えてみましょう。自動推論チェックにおけるポリシーは、変数のスキーマ (従業員区分、勤続年数、利用可能な休暇日数などの概念を定義するもの) と、これらの変数間の関係を定める一連の論理ルール (休暇の種類ごとの適格条件など) の 2 つで構成されます。検証時には、このスキーマとルール構造を使って、基盤モデルの応答が定義したポリシー制約に準拠しているかどうかを評価します。
ここでは、基盤モデル (FM) を利用したアプリケーションにユーザーが入力した以下の内容と、生成された出力を検証します。
前提 (premise) とは結論を導き出すもとになるステートメントであり、主張 (claim) とは真であると述べられた内容です。この例では、day が「Thursday」に等しく、is_public_holiday が true であることが前提として推論され、is_day_off が true であることが主張されています。
この推論は、次の自動推論ポリシーに従っています。
一般提供開始に伴い、自動推論チェックは FM が生成した応答の検証プロセスについて的確な洞察を与える、7 種類の検出結果タイプを出力するようになりました。
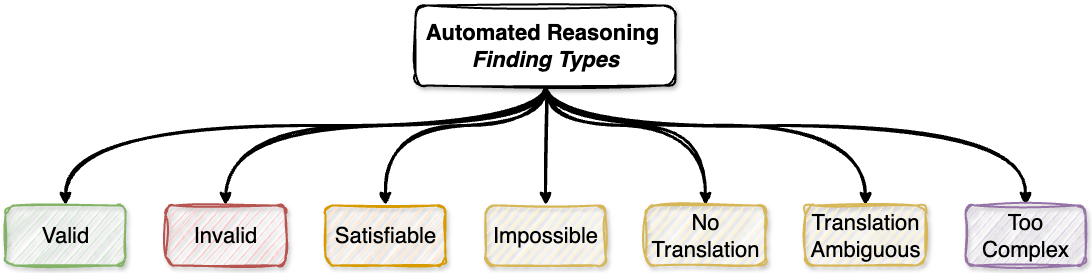
VALID: Input と Output がポリシールールに完全に整合していることを示します。生成された応答の情報が、定義済みのポリシーに従って正しいという確信が得られます。主張は前提から推論され、自動推論 (AR) ポリシーによって真であると検証されており、これらの主張と矛盾する別の答えは存在しません。
SATISFIABLE: Input と Output が、特定の仮定によって真にも偽にもなり得ることを示します。この検出結果は、応答が一定の条件下でのみ有効となる境界条件を把握するのに役立ち、その仮定がご自身のユースケースにおいて妥当かどうかを判断できます。必要な仮定が偽である場合は、前提と整合する別の主張が存在する可能性があります。
INVALID: Input と Output にポリシー上の不正確さや事実誤認があることを示し、検証が失敗した理由を明示する反例を付加します。主張は前提と AR ポリシーからは導かれず、前提と AR ポリシーに整合する別の主張が存在します。
IMPOSSIBLE: 前提が AR ポリシーと矛盾している、またはポリシー自体に内部矛盾があるため、有効な主張を生成できない場合を示します。この検出結果は、ポリシーで定義された制約が論理的な不可能性を生み出しているときに発生します。
NO_TRANSLATIONS: Input と Output に、AR ポリシーの評価に関連するデータへ変換できる情報が含まれていない場合に発生します。通常は、テキストがポリシーのドメインとまったく無関係な場合や、評価に利用できる情報を含まない場合に起こります。
TRANSLATION_AMBIGUOUS: Input と Output があいまいなため、論理構造へ確定的に変換できない場合を示します。この検出結果が返された場合、検証を進めるには追加のコンテキストや確認のための質問が必要になる可能性があります。
TOO_COMPLEX: Input と Output に、レイテンシーの制限内では処理できないほど多くの情報が含まれていることを示します。この検出結果は、システムの現在の処理能力を超える、極端に大きい入力や複雑な入力で発生します。
シナリオ生成
ポリシーから直接シナリオを生成できるようになりました。ポリシールールに適合するテストサンプルが作成されるため、エッジケースの特定や、ポリシーのビジネスロジック実装の検証に役立ちます。この機能により、ポリシー作成者はデプロイ前にルールの実際の動作を具体例で確認でき、広範な手動テストの必要性を減らせます。また、シナリオ生成は、個々のルールを見ているだけでは気付きにくい、ポリシーの適用範囲における潜在的な矛盾や抜けも浮き彫りにします。
テスト管理システム
新しいテスト管理システムでは、ポリシーテストを保存して注釈を付け、一貫した検証のためのテストライブラリを構築し、ポリシー変更を検証するためにテストを自動実行して、ポリシーのバージョンをまたいで品質保証を維持できます。ポリシーの改訂を重ねてもテスト結果を追跡できるバージョニング機能も備えており、変更が意図しない影響を及ぼしていないかを特定しやすくなっています。さらに、既存の品質保証ワークフローやドキュメント作成プロセスに組み込むために、テスト結果をエクスポートすることもできます。
ガードレールとの直接統合による選択肢の拡大
自動推論チェックは Amazon Bedrock の API と統合され、複雑なやり取り全体を通じて、AI が生成した応答を定められたポリシーに照らして検証できるようになりました。この統合は Converse アクションと RetrieveAndGenerate アクションの両方に対応しているため、さまざまな対話形式でポリシーを適用できます。検証の信頼度しきい値はドメイン要件に応じて設定でき、規制産業では厳格に、探索的な用途では柔軟に適用するといった使い分けが可能です。
ソリューション – AI を活用した病院再入院リスク評価システム
ここまで自動推論チェックの機能を説明してきました。次は AI を活用した病院再入院リスク評価システムのユースケースを取り上げ、ソリューションを段階的に見ていきましょう。この AI システムは、電子カルテの患者データを分析して患者をリスクカテゴリ (低リスク、中リスク、高リスク) に分類し、CDC (米国疾病予防管理センター) のガイドラインを模した指針に基づいて個別の介入計画を推奨することで、病院再入院リスク評価を自動化します。その目的は、高リスク患者の早期特定と的を絞った介入の実施を支援して、30 日以内の再入院率を低減することです。この医療機関は、検証可能な精度と、医療ガイドラインへの準拠を数学的に証明できる説明可能な推奨を重視しています。臨床上の意思決定を支援しつつ、医療現場で一般的な厳格な監査可能性の要件も満たせるため、このアプリケーションは自動推論チェックの理想的な適用対象です。
注: 参照しているポリシードキュメントはデモンストレーション目的のみで作成した例であり、実際の医療ガイドラインや臨床上の意思決定に使用しないでください。
前提条件
Amazon Bedrock で自動推論チェックを使用するには、次の前提条件を満たしていることを確認してください。
- 有効な AWS アカウント
- 自動推論チェックが利用可能な AWS リージョンの確認
訳注: 2026 年 9 月時点で、自動推論チェックがサポートする言語は英語 (米国) です。最新の対応状況は、Amazon Bedrock ユーザーガイドの「Amazon Bedrock ガードレールの自動推論チェックとは」を参照してください。
- 自動推論ポリシーの作成、テスト、呼び出しを行うための適切な IAM 権限 (注: 本番環境で使用する IAM ポリシーは、適切な ARN パターンを使用して必要なリソースのみに限定した、きめ細かなものにしてください)
- 主なサービスクォータ: 自動推論チェックを実装する際は、サービスクォータに注意してください。
- 自動推論チェックでは、処理したテキスト量に基づいて課金されます。詳細については、Amazon Bedrock の料金を参照してください。
ユースケースとポリシーデータセットの概要
この例で使用しているポリシードキュメントの全文は、自動推論の GitHub リポジトリから入手できます。自動推論チェックの結果を検証するには、ポリシーの内容をよく理解しておくと役立ちます。さらに、自動推論が作成したポリシーを改善することが、99% を超える健全性 (soundness) を達成する鍵になります。
本記事で使用するサンプル医療ポリシーの主な内容を確認しましょう。応答の検証を始める際は、元のドキュメントと照らし合わせると役立ちます。
- リスク評価と層別化: 医療施設は、人口統計学的要因、臨床的要因、医療利用状況、検査値、社会的要因に基づく標準化されたリスクスコアリングシステムを導入し、患者を低リスク (0~3 ポイント)、中リスク (4~7 ポイント)、高リスク (8 ポイント以上) のカテゴリに分類しなければなりません。
- 必須の介入: 各リスクレベルには固有の介入が必要で、より高いリスクレベルでは下位レベルの介入に加えて追加の対策を実施します。また、一定の条件を満たす場合は、スコアにかかわらず自動的に高リスクに分類されます。
- 品質指標とコンプライアンス: 施設は、入院後 24 時間以内のリスク評価を 95% 以上、退院前の完了を 100% とするなど、所定の完了率を達成しなければならず、高リスク患者については退院計画を文書化する必要があります。
- 臨床上の監督: スコアリングシステムは標準化されていますが、主治医は適切な文書化と退院計画コーディネーターの承認のもとで、判定を覆す権限を保持します。
Amazon Bedrock コンソールを使用した自動推論チェックのポリシーの作成とテスト
最初のステップは、対象となる知識 (ここではサンプル医療ポリシー) を自動推論ポリシーにエンコードすることです。自動推論ポリシーを作成するには、次の手順を実行します。
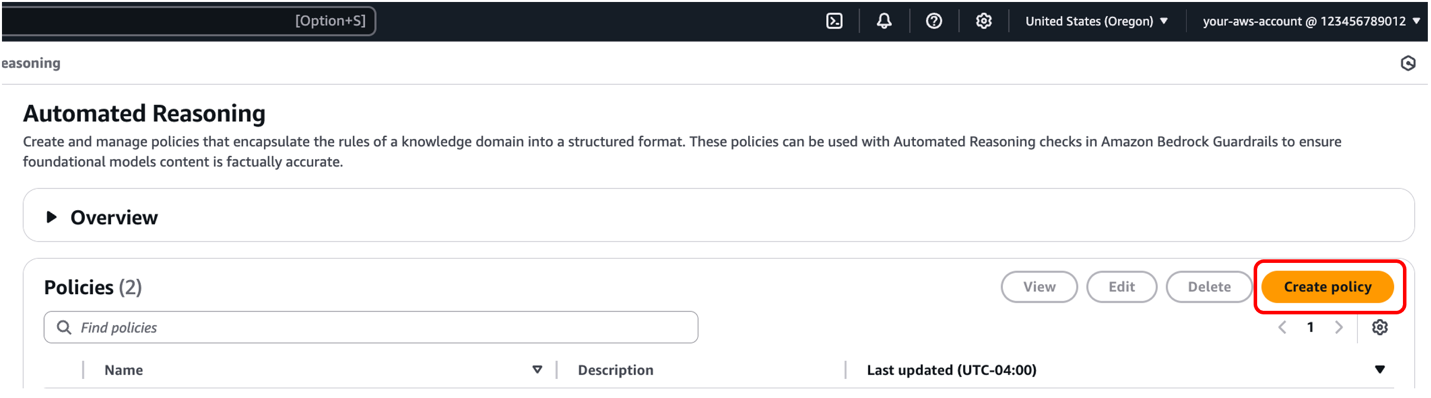
- Amazon Bedrock コンソールのナビゲーションペインで、[構築] の下にある [自動推論] を選択します。
- [ポリシーの作成] を選択します。
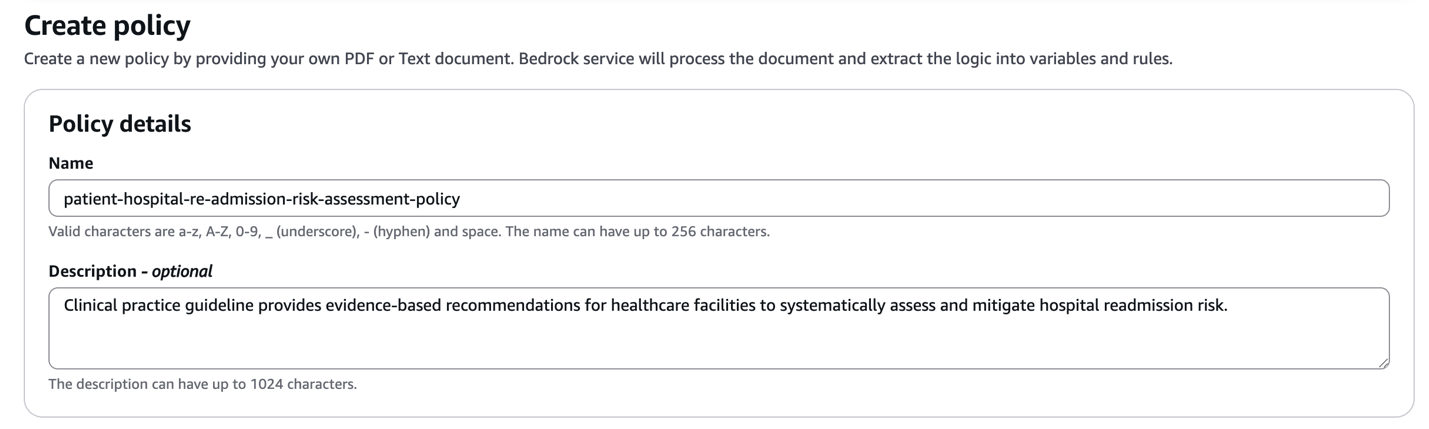
- ポリシー名とポリシーの説明を入力します。
- 自動推論がポリシーを生成する元になるソースコンテンツを追加します。取り込み方法として、ドキュメント (PDF、TXT) のアップロードとテキストの直接入力のいずれかを選択できます。
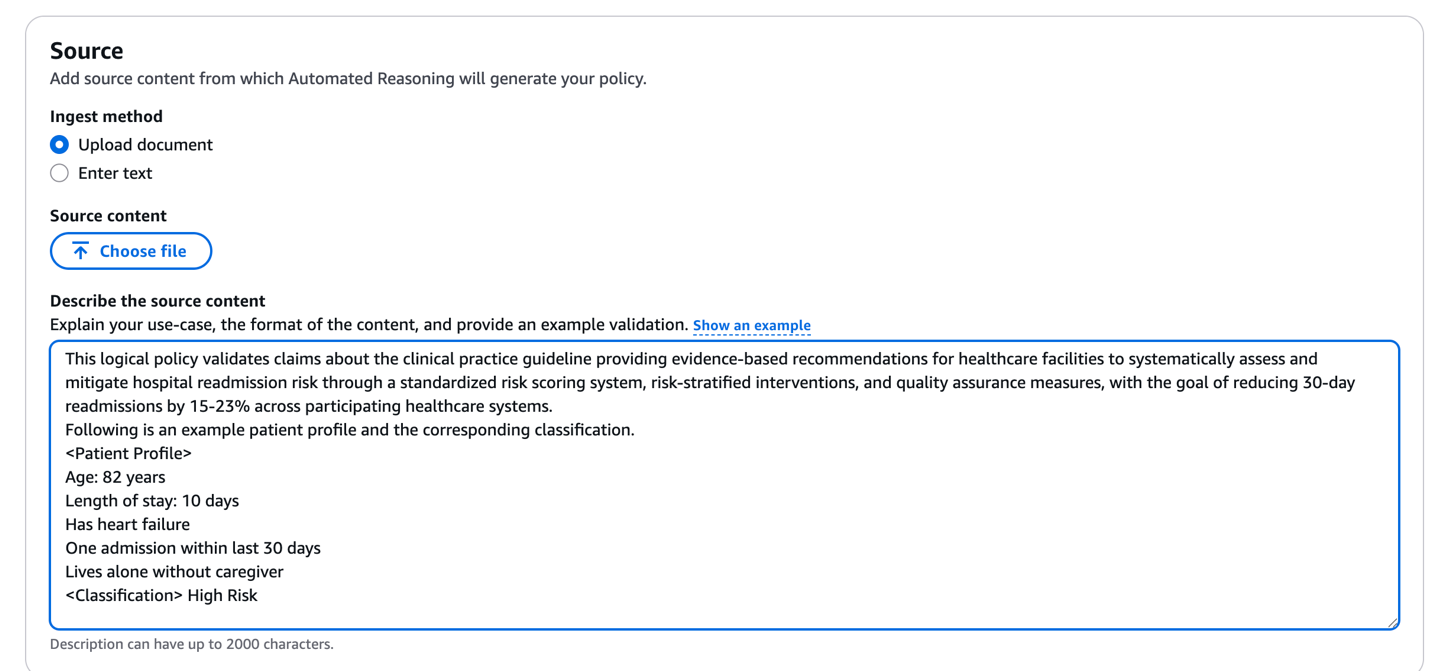
- 作成する自動推論ポリシーの意図を記述します。意図の記述は任意ですが、自然言語ベースのドキュメントを数学的検証に使える一連のルールへ変換する大規模言語モデル (LLM) にとって、有用な情報になります。サンプルポリシーでは、次の意図を使用できます。
This logical policy validates claims about the clinical practice guideline providing evidence-based recommendations for healthcare facilities to systematically assess and mitigate hospital readmission risk through a standardized risk scoring system, risk-stratified interventions, and quality assurance measures, with the goal of reducing 30-day readmissions by 15-23% across participating healthcare systems.

Following is an example patient profile and the corresponding classification.

<Patient Profile>Age: 82 years

Length of stay: 10 days

Has heart failure

One admission within last 30 days

Lives alone without caregiver

<Classification> High Risk
- ポリシーが作成されたら、[定義] を開いて、自然言語のドキュメントから知識を論理として表現するためにどのルール、変数、型が作成されたかを確認できます。
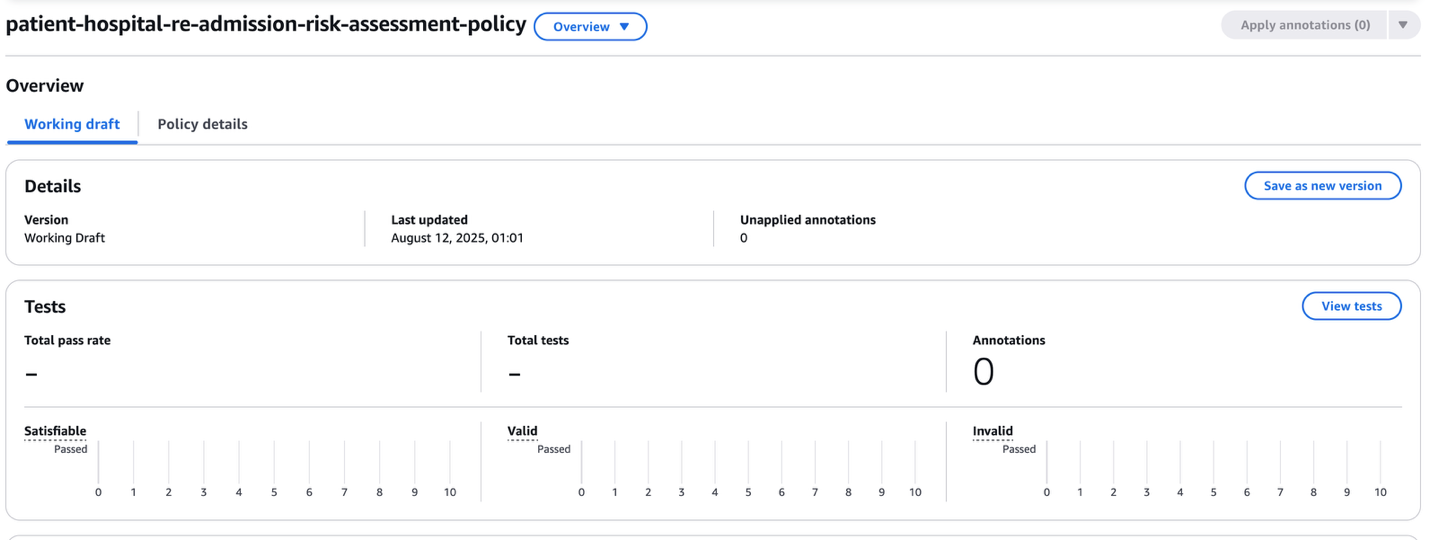
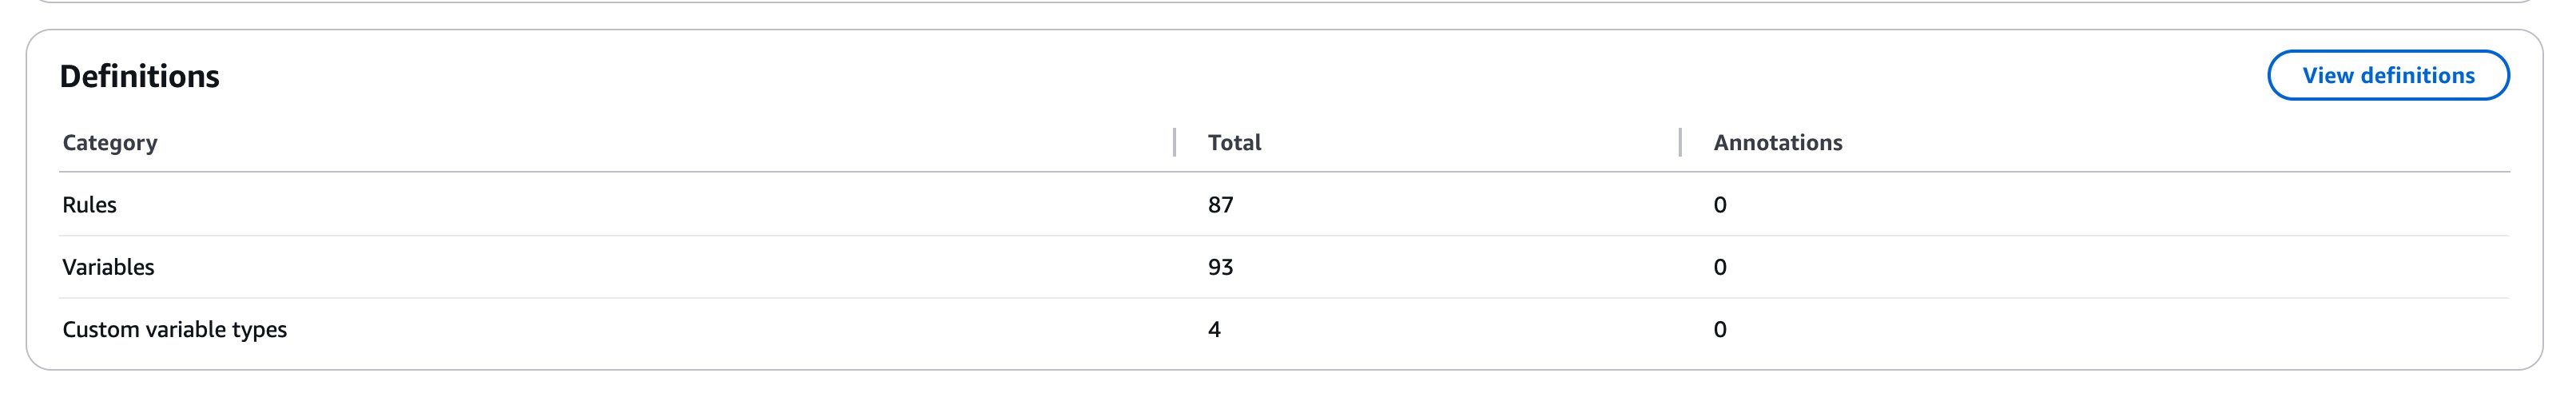
生成されるルール、変数、型の数は、この例と異なる場合があります。これは、提供したドキュメントの処理が非決定論的であるためです。そのため、他のシステムで使用する前に、ポリシー内に生成された情報を人間がレビュー (human-in-the-loop) することをお勧めします。
自動推論チェックの定義の確認
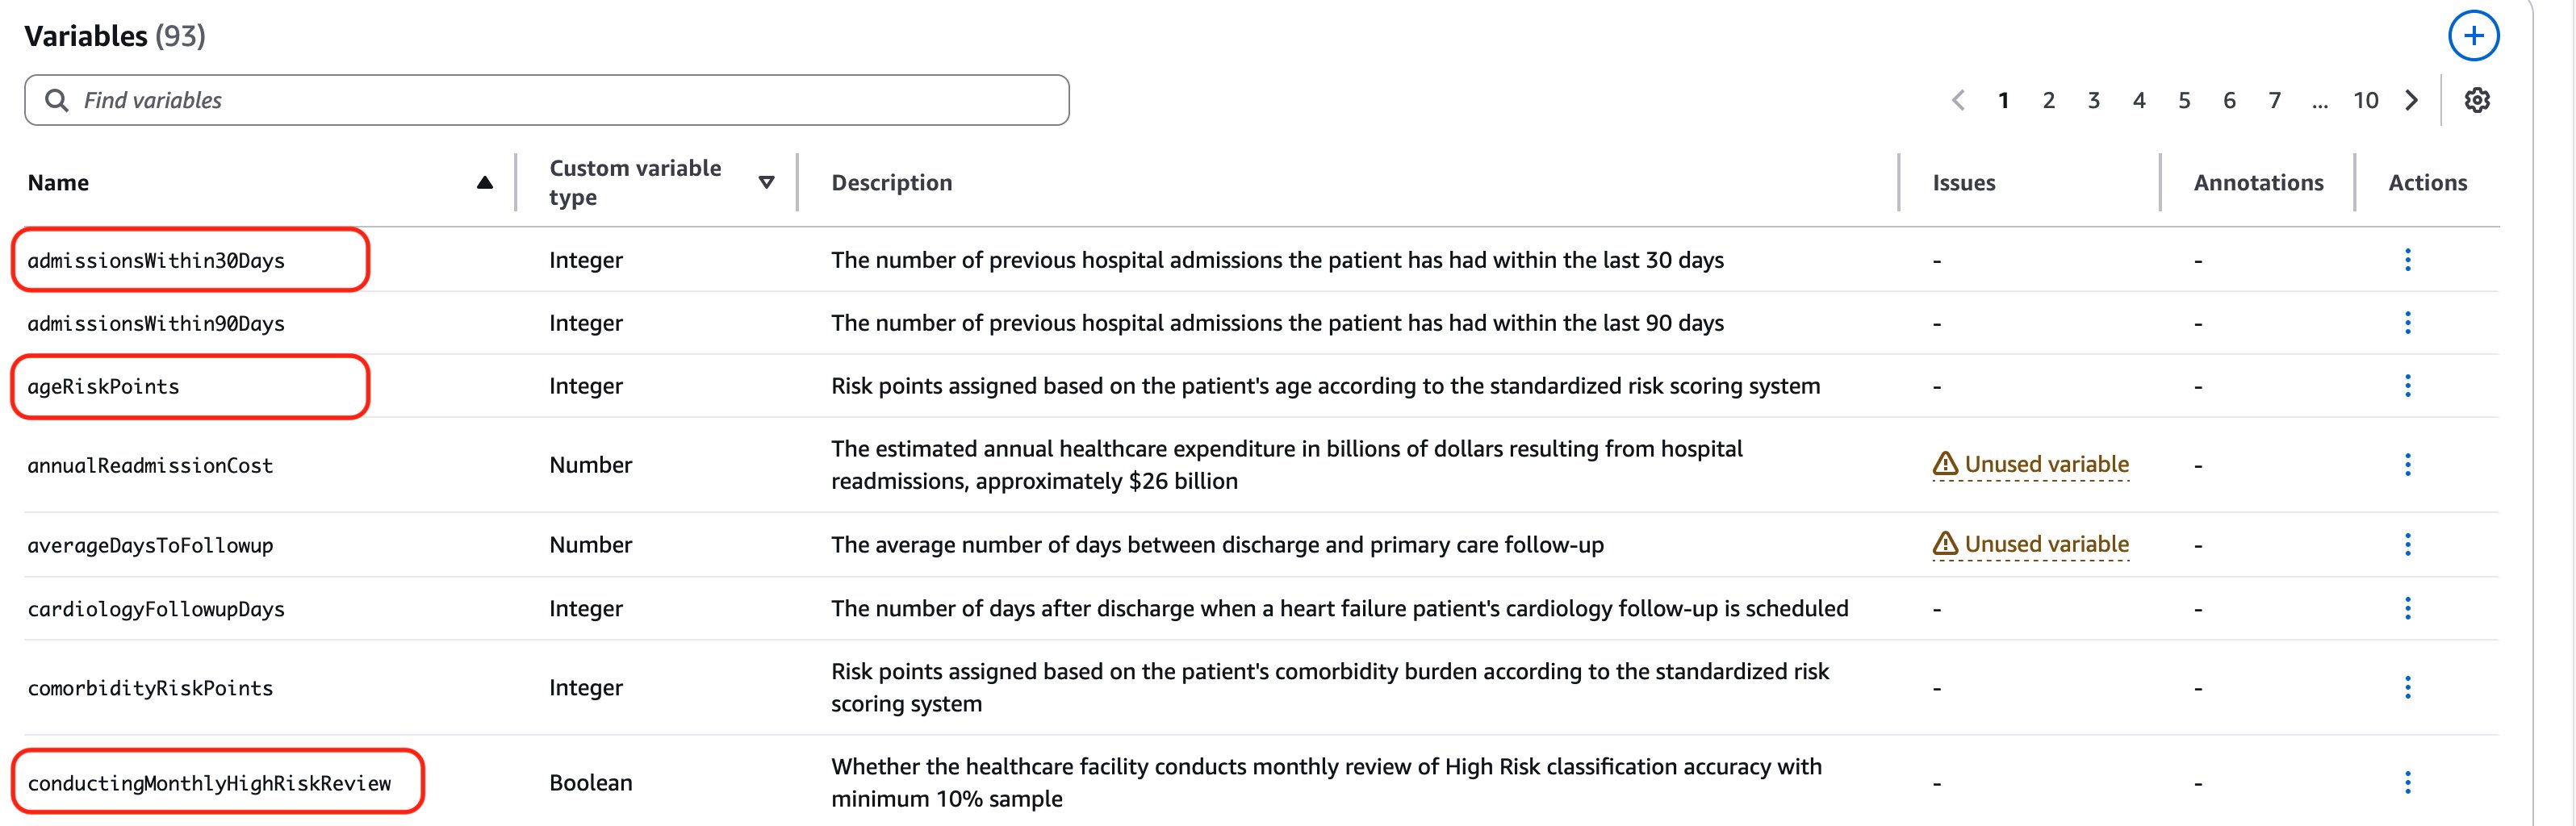
ポリシードキュメントを対象とした自動推論における変数とは、特定の型の情報 (整数、実数、ブール値など) を保持する名前付きのコンテナであり、ポリシー上の個別の概念や測定値を表します。変数はルールを構成する要素として機能し、ポリシー要件の追跡、測定、評価に使用できます。以下の画像では、admissionsWithin30Days (過去の入院回数を追跡する整数変数)、ageRiskPoints (年齢に基づくリスクスコアを保持する整数変数)、conductingMonthlyHighRiskReview (月次レビューを実施しているかどうかを示すブール変数) といった例が確認できます。各変数には、その目的と表現している具体的なポリシー概念についての明確な説明が付いており、ルール内でこれらの変数を使ってポリシー要件を適用し、コンプライアンスを測定できます。また、[問題] 列にも、一部の変数が使用されていないことが示されます。これらの変数がどの概念を表しているかを確認し、ルールが不足していないかを見極めることが特に重要です。
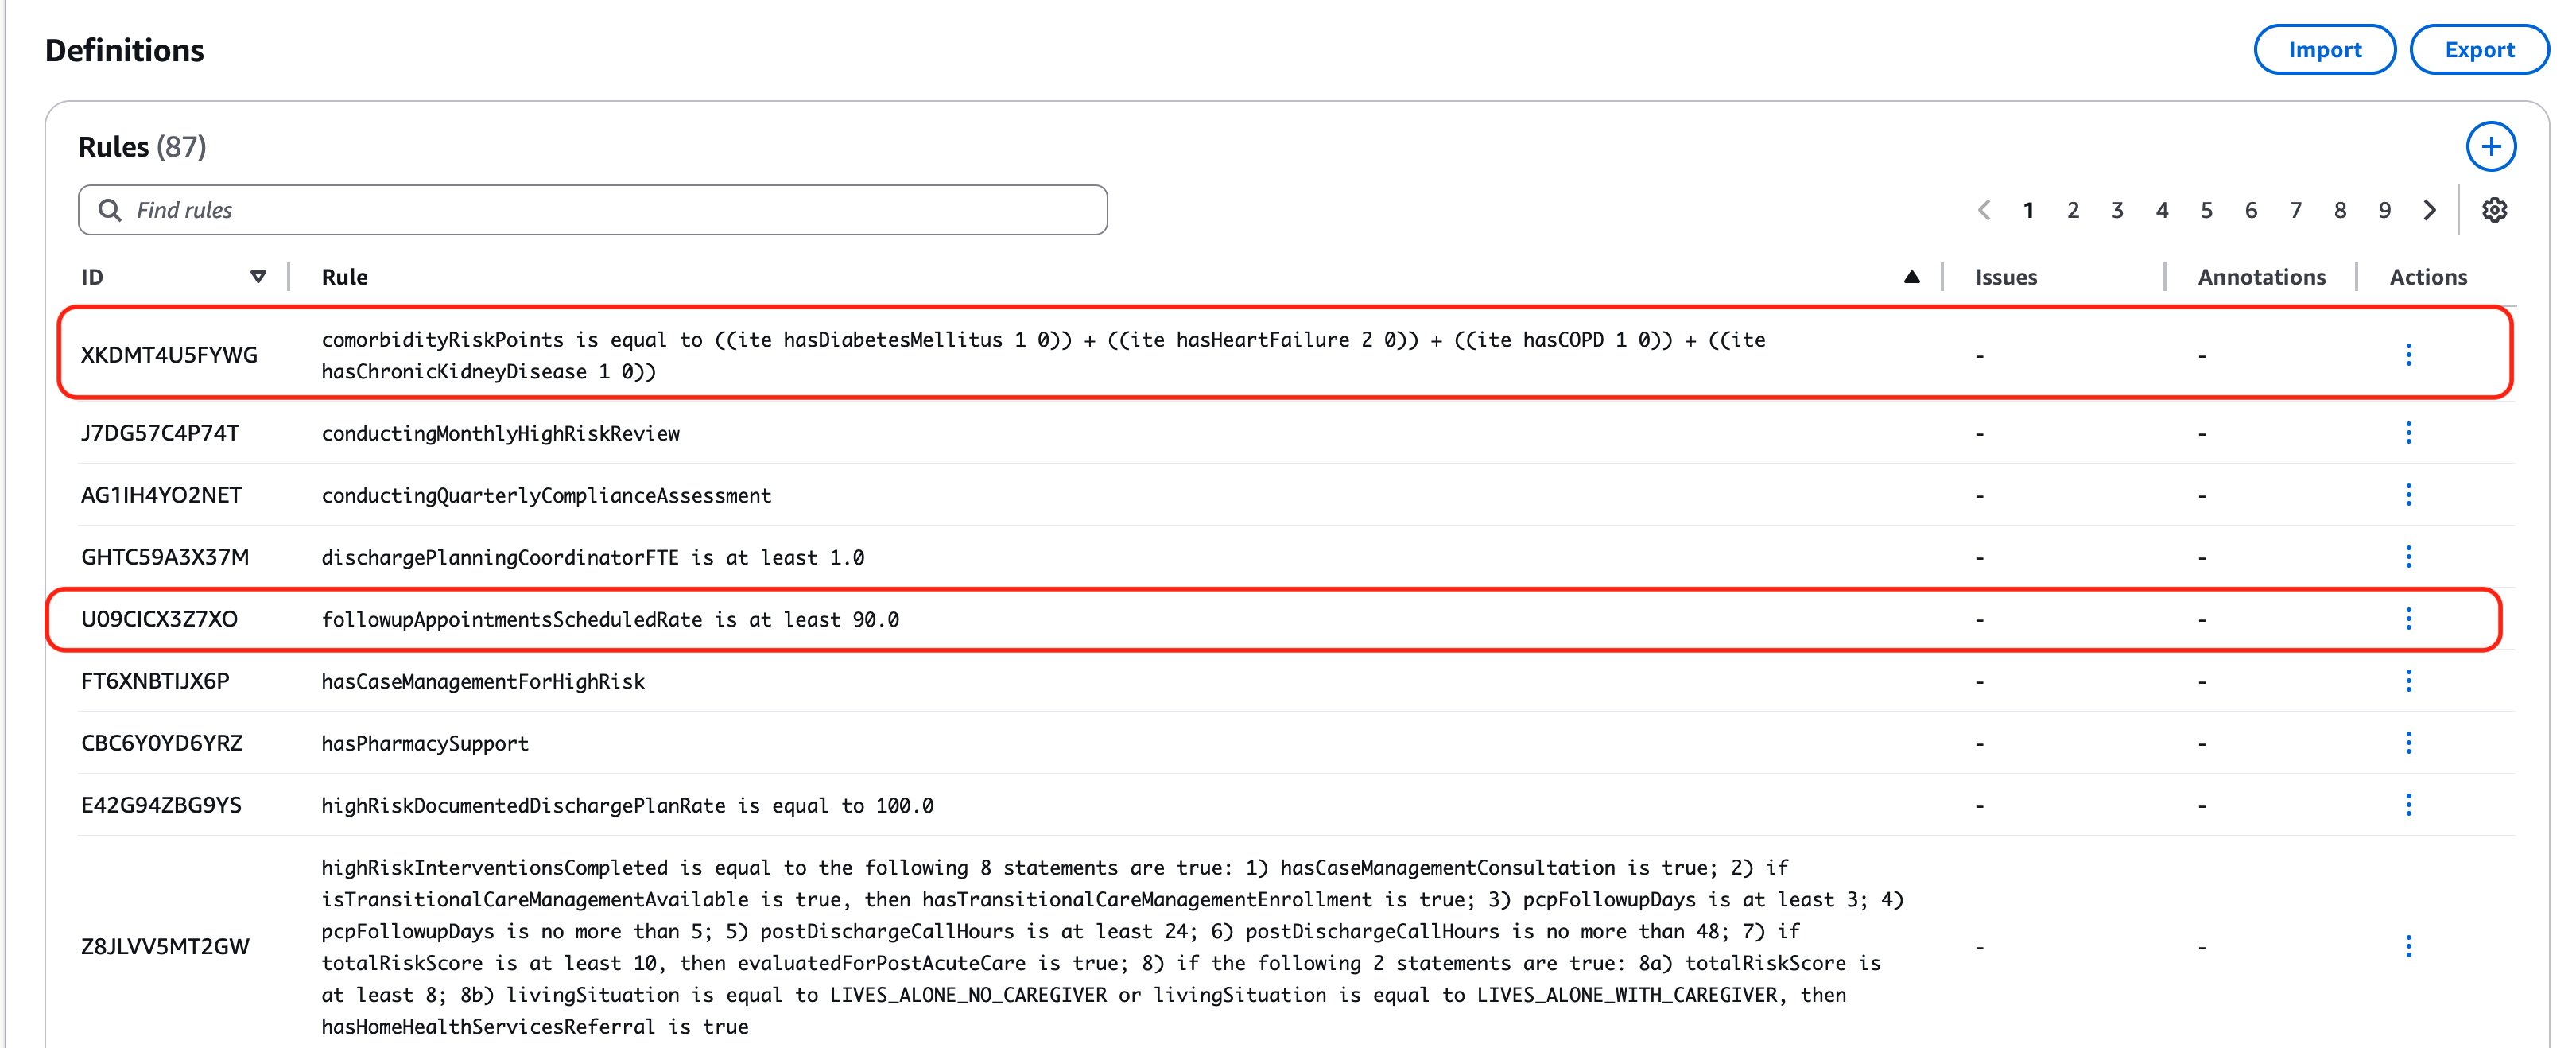
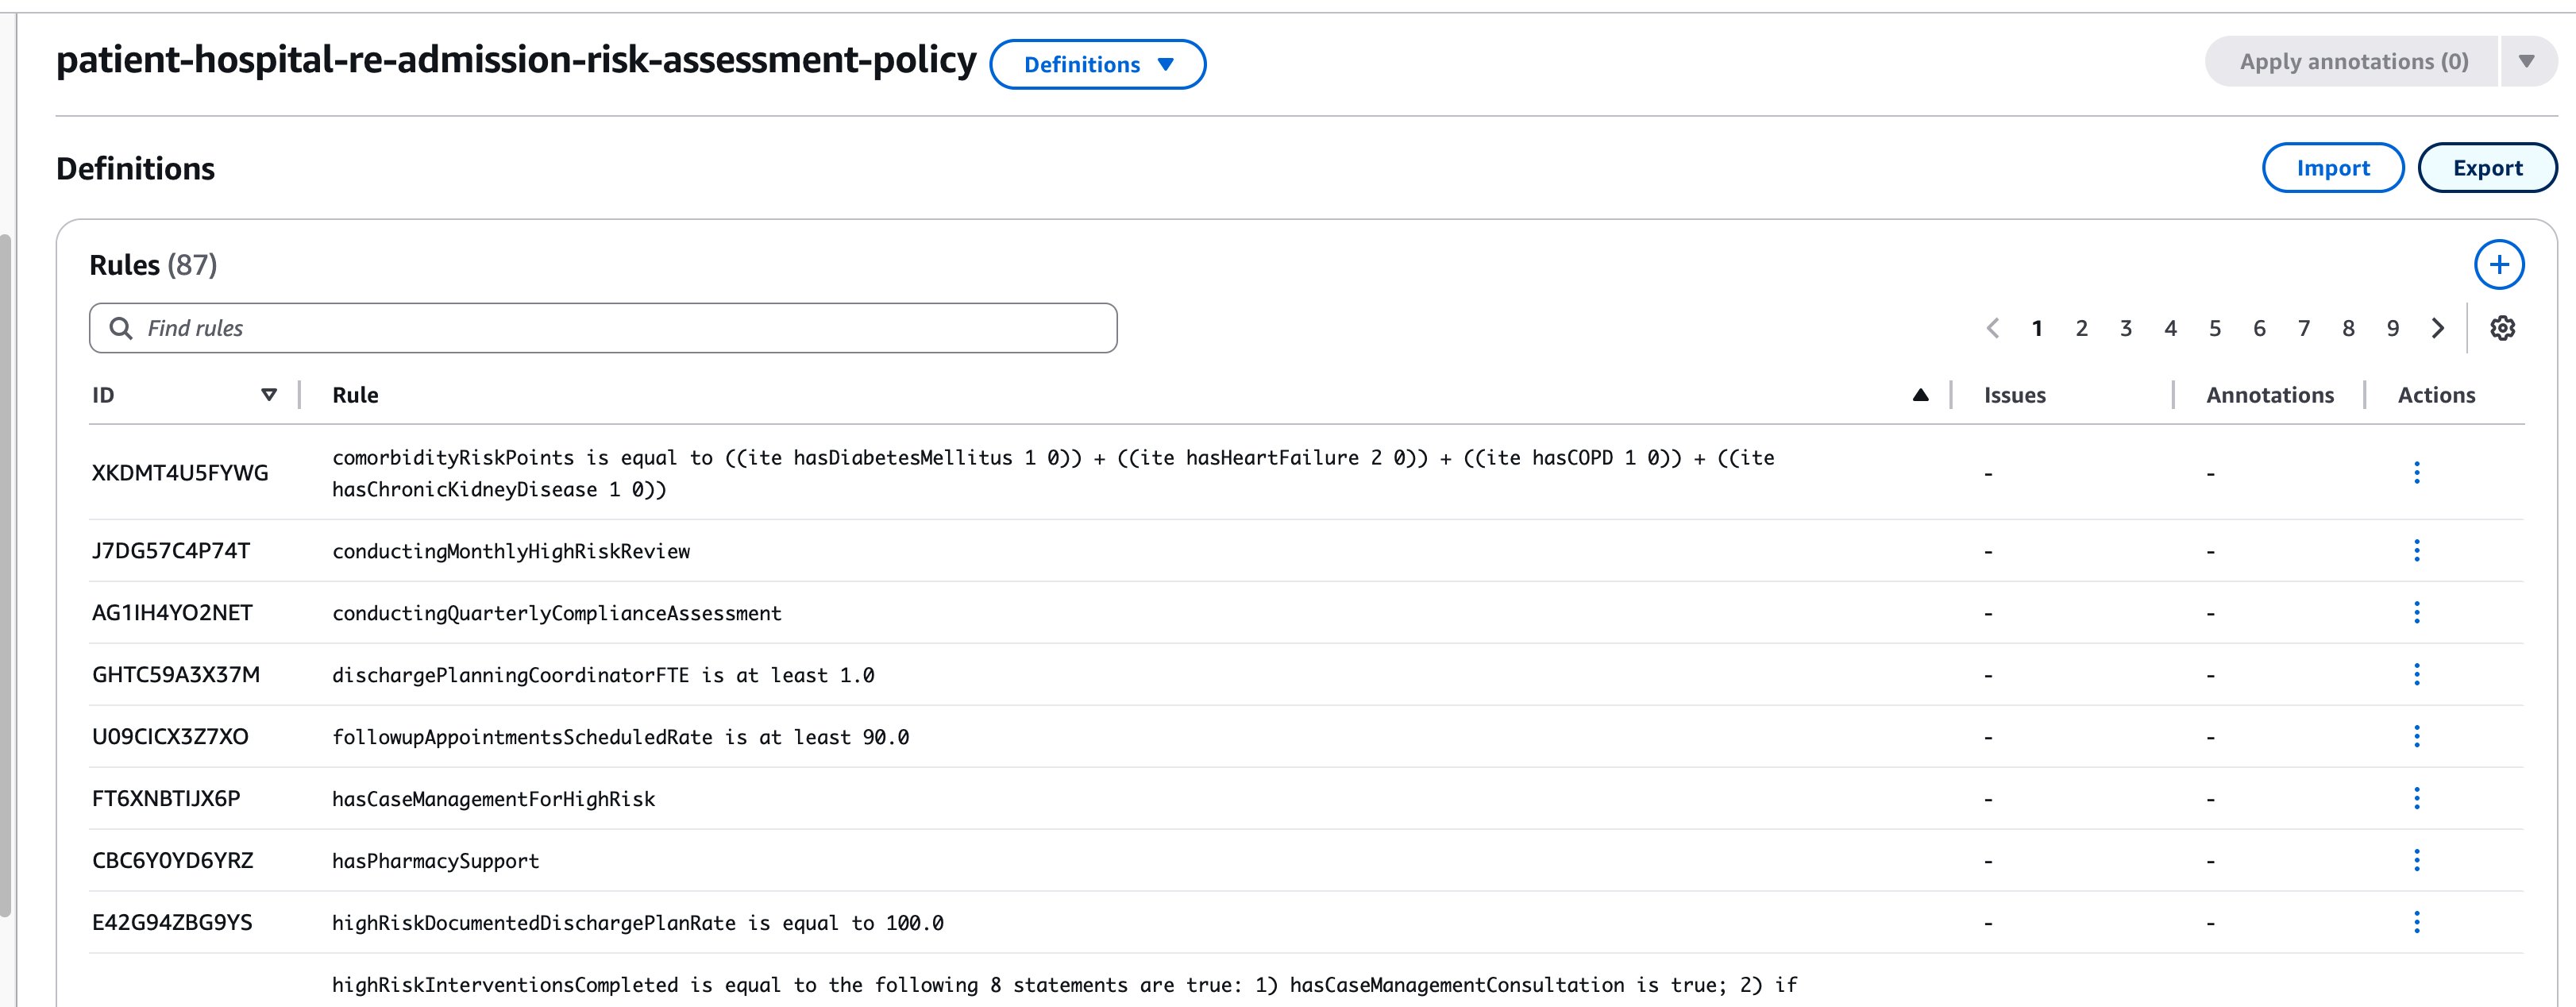
[定義] には [ルール]、[変数]、[型] が表示されます。ルールとは、自動推論がソースドキュメントから抽出するあいまいさのない論理ステートメントです。作成された次の単純なルールを見てみましょう。followupAppointmentsScheduledRate is at least 90.0 – このルールは「Section III A Process Measures」から作成されたもので、医療施設は各種のプロセス指標を監視し、退院前にフォローアップ受診の予約が完了している割合を 90% 以上にする、という内容です。
より複雑なルールを見てみましょう。
このルールは、ポリシードキュメントの規定どおり、患者が現在有している疾患、つまり併存疾患 (comorbidity) に基づいてリスクポイントを計算します。患者を評価する際、システムは 4 つの疾患を確認します。すなわち、あらゆる型の糖尿病 (1 ポイント)、あらゆる分類の心不全 (2 ポイント)、慢性閉塞性肺疾患 (1 ポイント)、慢性腎臓病ステージ 3~5 (1 ポイント) です。このルールはブール論理を用いてポイントを合算します。つまり、各条件の値 (true=1、false=0 として表現) に、その条件に割り当てられたポイント値を掛け、すべての値を足し合わせて併存疾患リスクスコアの合計を求めます。例えば、患者が心不全と糖尿病の両方を有する場合は合計 3 ポイント (心不全の 2 ポイントに糖尿病の 1 ポイントを加算) となります。この併存疾患スコアは、患者の全体的な再入院リスクカテゴリを判定する、より大きなリスク評価フレームワークの一部となります。
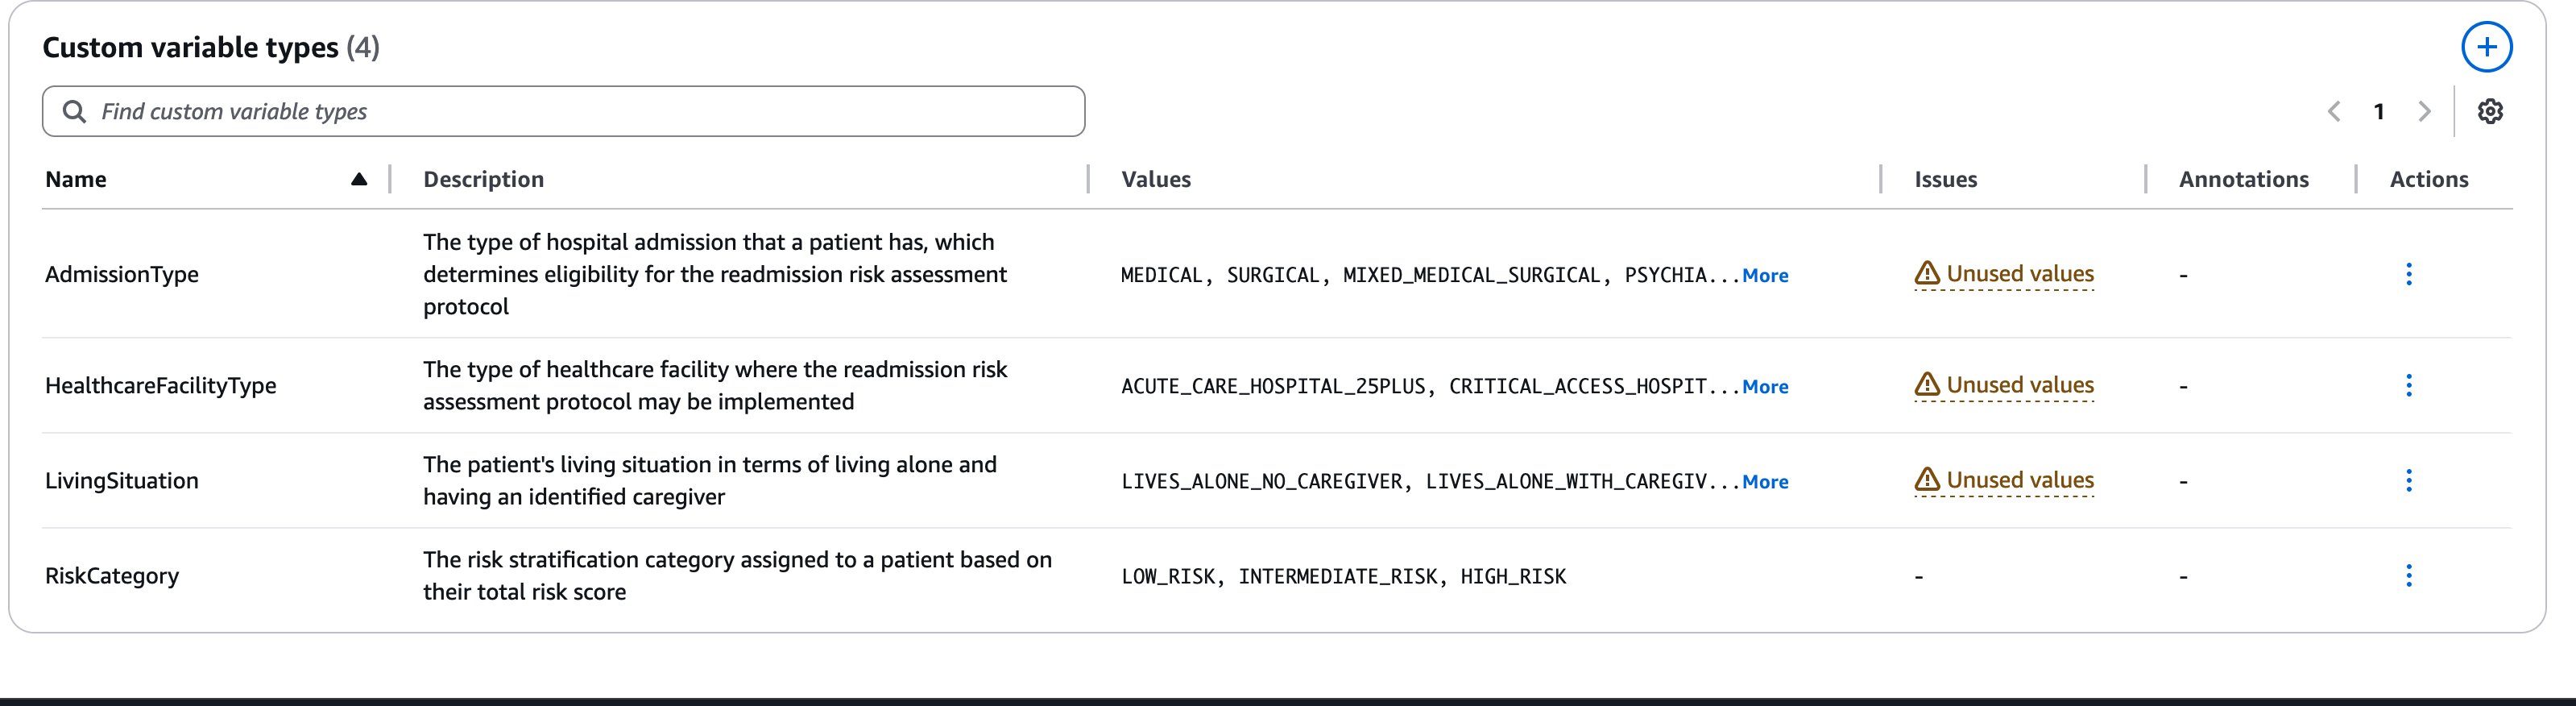
[定義] には、カスタム変数型も含まれます。カスタム変数型は列挙型 (ENUM) とも呼ばれ、特定のポリシー概念について、許容される値を固定された集合として定義する専用のデータ構造です。値をポリシー要件に沿った事前定義済みの選択肢に限定することで、データ収集とルール適用における一貫性と正確性を保ちます。サンプルポリシーでは、4 つのカスタム変数型が特定されています。
AdmissionType: 患者が再入院リスク評価プロトコルの対象となるかどうかを判定する、入院の種類 (MEDICAL、SURGICAL、MIXED_MEDICAL_SURGICAL、PSYCHIATRIC) を定義します。HealthcareFacilityType: 再入院リスク評価プロトコルを実施できる医療施設の種類 (ACUTE_CARE_HOSPITAL_25PLUS、CRITICAL_ACCESS_HOSPITAL) を指定します。LivingSituation: 患者の居住状況 (LIVES_ALONE_NO_CAREGIVER、LIVES_ALONE_WITH_CAREGIVER) を分類します。これは社会的支援とリスクレベルを判定するうえで重要な要因です。RiskCategory: 合計リスクスコアに基づいて患者に割り当てられる 3 段階のリスク層別化レベル (LOW_RISK、INTERMEDIATE_RISK、HIGH_RISK) を定義します。
健全性 (自動推論チェックが VALID と判定したときの精度) を高めるうえで重要なのが、取り込まれたルール、変数、型が正とすべき情報源 (source of truth) を最もよく表現しているかを確認する、ポリシー改善のステップです。ここからはテストスイートに移り、テストの追加方法、テストの生成方法、そしてテスト結果を使ってルールを更新する注釈の適用方法を見ていきます。
自動推論ポリシーのテストとポリシーの改善
自動推論のテストスイートは、2 つの目的でテスト機能を提供します。1 つ目は、さまざまなシナリオを実行して自動推論ポリシー内のルールと変数をテストし、それらが正とすべき事実 (グラウンドトゥルース) を正確に表現するように改善することです。このポリシー改善のステップは、自動推論チェックの健全性を高めるために重要です。2 つ目は、定義したポリシーとユースケースに対して自動推論チェックがどの程度機能しているかを把握するための指標を得ることです。そのために、自動推論コンソールで [テスト] タブを開きます。
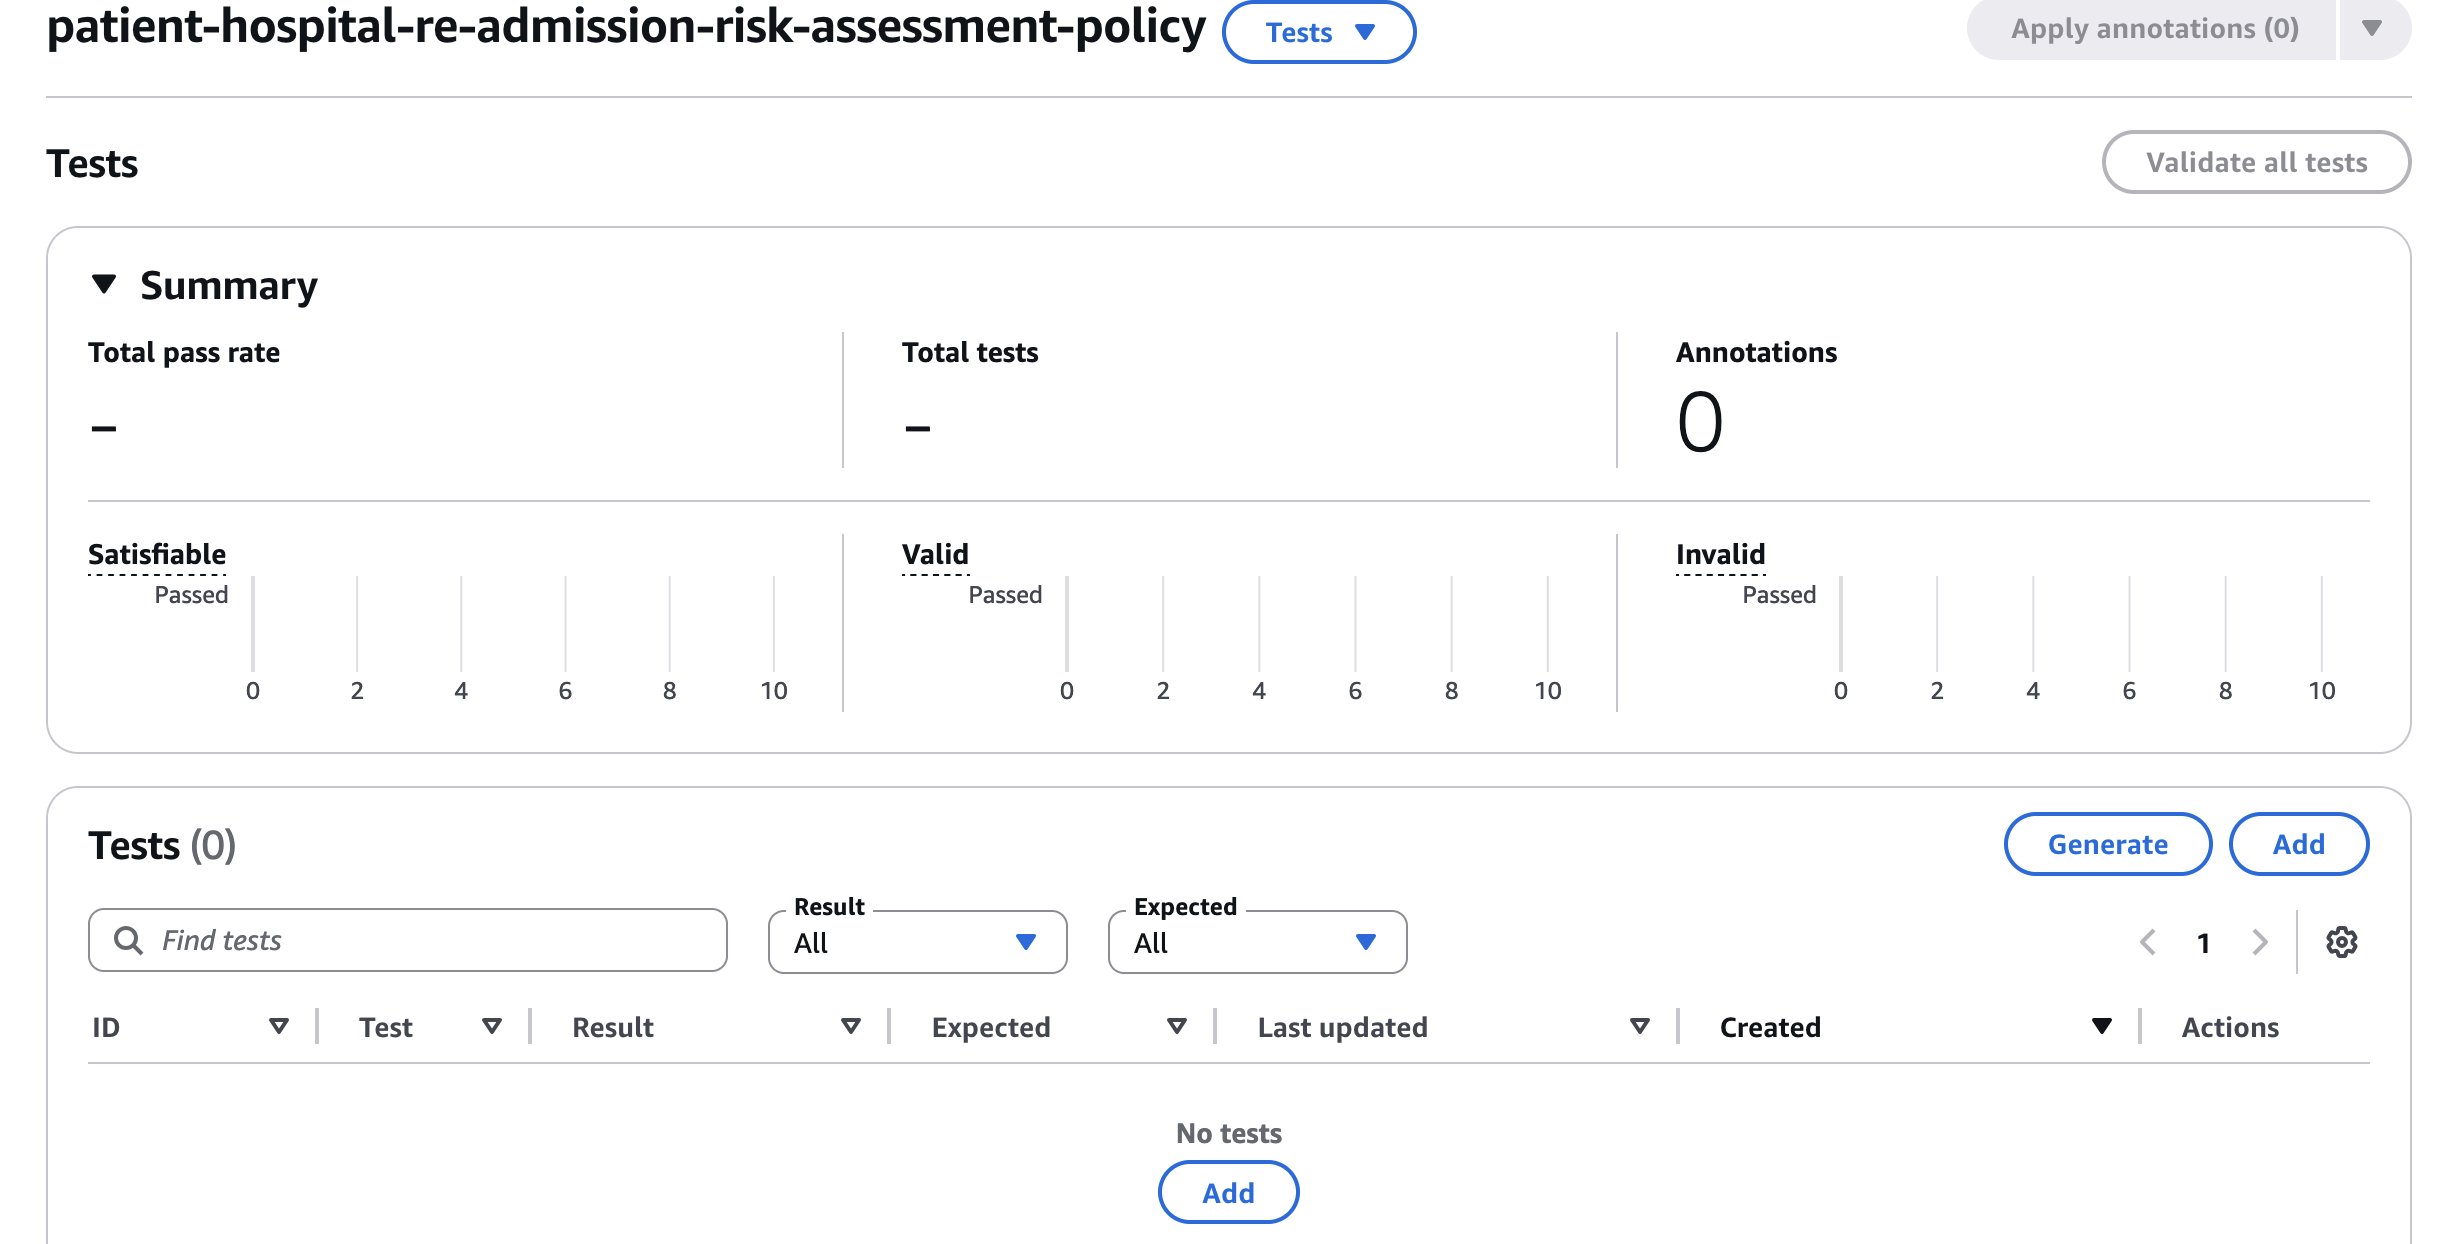
テストサンプルは [追加] ボタンで手動で追加できます。テストの規模を拡大するには、ポリシールールからテストを生成する方法もあります。このテスト手法は、ポリシーの意味的な正しさ (ルールが意図したポリシー制約を正確に表現していること) と、自然言語の変換能力 (ユーザーがアプリケーションを操作する際に使う言葉をシステムが正しく解釈できること) の両方を検証するのに役立ちます。以下の画像では、生成されたテストサンプルが確認できます。テストスイートに追加する前に、対象分野の専門家 (SME) はこのテストサンプルが起こり得る (サムズアップ) か、起こり得ない (サムズダウン) かを判断します。その後、テストサンプルをテストスイートに保存できます。
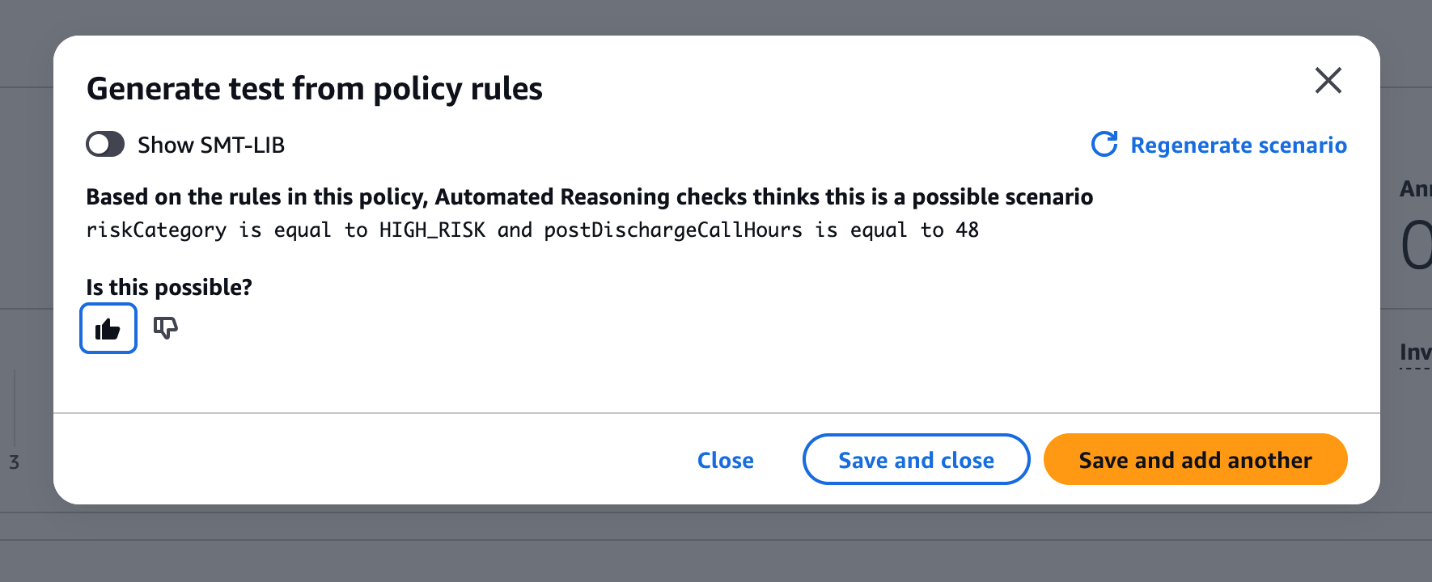
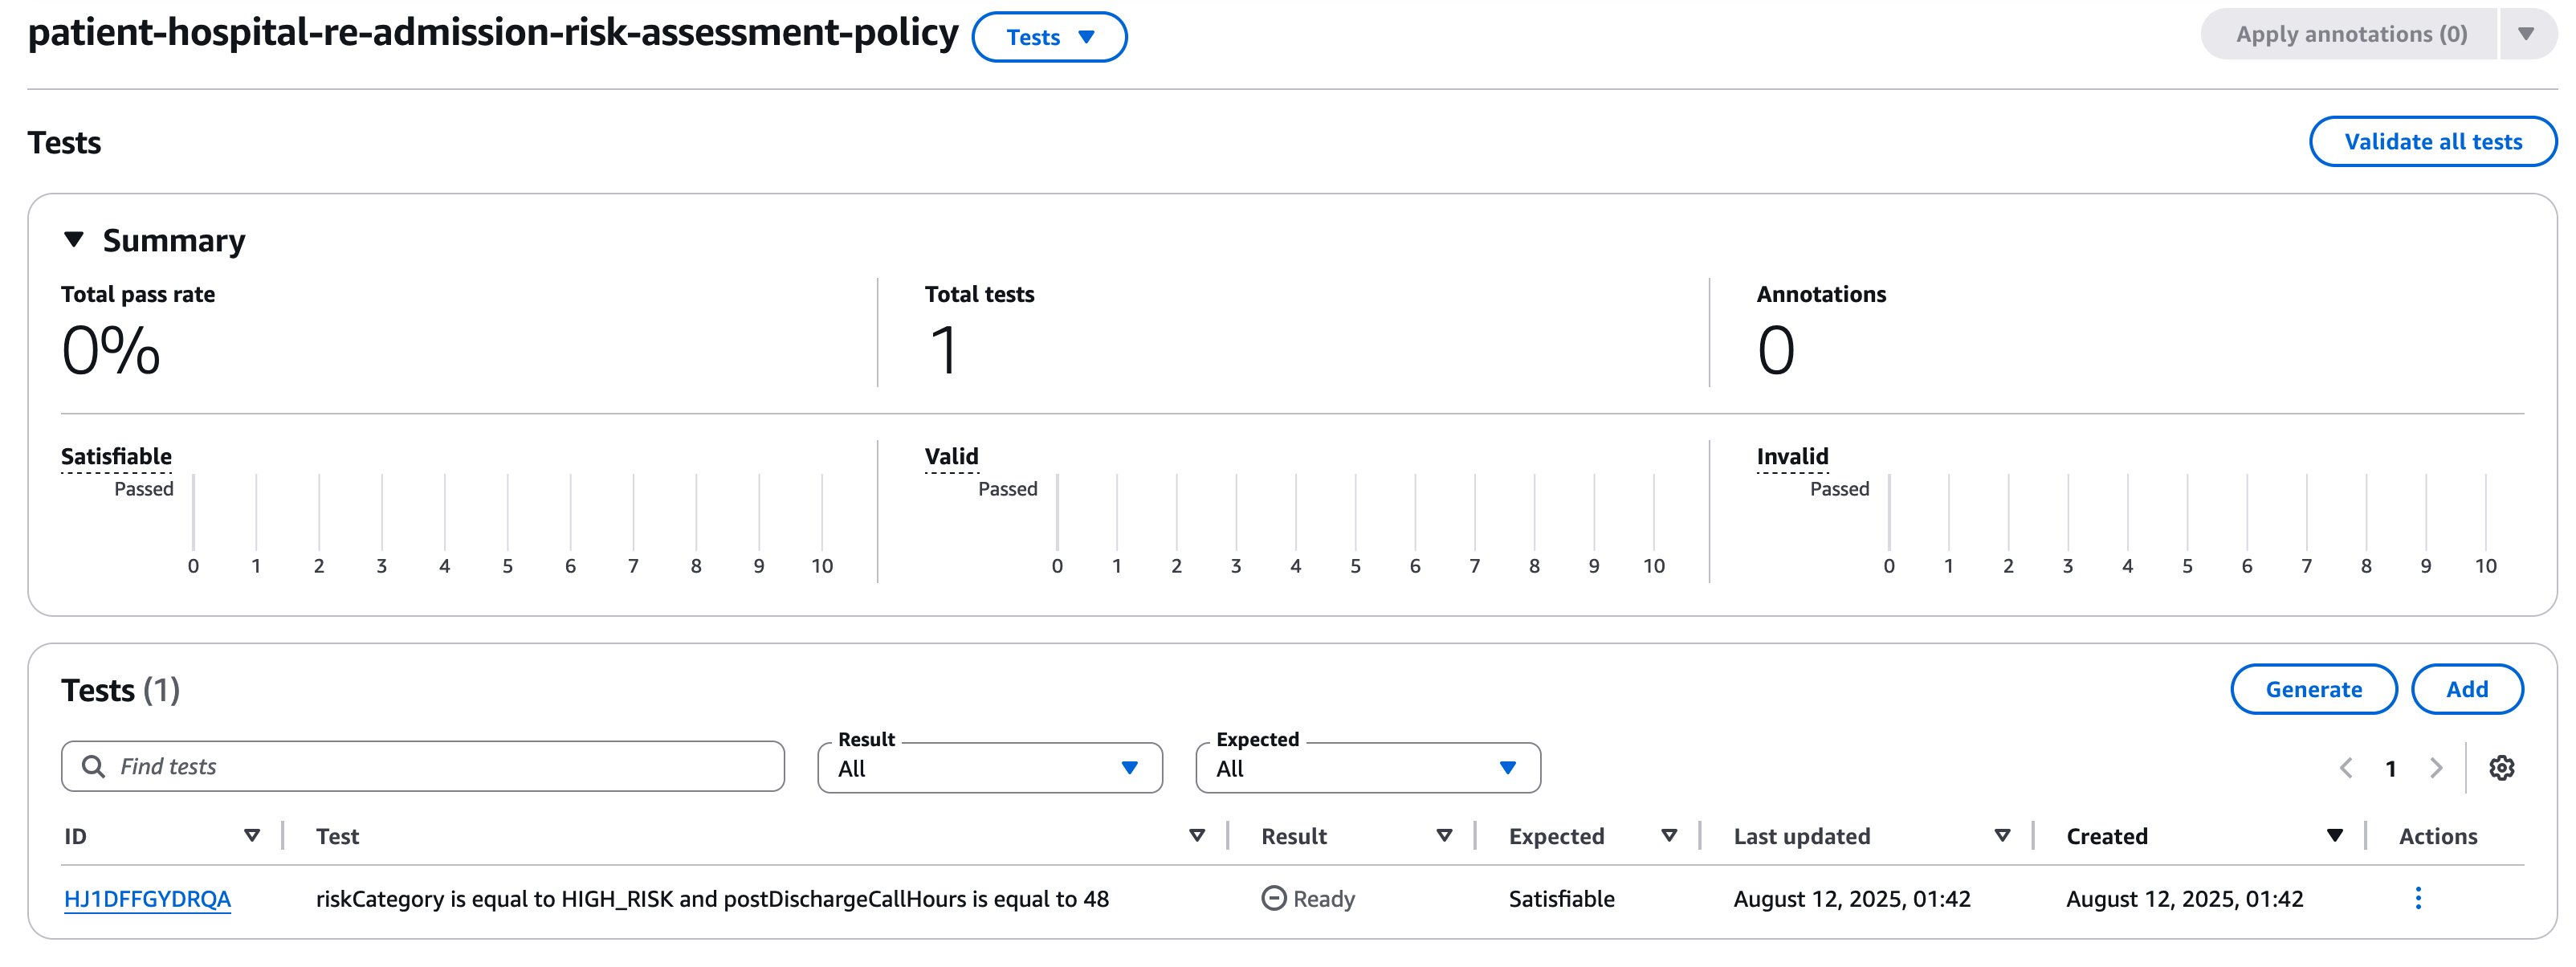
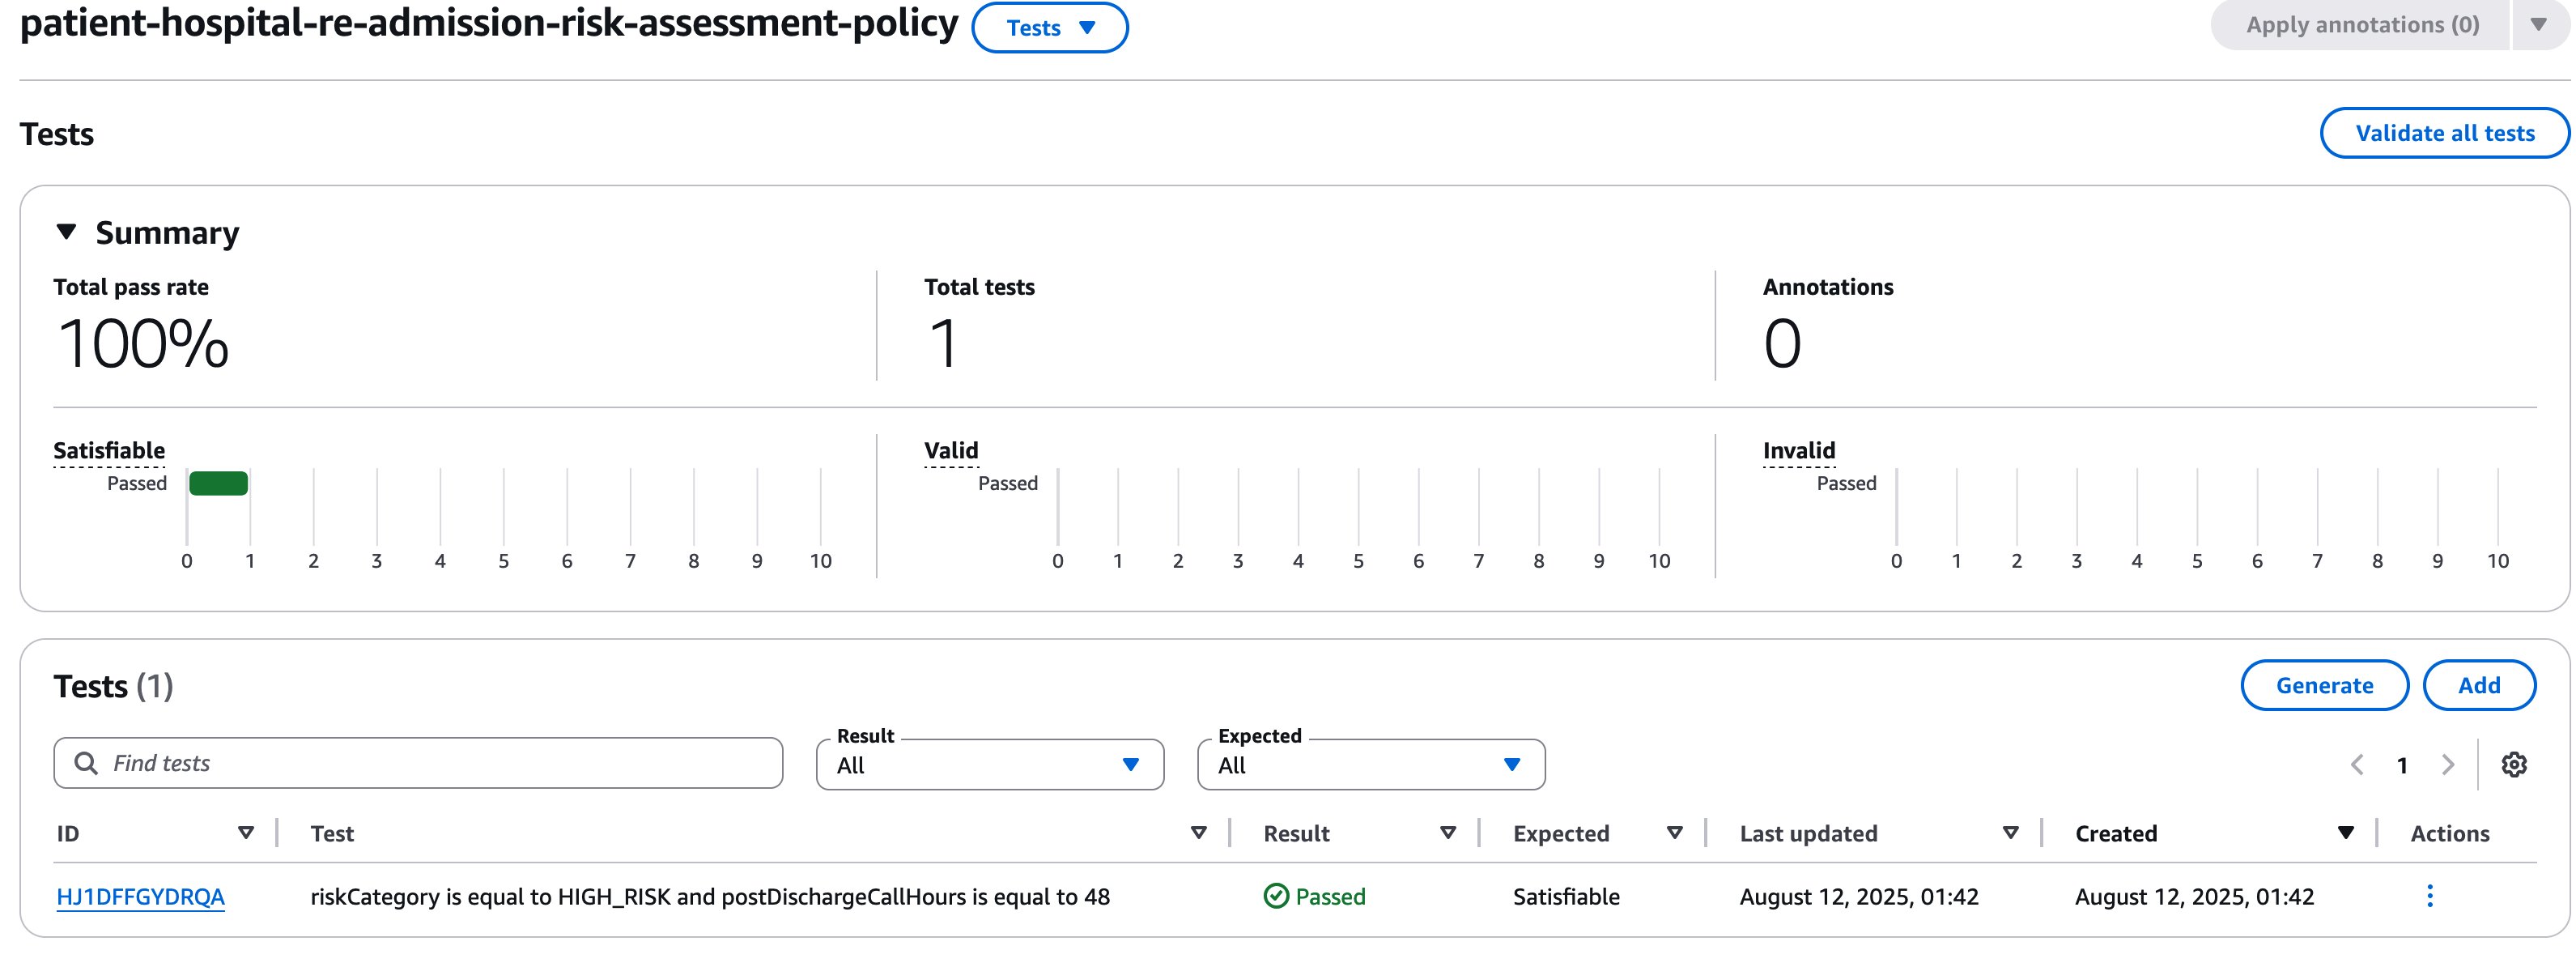
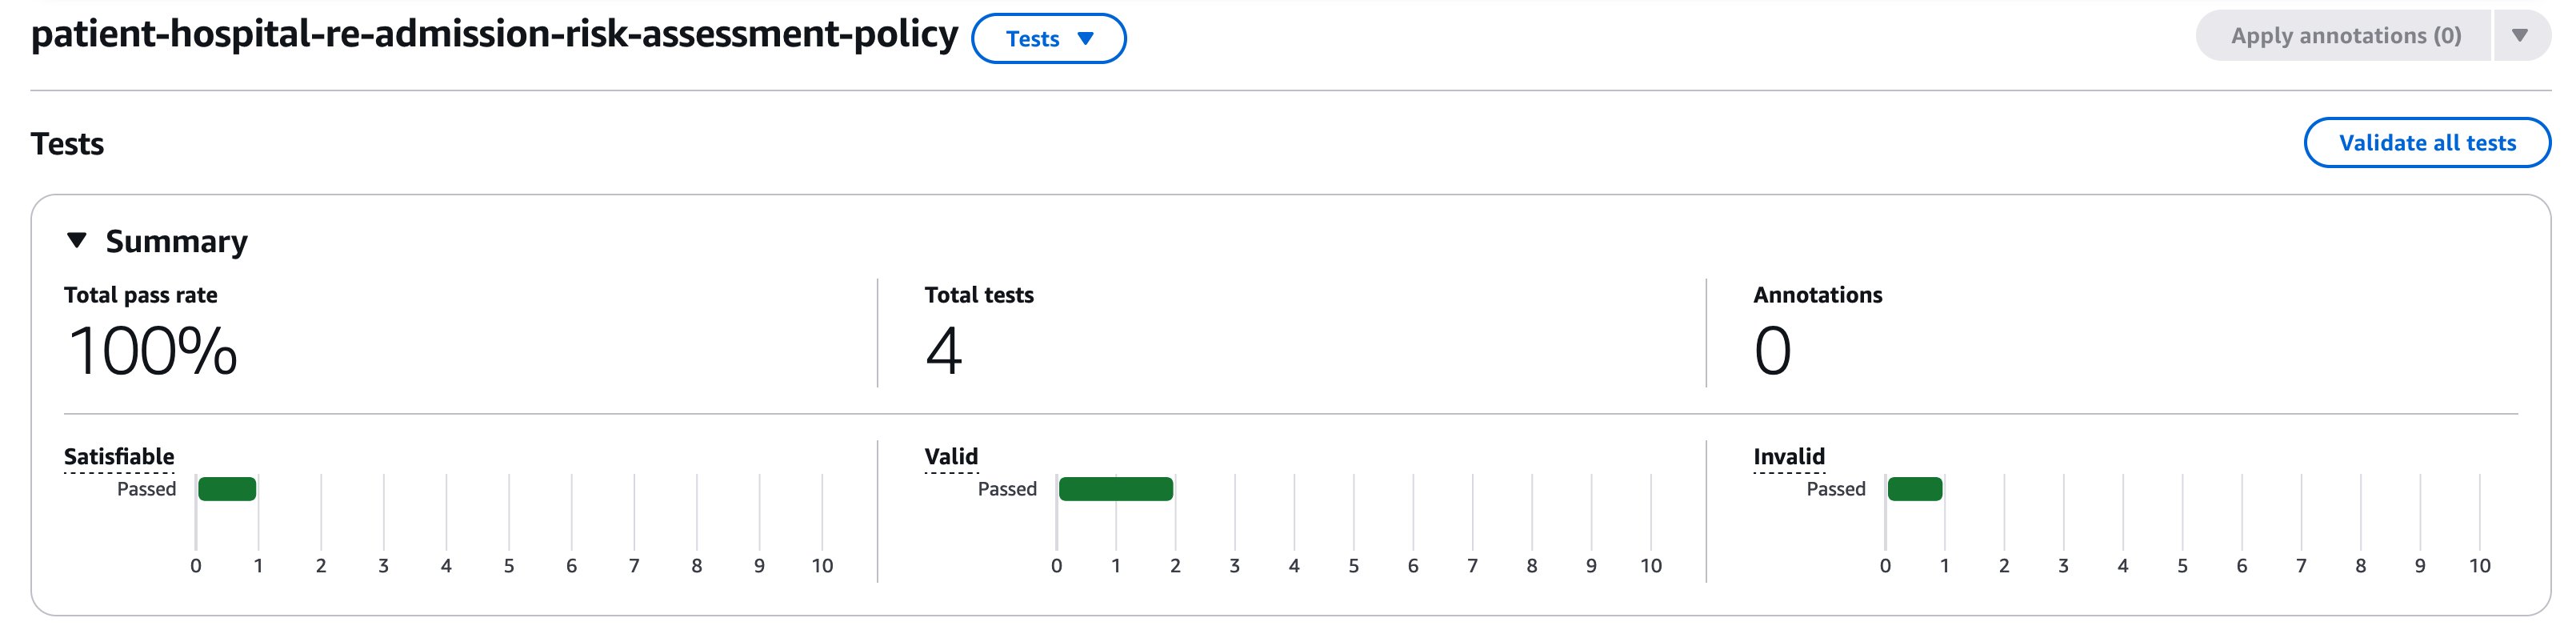
テストサンプルを作成したら、そのサンプル単独で実行することも、[すべてのテストを検証] を選択してテストスイート内のすべてのテストサンプルを実行することもできます。実行すると、このテストが正常に合格したことがわかります。
入力 (任意) と出力を指定して、テストを手動で作成することもできます。これらは検証の前に論理表現へ変換されます。
変換の仕組み
変換では、自然言語のテストが、ポリシールールに照らして数学的に検証できる論理表現に置き換えられます。
- 自動推論チェックは複数の LLM を使用して、入力と出力を論理的な検出結果へ変換します
- 各変換には、その品質を示す信頼度が複数モデルの投票によって付与されます
- 信頼度しきい値を設定して、どの検出結果を検証して返すかを制御できます
信頼度しきい値の動作
信頼度しきい値は、どの変換を検証に足るほど信頼できるとみなすかを制御し、厳格さと網羅性のバランスを取ります。
- しきい値を高くする: 変換精度の確実性は高まりますが、検出結果が 1 つも検証されない可能性も高くなります
- しきい値を低くする: 検証済みの検出結果が返される可能性は高まりますが、変換の確実性は低くなることがあります
- しきい値 = 0: 信頼度にかかわらず、すべての検出結果が検証されて返されます
あいまいな結果
信頼度しきい値を満たす検出結果がない場合、自動推論チェックは「TRANSLATION_AMBIGUOUS」を返し、コンテンツの論理的な解釈に不確実性があることを示します。ここで作成して検証するテストケースは次のとおりです。
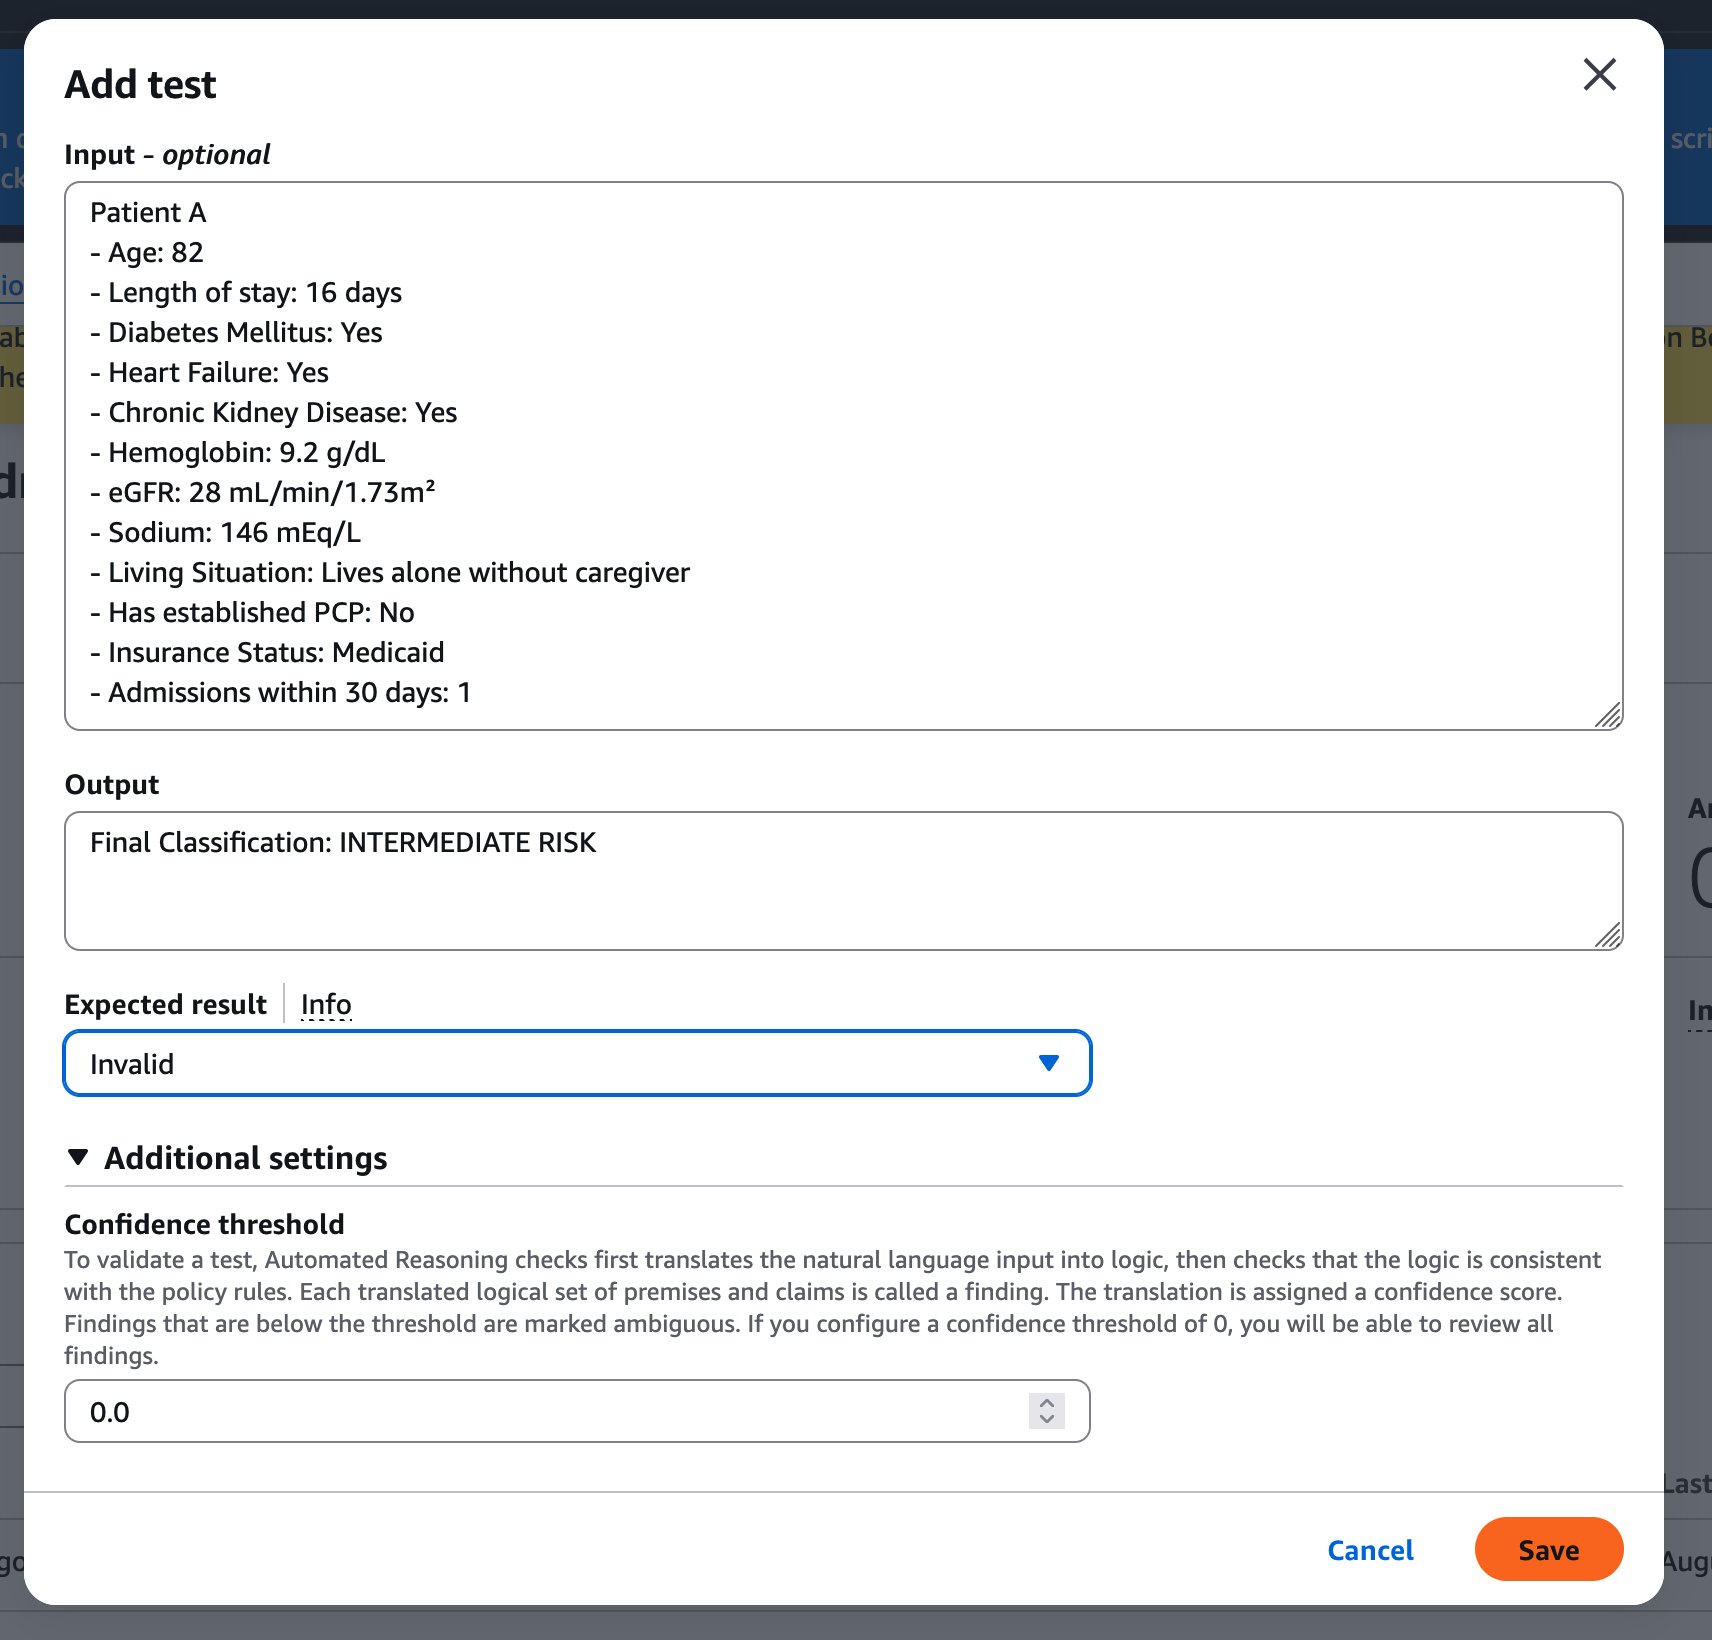
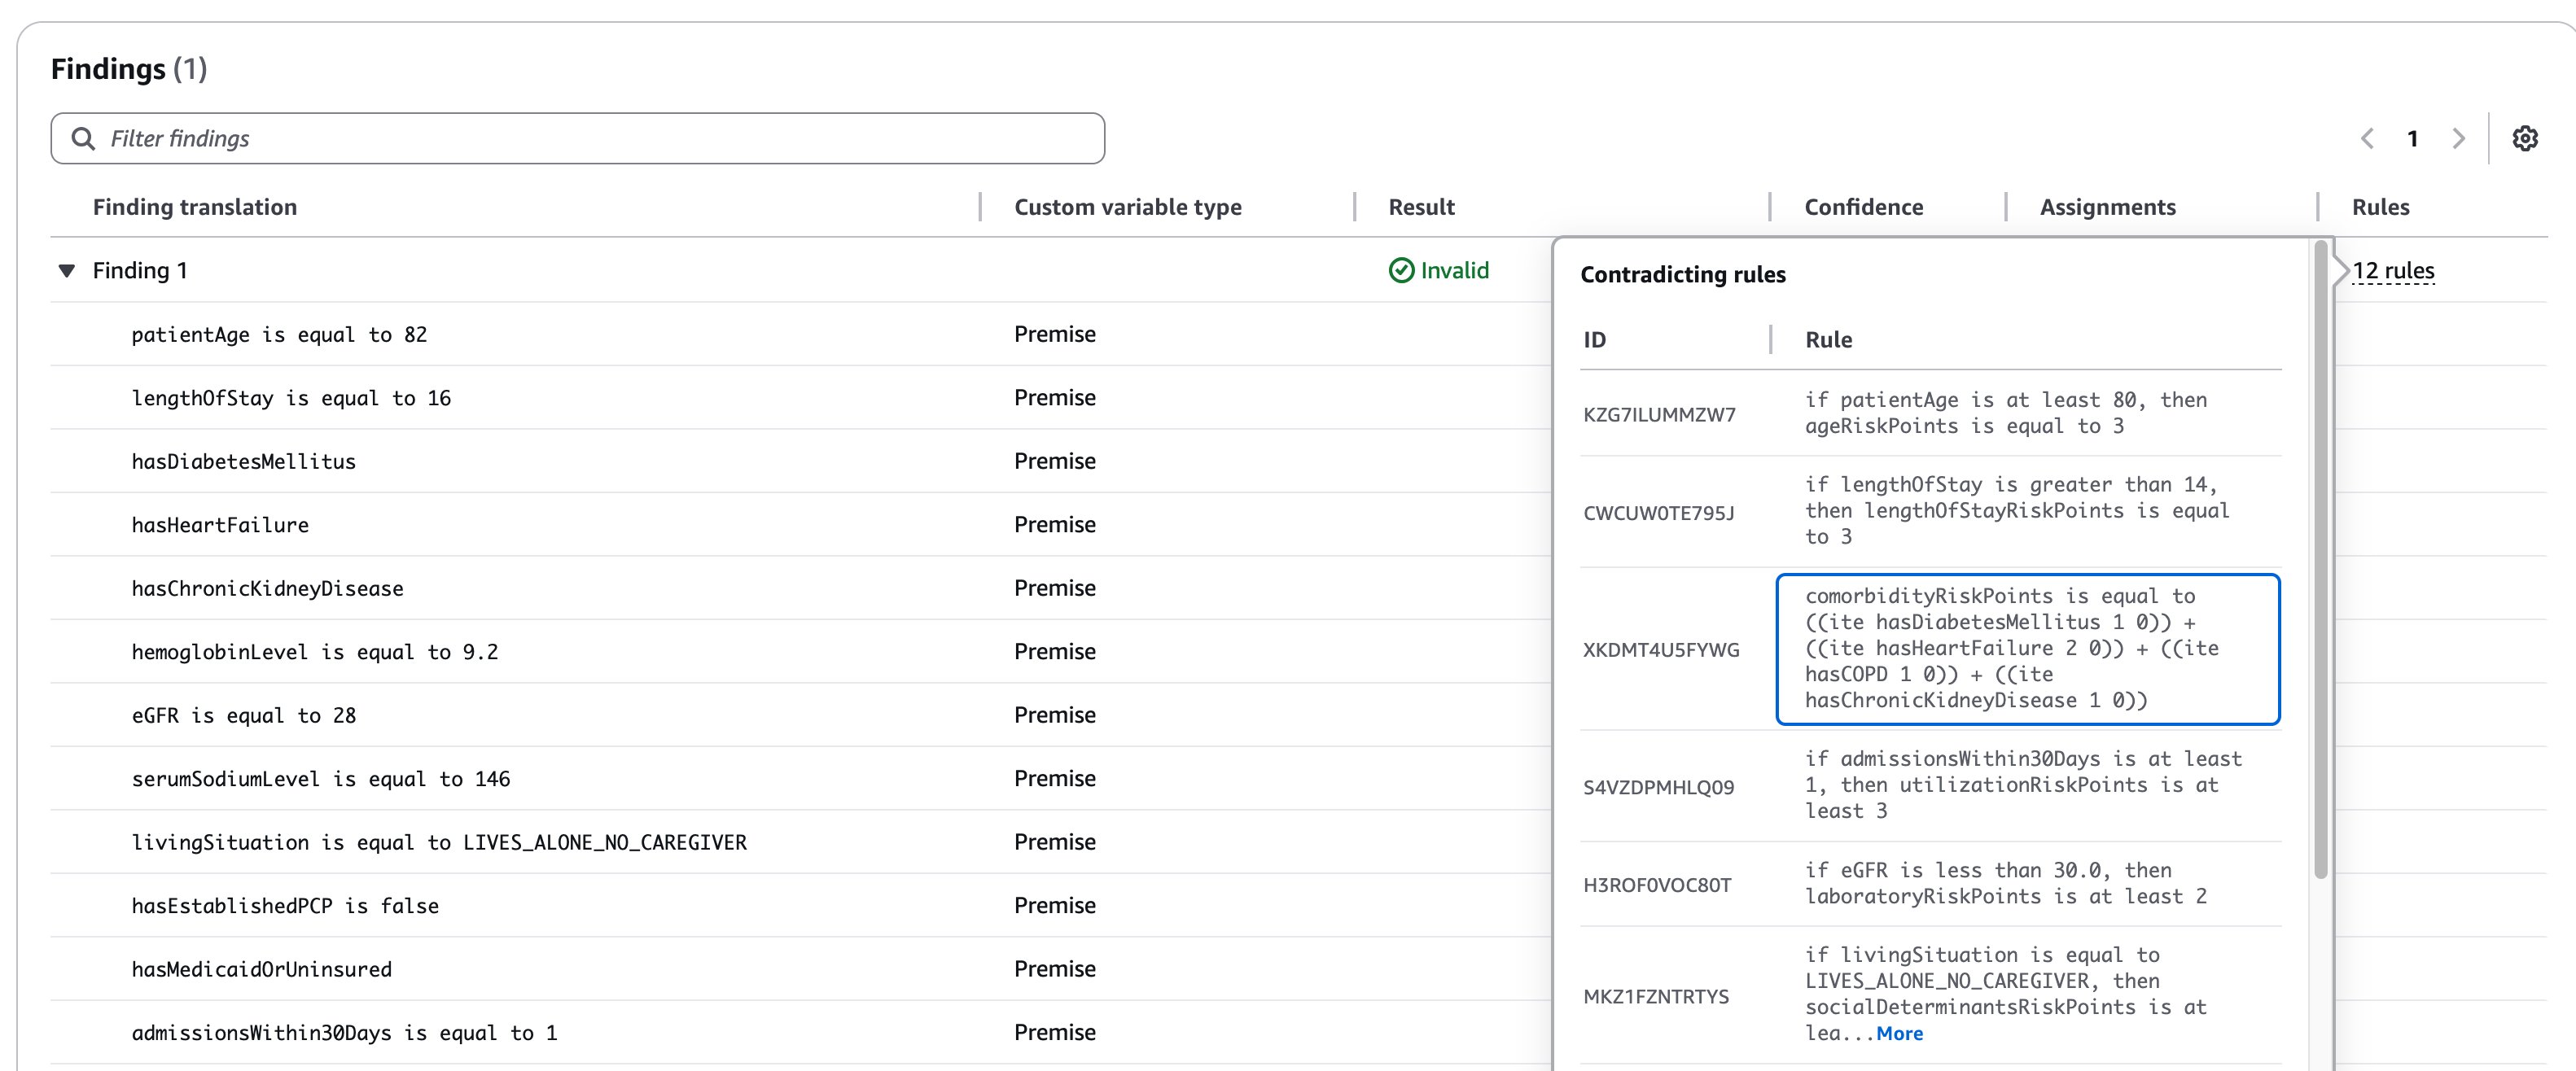
実行すると、このテストは合格し、「INVALID」という結果が期待どおりであることがわかります。さらに、自動推論チェックは、12 個のルールが前提と主張に矛盾していたことも示しています。この矛盾によって、テストサンプルの出力が「INVALID」となりました。
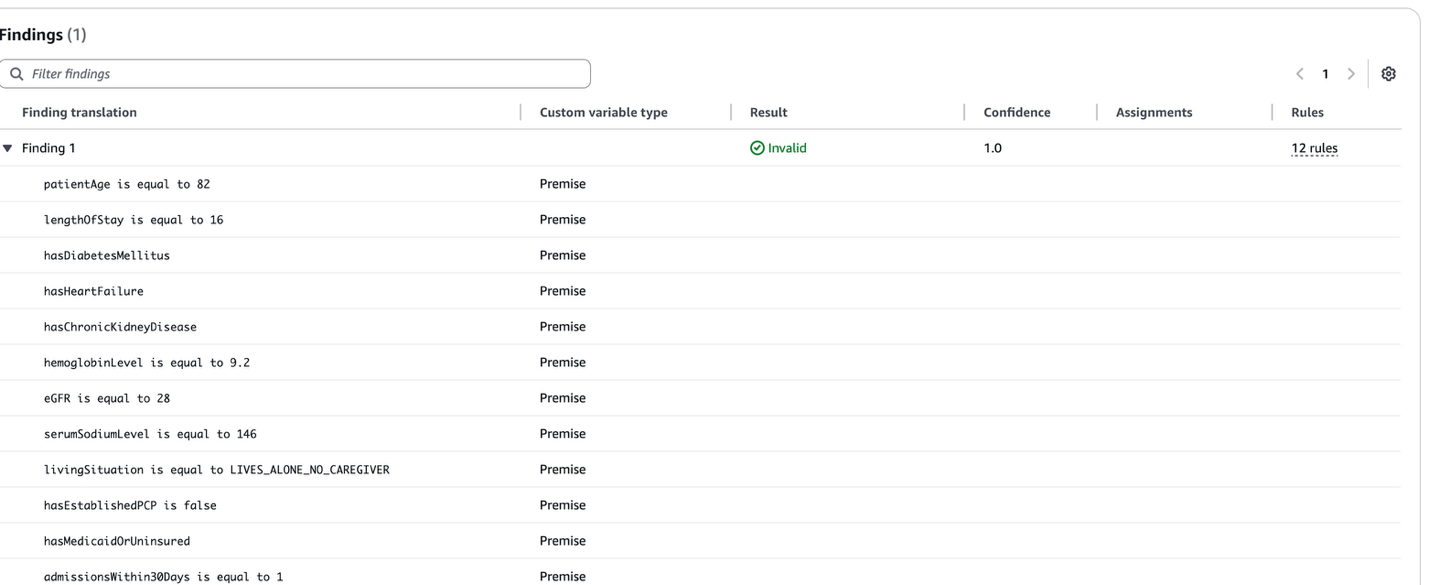
表示されている矛盾するルールのうち、いくつかを見てみましょう。
- 年齢リスク: 患者は 82 歳
- トリガーされるルール: 「patientAge が 80 以上の場合、ageRiskPoints は 3 に等しい」
- 在院日数リスク: 患者の在院日数は 16 日
- トリガーされるルール: 「lengthOfStay が 14 より大きい場合、lengthOfStayRiskPoints は 3 に等しい」
- 併存疾患リスク: 患者は複数の疾患を有する
- ルールの計算: 「comorbidityRiskPoints = (hasDiabetesMellitus × 1) + (hasHeartFailure × 2) + (hasCOPD × 1) + (hasChronicKidneyDisease × 1)」
- 利用状況リスク: 患者は 30 日以内に 1 回の入院あり
- トリガーされるルール: 「admissionsWithin30Days が 1 以上の場合、utilizationRiskPoints は 3 以上」
- 検査値リスク: 患者の eGFR は 28
- トリガーされるルール: 「eGFR が 30.0 未満の場合、laboratoryRiskPoints は 2 以上」
これらのルールは矛盾するリスクスコアを生成している可能性が高く、そのためシステムは有効な最終リスクカテゴリを判定できません。これらの矛盾から、テストの入力テキストが INVALID と判定された根拠となるルールがわかります。
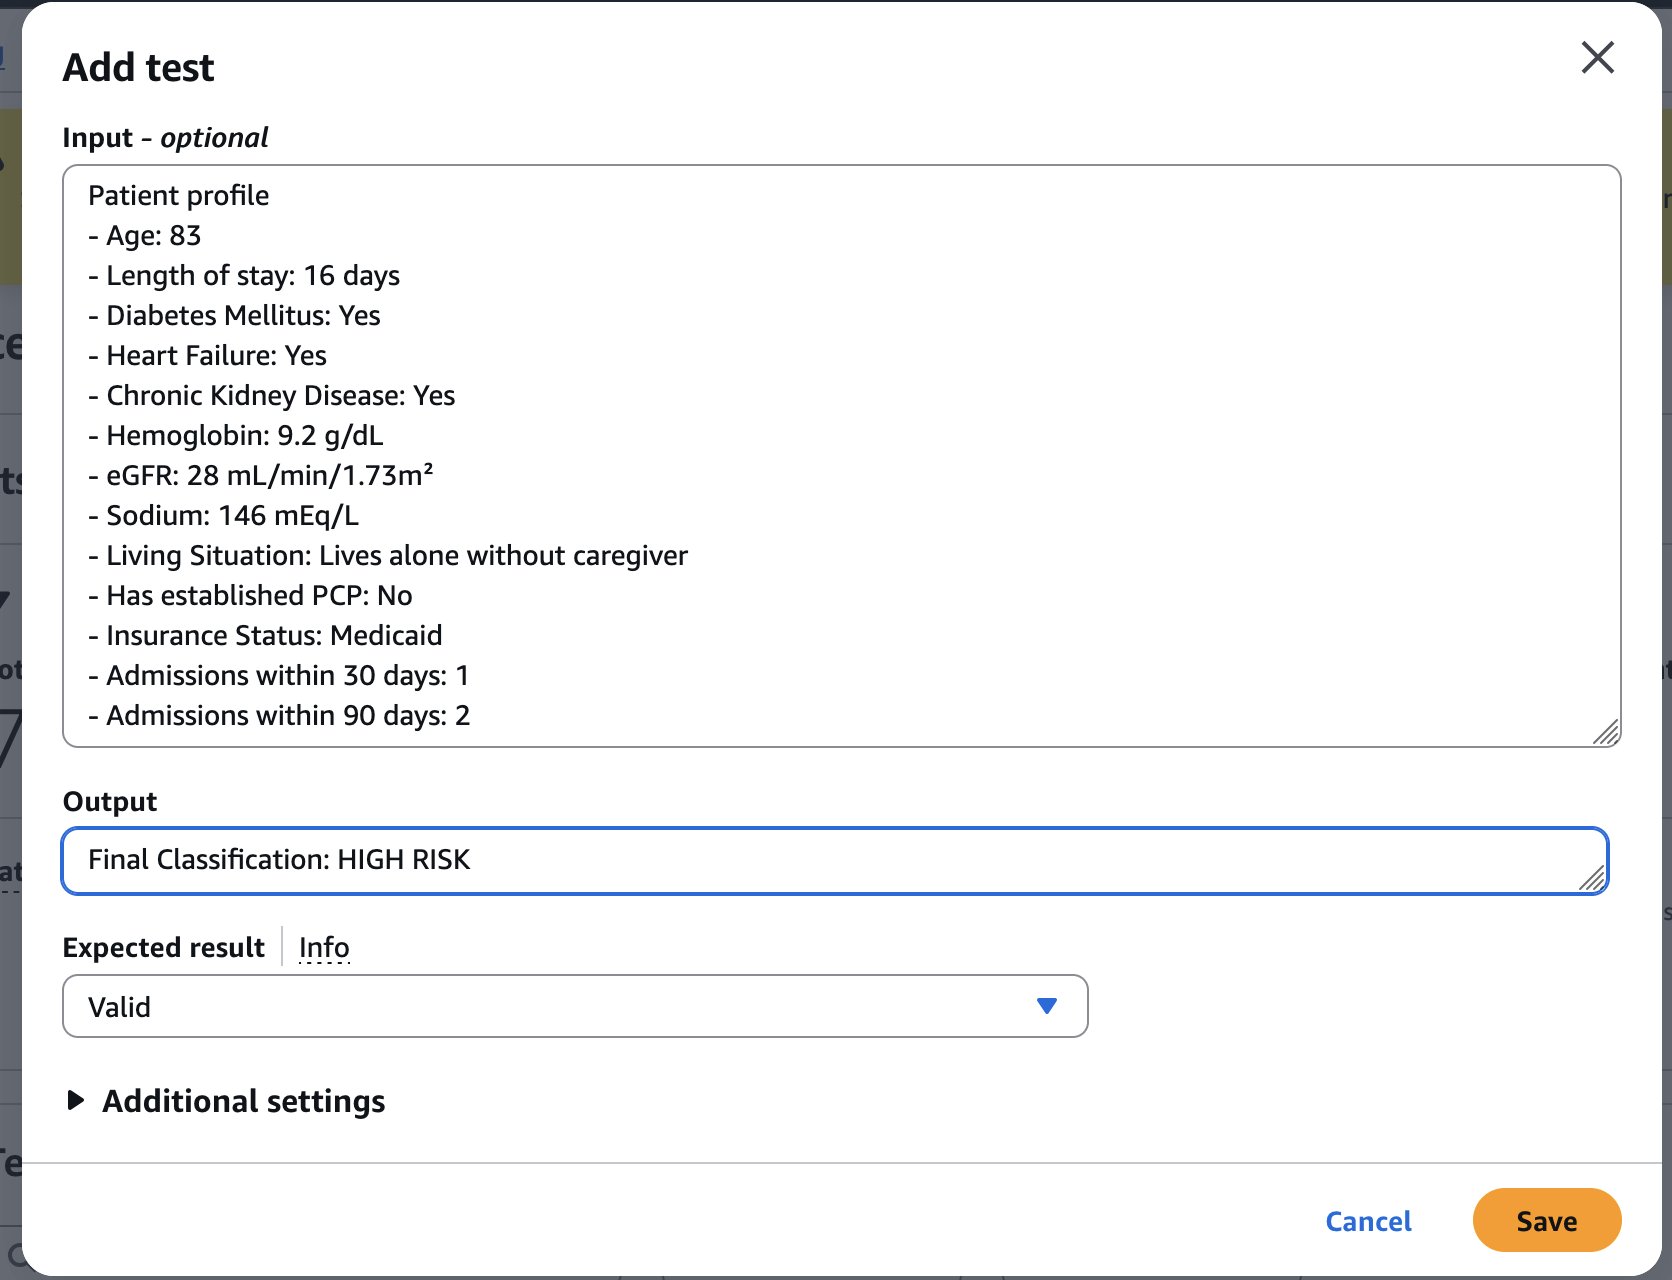
次のスクリーンショットに示すように、テストスイートに別のテストを追加してみましょう。
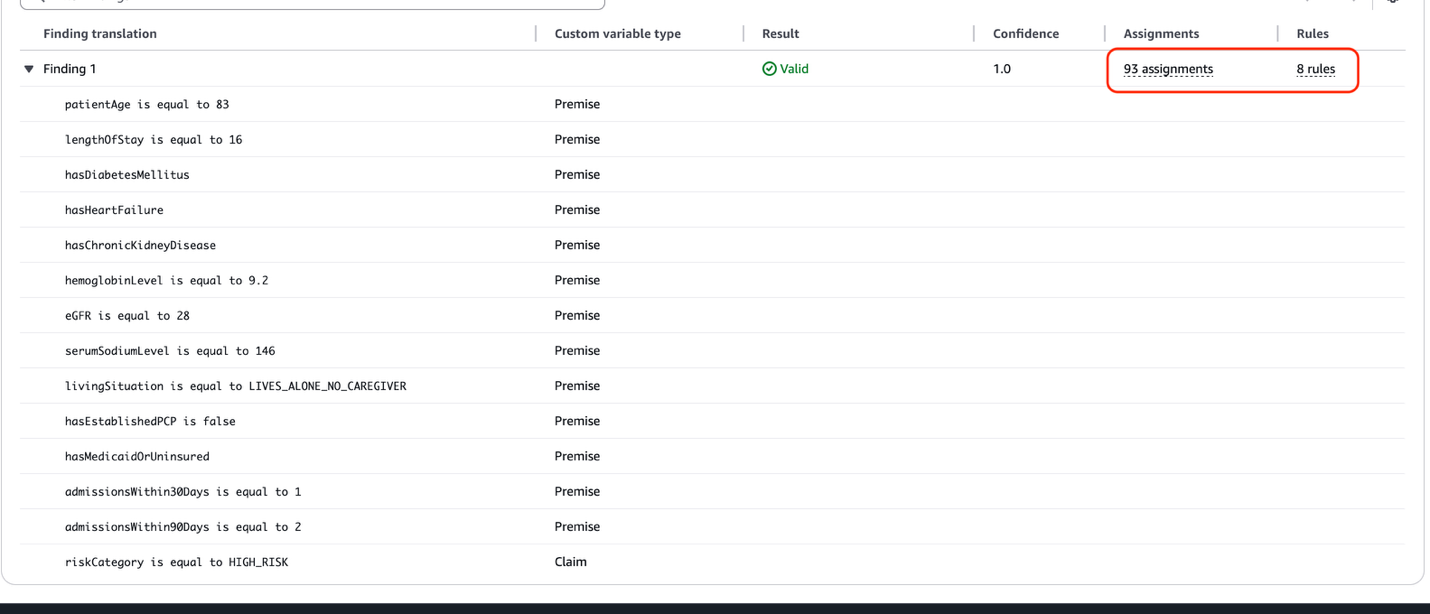
このテストを実行すると、患者の各情報が前提として抽出され、再入院リスクが高いという主張が検証されることがわかります。この主張の検証には 8 個のルールが適用されています。主なルールとその検証内容は次のとおりです。
- 年齢リスク: 患者の年齢が 80 歳以上であればリスクポイント 3 が加算されることを検証
- 在院日数リスク: 在院日数が 14 日を超える場合にリスクポイント 3 が加算されることを確認
- 併存疾患リスク: 糖尿病、心不全、慢性腎臓病の有無に基づいて計算
- 利用状況リスク: 入院歴を評価
- 検査値リスク: ヘモグロビン値 9.2 と eGFR 28 に基づいてリスクを評価
各前提は真と評価され、複数のリスク要因 (高齢、在院日数の長期化、複数の併存疾患、懸念される検査値、介護者なしの独居、かかりつけ医 (PCP) の不在) が存在することから、この HIGH RISK 評価に対する全体としての検証結果が VALID であることが裏付けられました。
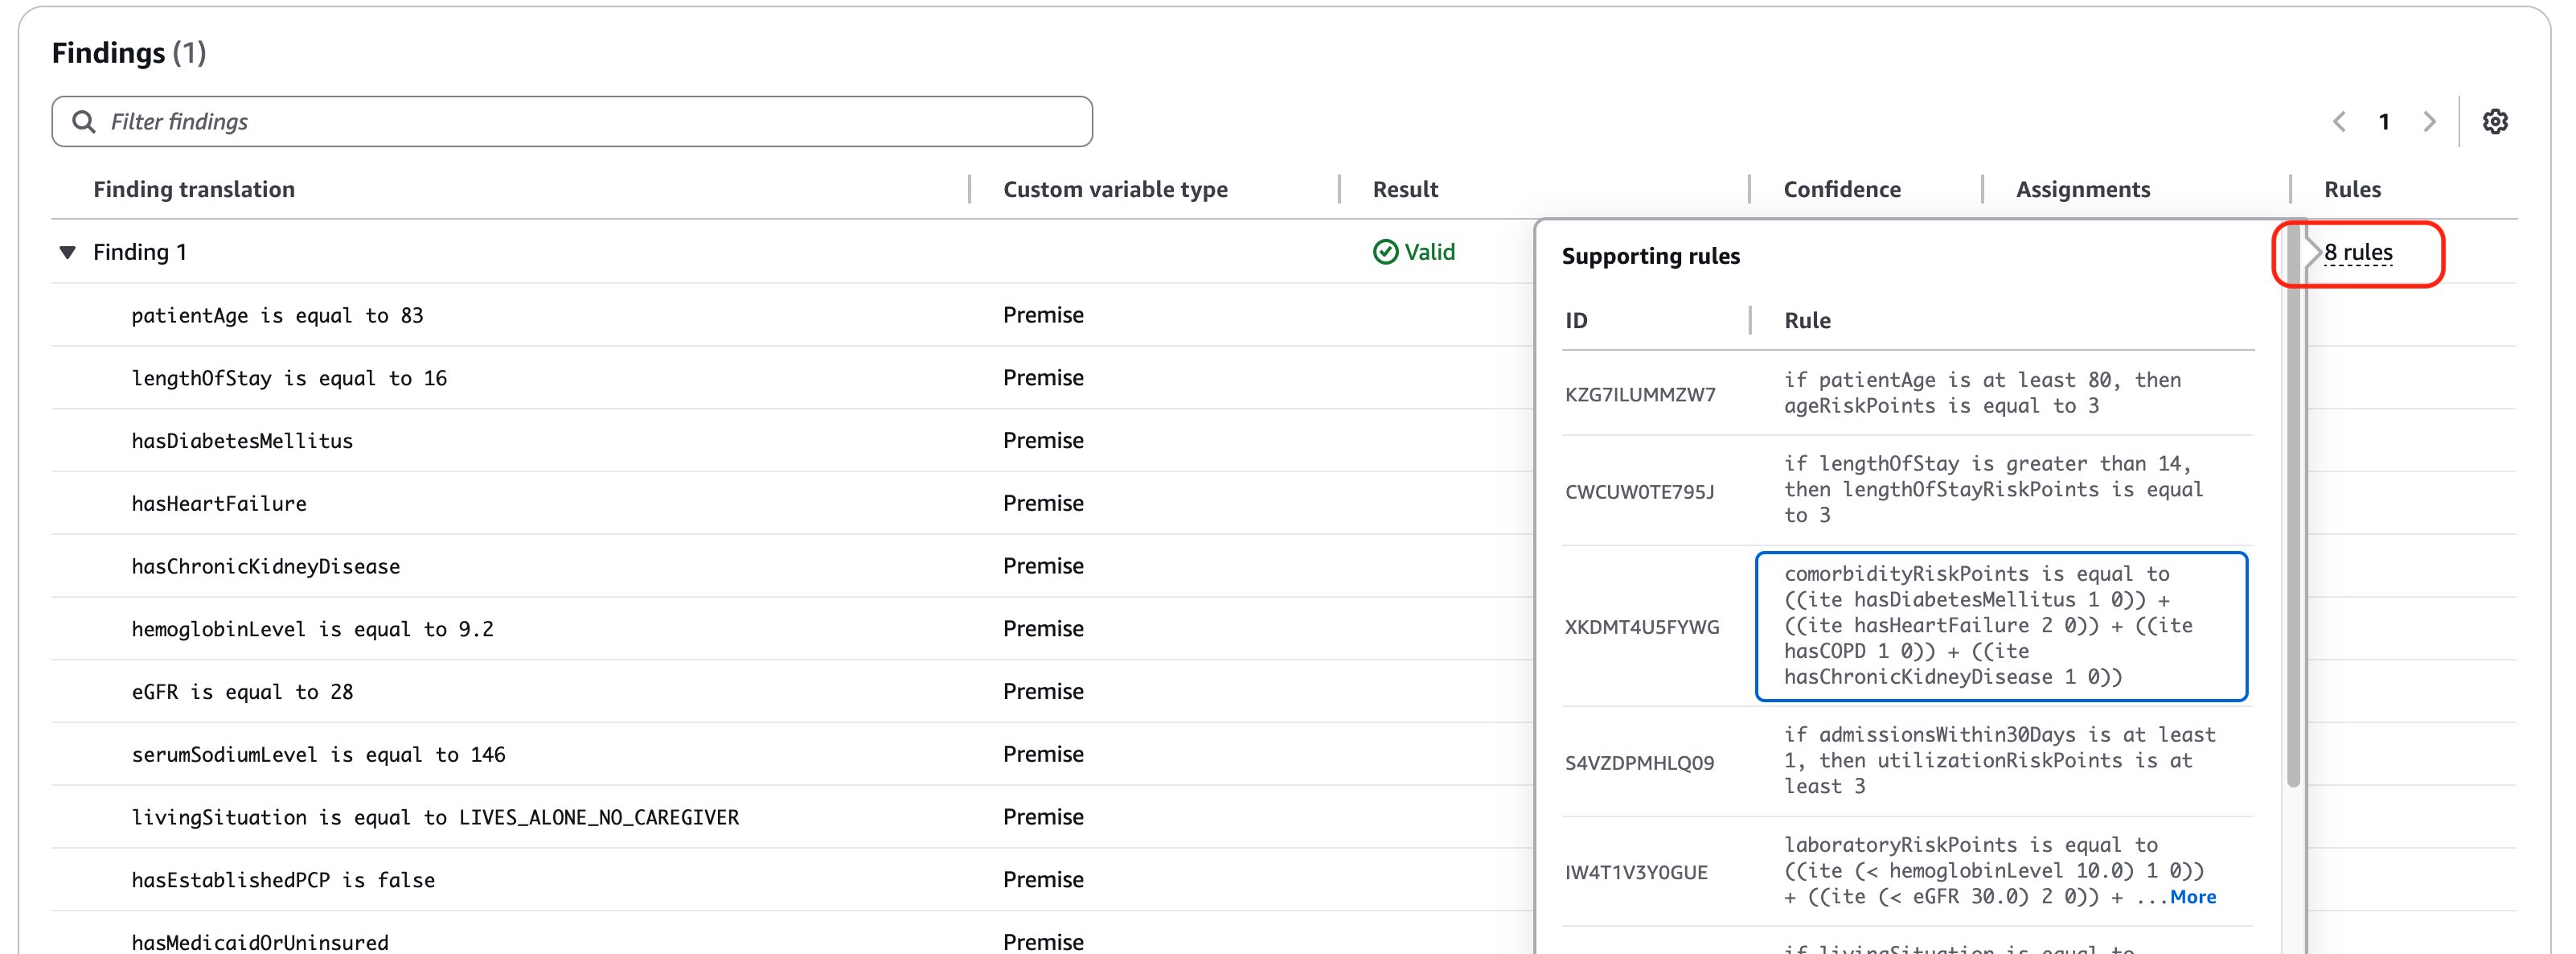
さらに、自動推論エンジンは、HIGH RISK 分類が正しいという結論の健全性を高めるために、93 種類の割り当てを用いてこのテストサンプルを広範に検証しました。自動推論ポリシーの関連ルールを使用して、93 種類のシナリオと変数の組み合わせに対してサンプルを検証します。これにより、この患者の HIGH RISK 分類が無効となり得る状況は存在しないことを確認できます。この徹底した検証プロセスによって、複数の慢性疾患と複雑なケアニーズを有する高齢患者に対するリスク評価の信頼性が裏付けられます。テストサンプルが失敗した場合、93 種類の割り当ては重要な診断ツールとして機能し、期待される結果と矛盾する変数とその相互作用を特定します。その結果、SME は関連するルールとその関係を分析し、臨床ロジックとリスク評価基準のいずれかに調整が必要かどうかを判断できます。次のセクションでは、ポリシーの改善と、SME が注釈を適用して自動推論ポリシーのルール、変数、カスタム型を改善・修正する方法を見ていきます。
注釈によるポリシーの改善
注釈は、テストが期待した結果にならなかった場合に、自動推論ポリシーを改善する強力なメカニズムです。注釈を通じて、SME は次の方法で体系的にポリシーを改善できます。
- ロジックや条件を変更して、問題のあるルールを修正する
- ポリシー定義に不可欠な、不足している変数を追加する
- 変数の説明を更新して、精度と明確さを高める
- 元のポリシーの表現があいまいだったために生じた変換の問題を解決する
- ポリシーから冗長または矛盾する要素を削除する
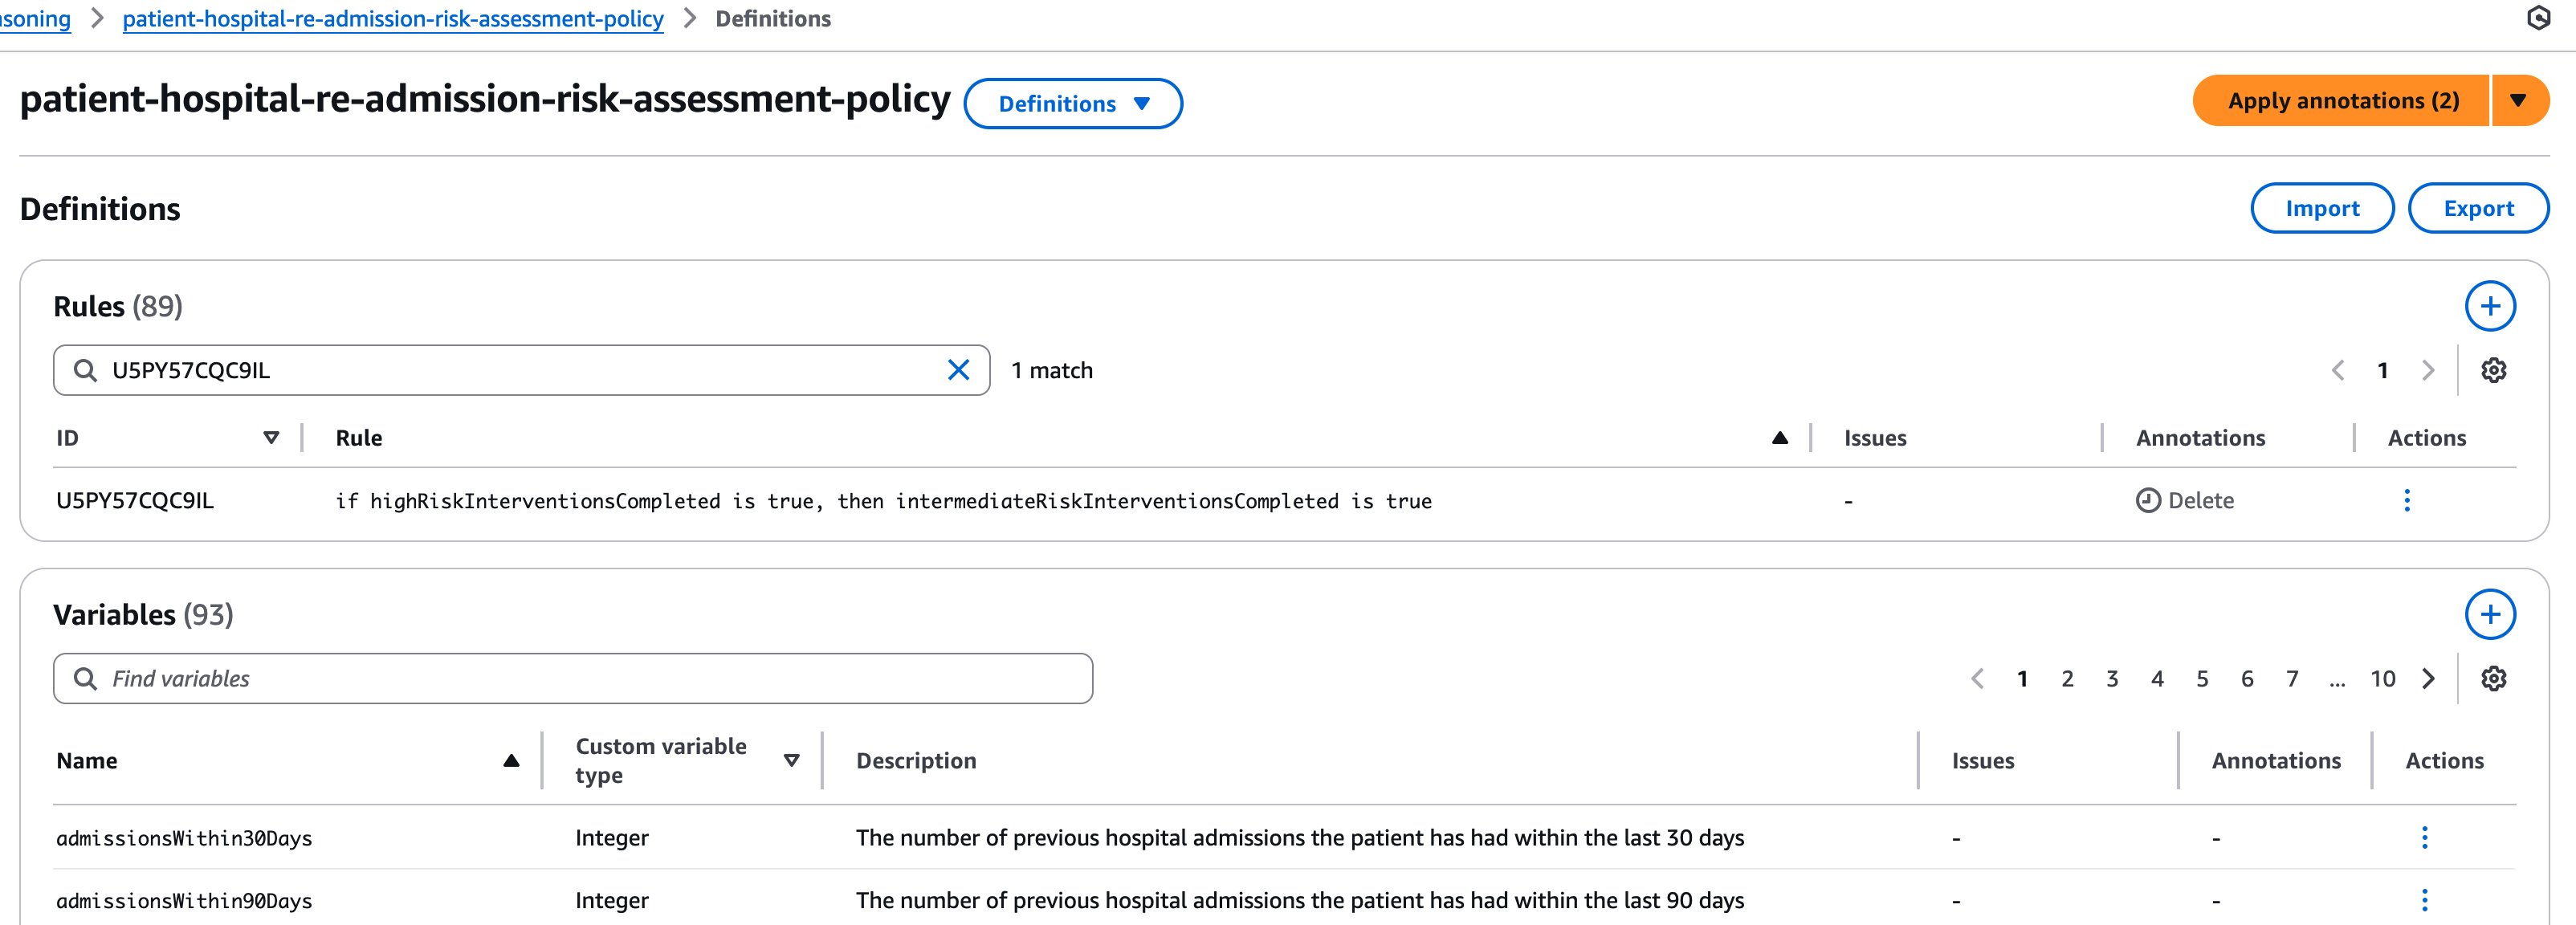
テスト、注釈付け、更新というこの反復的なプロセスによって、ドメインの専門知識を正確にエンコードした、より堅牢なポリシーが構築されます。以下の図に示すように、注釈を適用してさまざまなポリシー要素を変更でき、その後、改善されたポリシーをデプロイ用に JSON ファイルとしてエクスポートできます。
次の図では、注釈が適用され、ポリシー内のルールが削除される様子が確認できます。同様に、ルール、変数、カスタム型に対して追加や更新を行うこともできます。
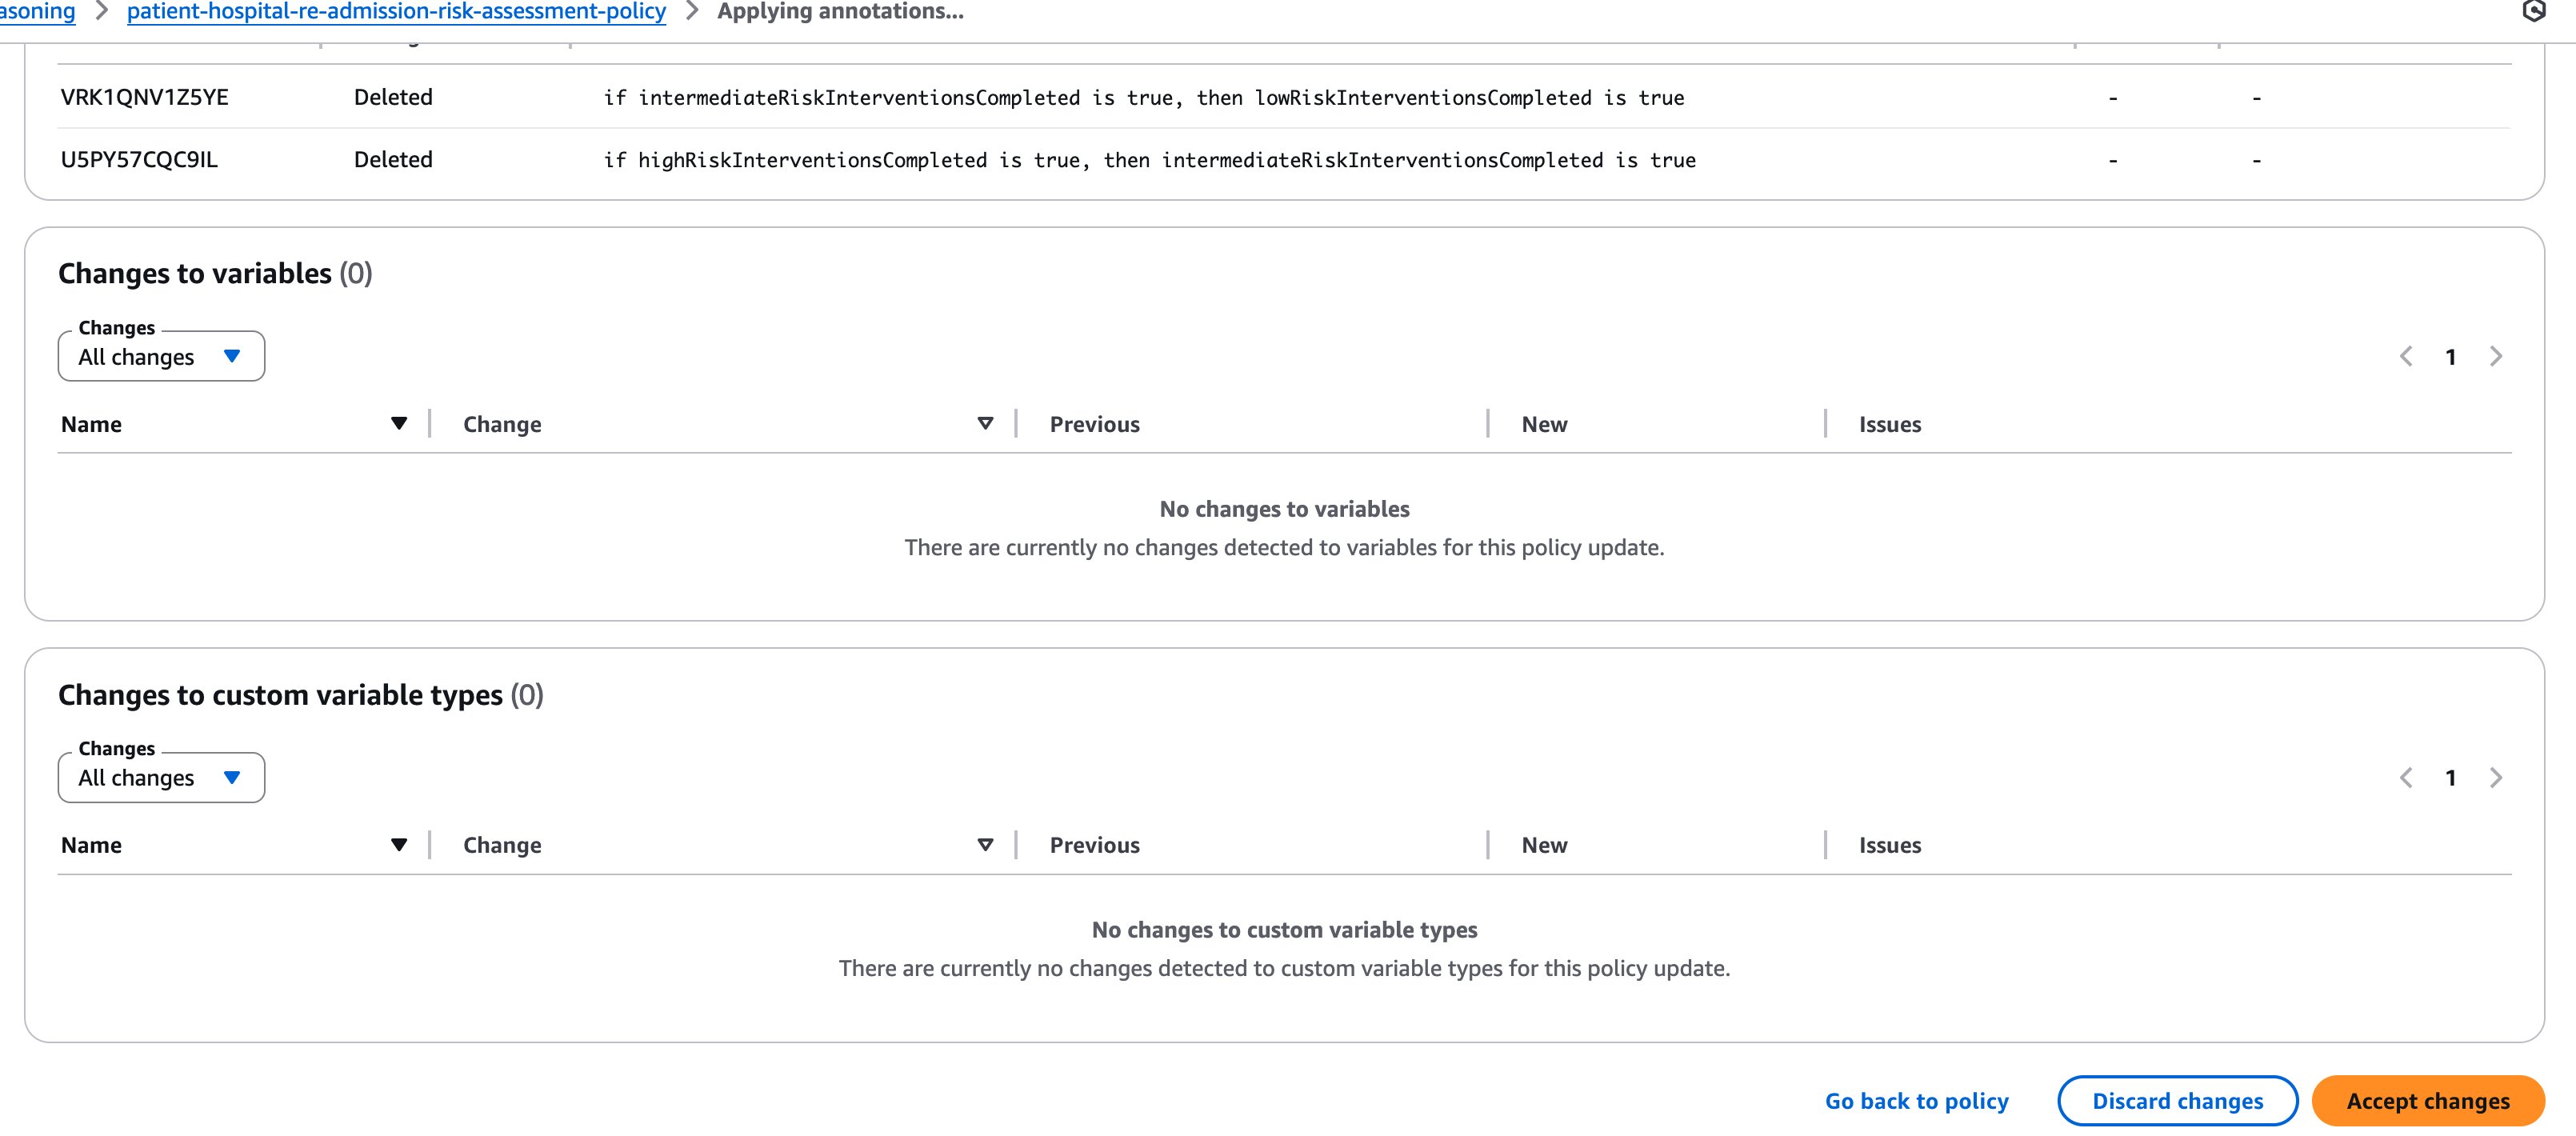
SME がテスト、注釈の適用、ルールの検証を通じて自動推論ポリシーを検証したら、ポリシーを JSON ファイルとしてエクスポートできます。
モデル推論時における自動推論チェックの使用
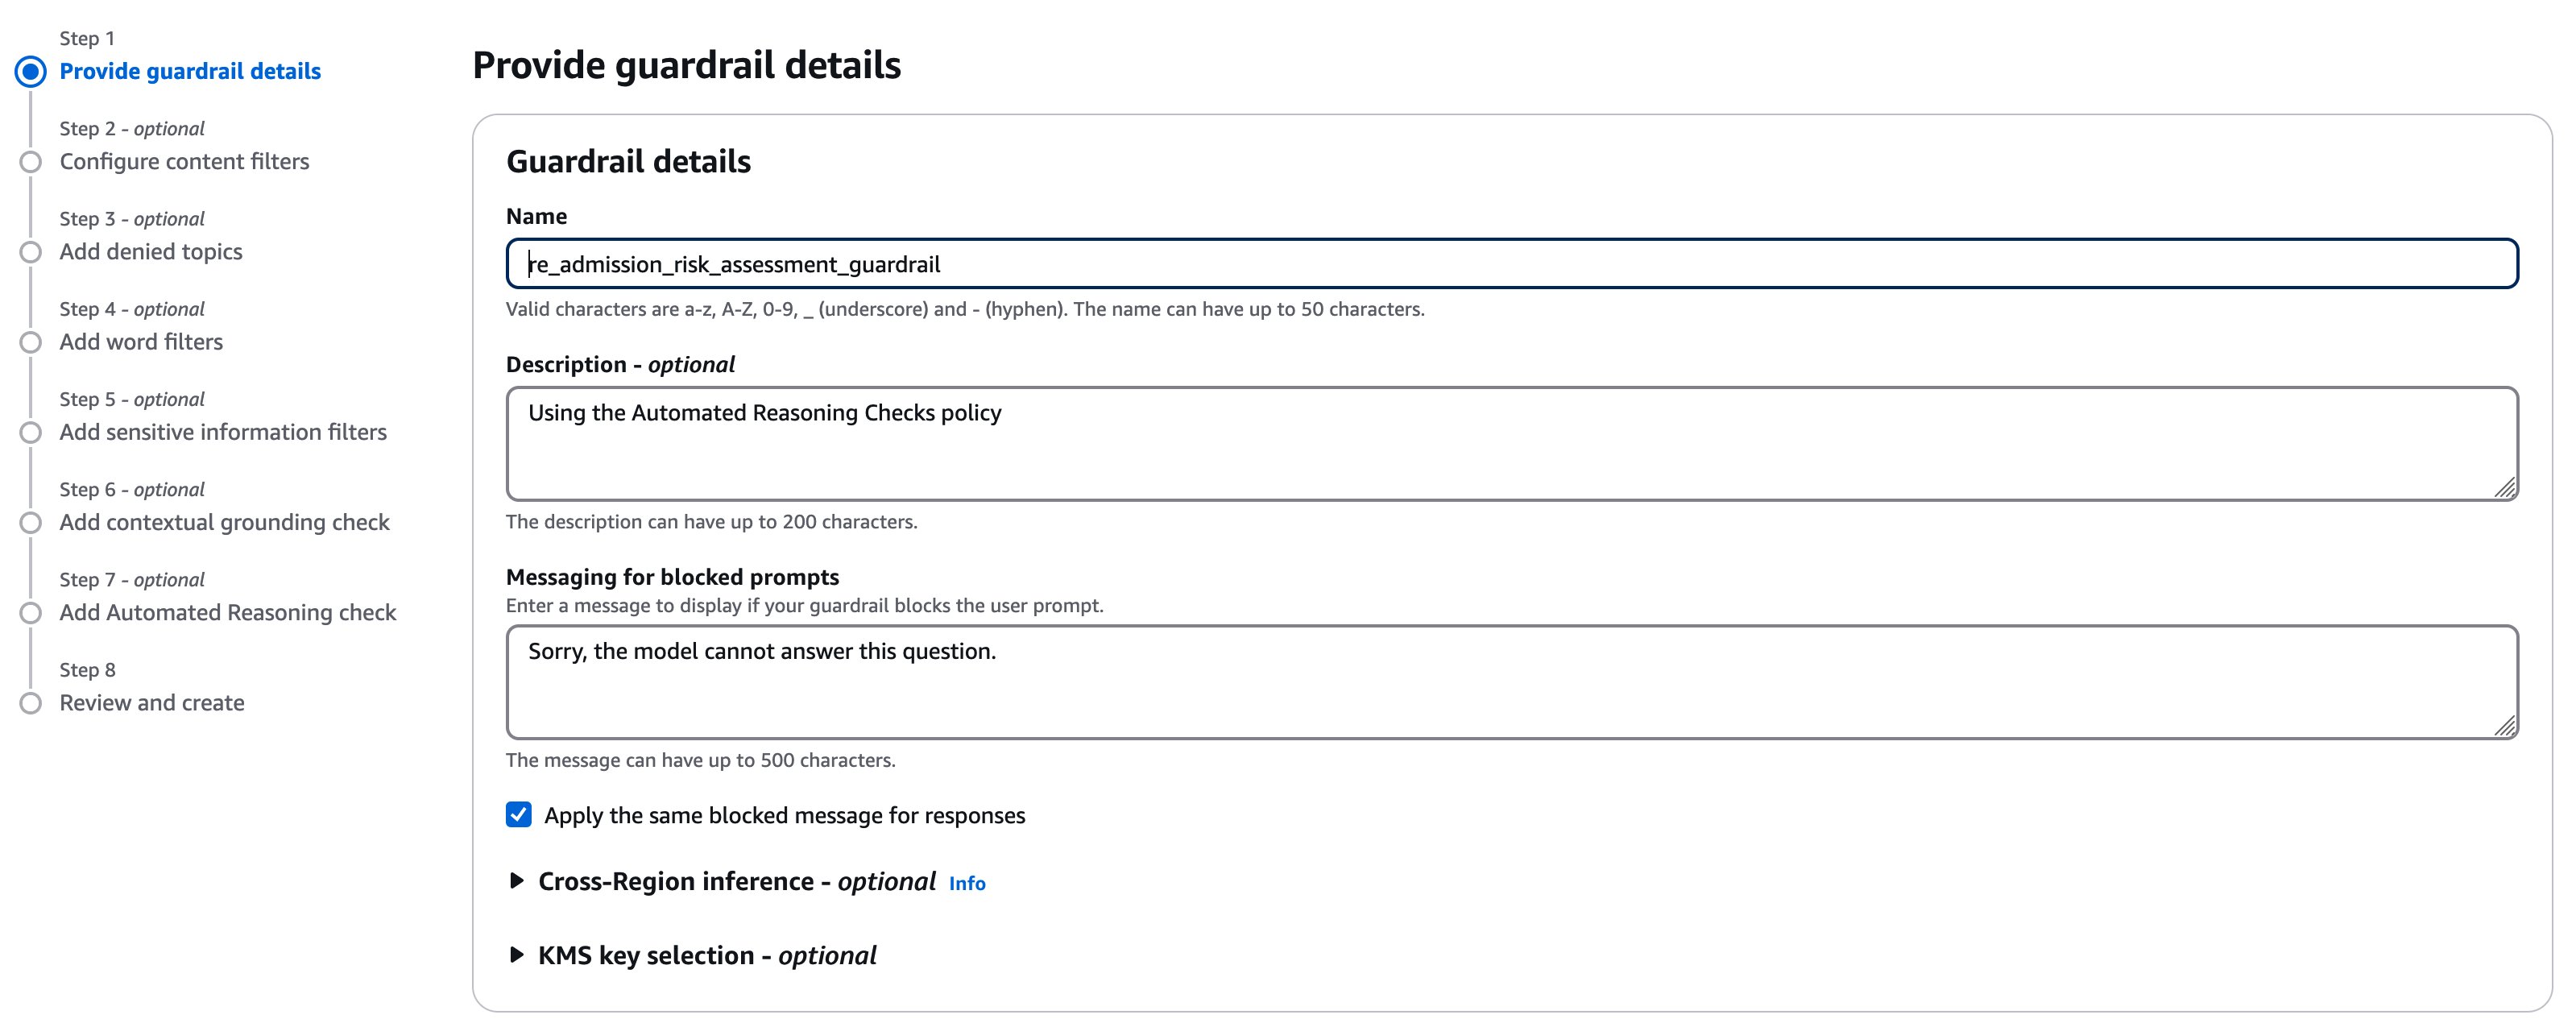
作成したポリシーで自動推論チェックを使用するには、Amazon Bedrock Guardrails に移動し、名前、説明、そしてガードレールが介入して AI システムに対するプロンプトやその出力をブロックしたときに表示するメッセージを入力して、新しいガードレールを作成します。
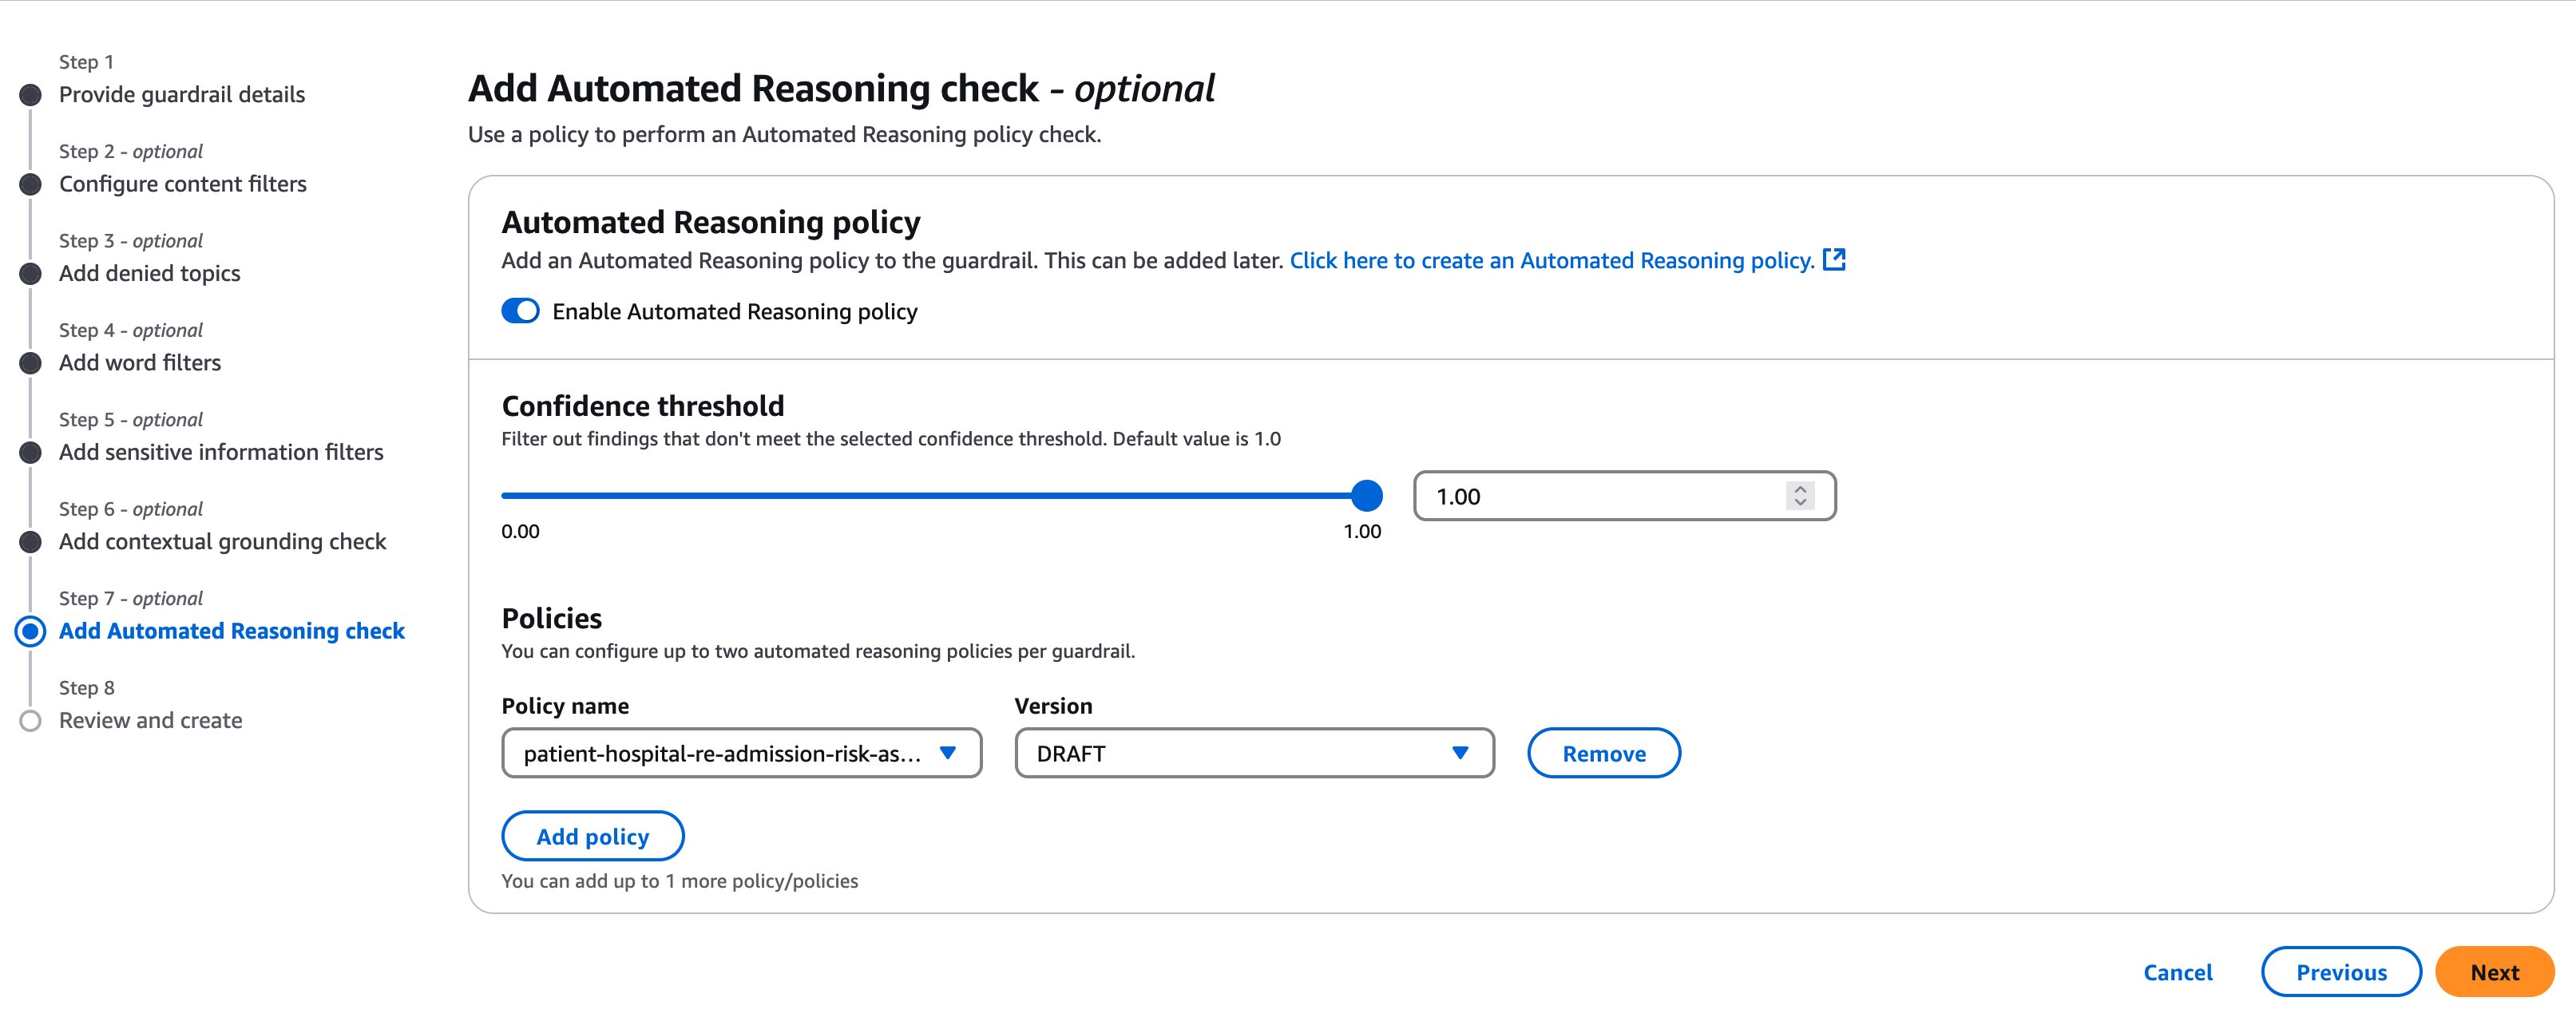
続いて、[自動推論ポリシーを有効化] のトグルをオンにして、自動推論チェックをアタッチします。信頼度しきい値を設定して、ポリシーをどの程度厳格に適用するかを指定できます。しきい値の範囲は 0.00~1.00 で、1.00 がデフォルトかつ最も厳格な設定です。各ガードレールには、検証の柔軟性を高めるために最大 2 つの自動推論ポリシーを設定できます。次の図では、患者の病院再入院リスク評価に関する医療ポリシーのドラフトバージョンをアタッチしています。
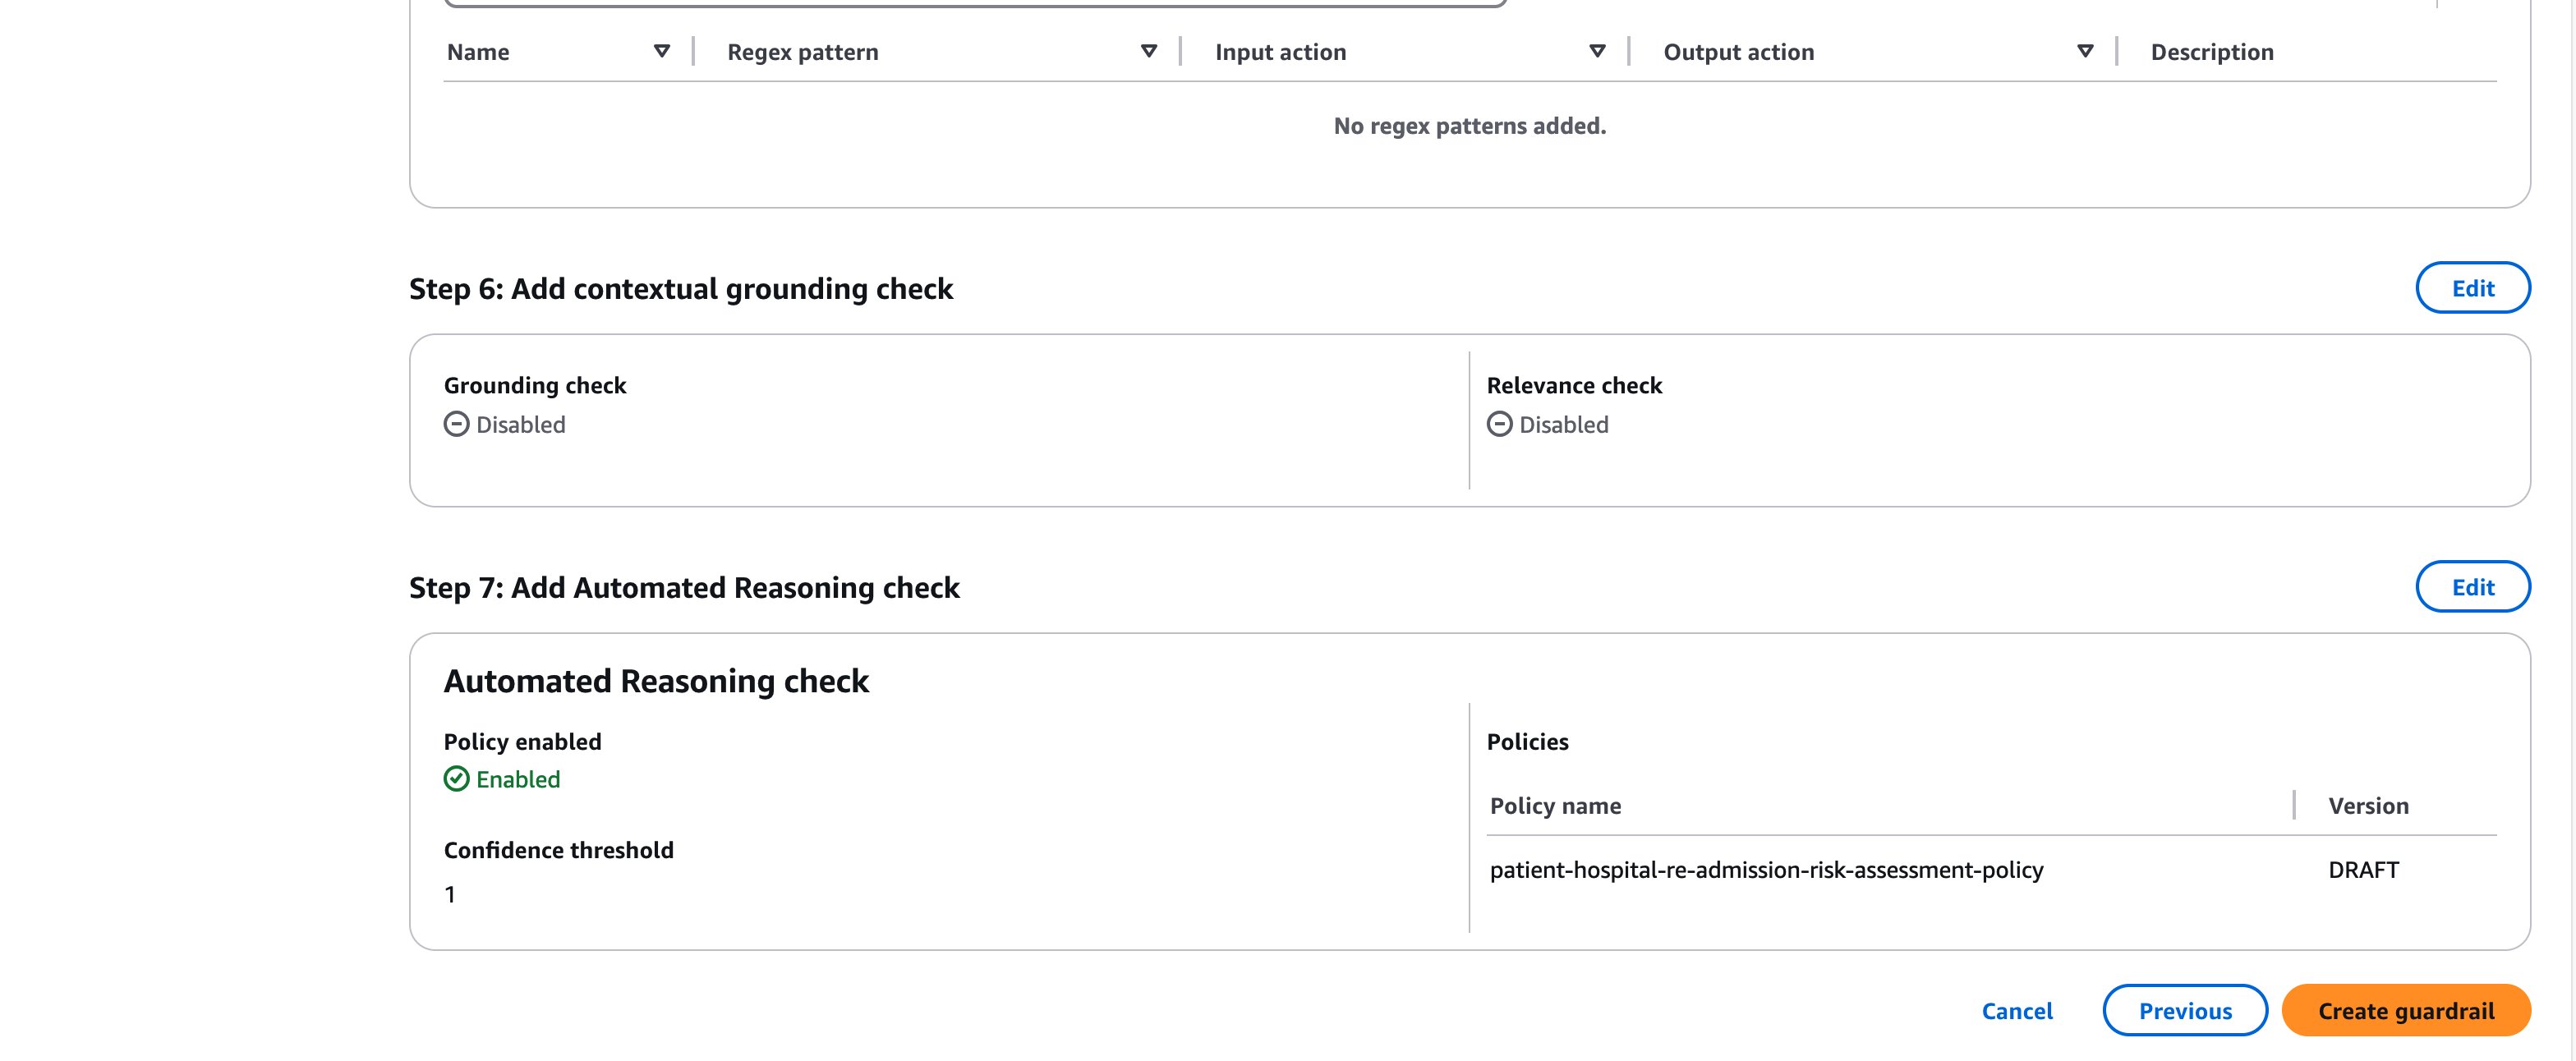
これでガードレールを作成できます。作成が完了して自動推論ポリシーがリンクされたら、ガードレールの詳細ページを開き、すべてのポリシーが正しくアタッチされていることを確認してください。
クリーンアップ
実装が完了したら、作成したガードレールと自動推論ポリシーを削除してリソースをクリーンアップしてください。ガードレールを削除する前に、それを使用しているすべてのリソースやアプリケーションから関連付けを解除してください。
まとめ
2 部構成の第 1 部となる本記事では、Amazon Bedrock Guardrails の自動推論チェックが、数学的検証を通じて生成 AI アプリケーションの信頼性と正確性の維持にどのように役立つかを解説しました。拡張されたドキュメント処理容量、高度な検証メカニズム、包括的なテスト管理機能を活用して、ビジネスルールとドメイン知識に照らして AI 出力を検証できます。このアプローチは、生成 AI システムをデプロイする企業が直面する主要な課題、特に事実の正確さとポリシー準拠が不可欠な規制産業における課題に対応します。病院再入院リスク評価のデモンストレーションが示すように、この技術は複雑な意思決定プロセスの検証を支援し、生成 AI を重要なビジネス環境に適したシステムへと変えるのに役立ちます。これらの機能は AWS マネジメントコンソールと API のどちらからでも利用でき、AI アプリケーションの品質管理プロセスを確立できます。
さらに詳しく学び、セキュアで安全な AI アプリケーションを構築するには、技術ドキュメントと GitHub のコードサンプルを参照するか、Amazon Bedrock コンソールにアクセスしてください。
著者について
 Adewale Akinfaderin は Amazon Bedrock の Sr. Data Scientist–Generative AI で、AWS における基盤モデルと生成 AI アプリケーションの最先端のイノベーションに貢献しています。専門は再現可能でエンドツーエンドの AI/ML 手法と実践的な実装であり、世界中のお客様が学際的な課題に対してスケーラブルなソリューションを構想し開発できるよう支援しています。物理学で 2 つの大学院学位を、工学で博士号を取得しています。
 Bharathi Srinivasan は AWS Worldwide Specialist Organization の Generative AI Data Scientist です。アルゴリズムの公平性、大規模言語モデルの真実性、説明可能性に焦点を当て、責任ある AI のためのソリューション開発に取り組んでいます。社内チームと AWS のお客様の責任ある AI への取り組みも支援しており、さまざまな機械学習カンファレンスで自身の成果を発表しています。
 Nafi Diallo は Amazon Web Services の Senior Automated Reasoning Architect で、生成 AI アプリケーションのための AI 安全性と自動推論システムのイノベーションを推進しています。専門は形式的検証の手法と AI ガードレールの実装であり、世界中のお客様が信頼できるコンプライアンス対応の AI ソリューションを大規模に構築できるよう支援しています。自動プログラム修復と形式的検証を研究テーマとするコンピュータサイエンスの博士号と、WPI (Worcester Polytechnic Institute) の金融数学の修士号を取得しています。
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。